Inkling 2 Mini 开源了:26.4B 参数塞进 16GB 显存,本地跑编程 Agent 够不够用?
11 月 20 日,Mira Murati 的 Thinking Machines Lab 放出了新开源模型 Inkling 2 Mini。上线 24 小时,Hugging Face 上的下载量就超过了 23 万次——这个数字是发布方自己报的,热度确实不低。 先说最抓人的一点:它总参数 26.4B,
11 月 20 日,Mira Murati 的 Thinking Machines Lab 放出了新开源模型 Inkling 2 Mini。上线 24 小时,Hugging Face 上的下载量就超过了 23 万次——这个数字是发布方自己报的,热度确实不低。 先说最抓人的一点:它总参数 26.4B,
刷短视频的时候,这种视频估计你也刷到过:一张静态照片里的人突然开口唱歌,嘴型对得上,表情还跟着音乐走,看着跟真唱似的。 做法其实没多神秘,就三样东西:一张人像照片、一首歌,再加一个能在本地跑的工具。不用剪辑基础,也不用把照片和音乐传到哪个网站上,在自己电脑上就能做出来。 先看效果,下面这段 31 秒
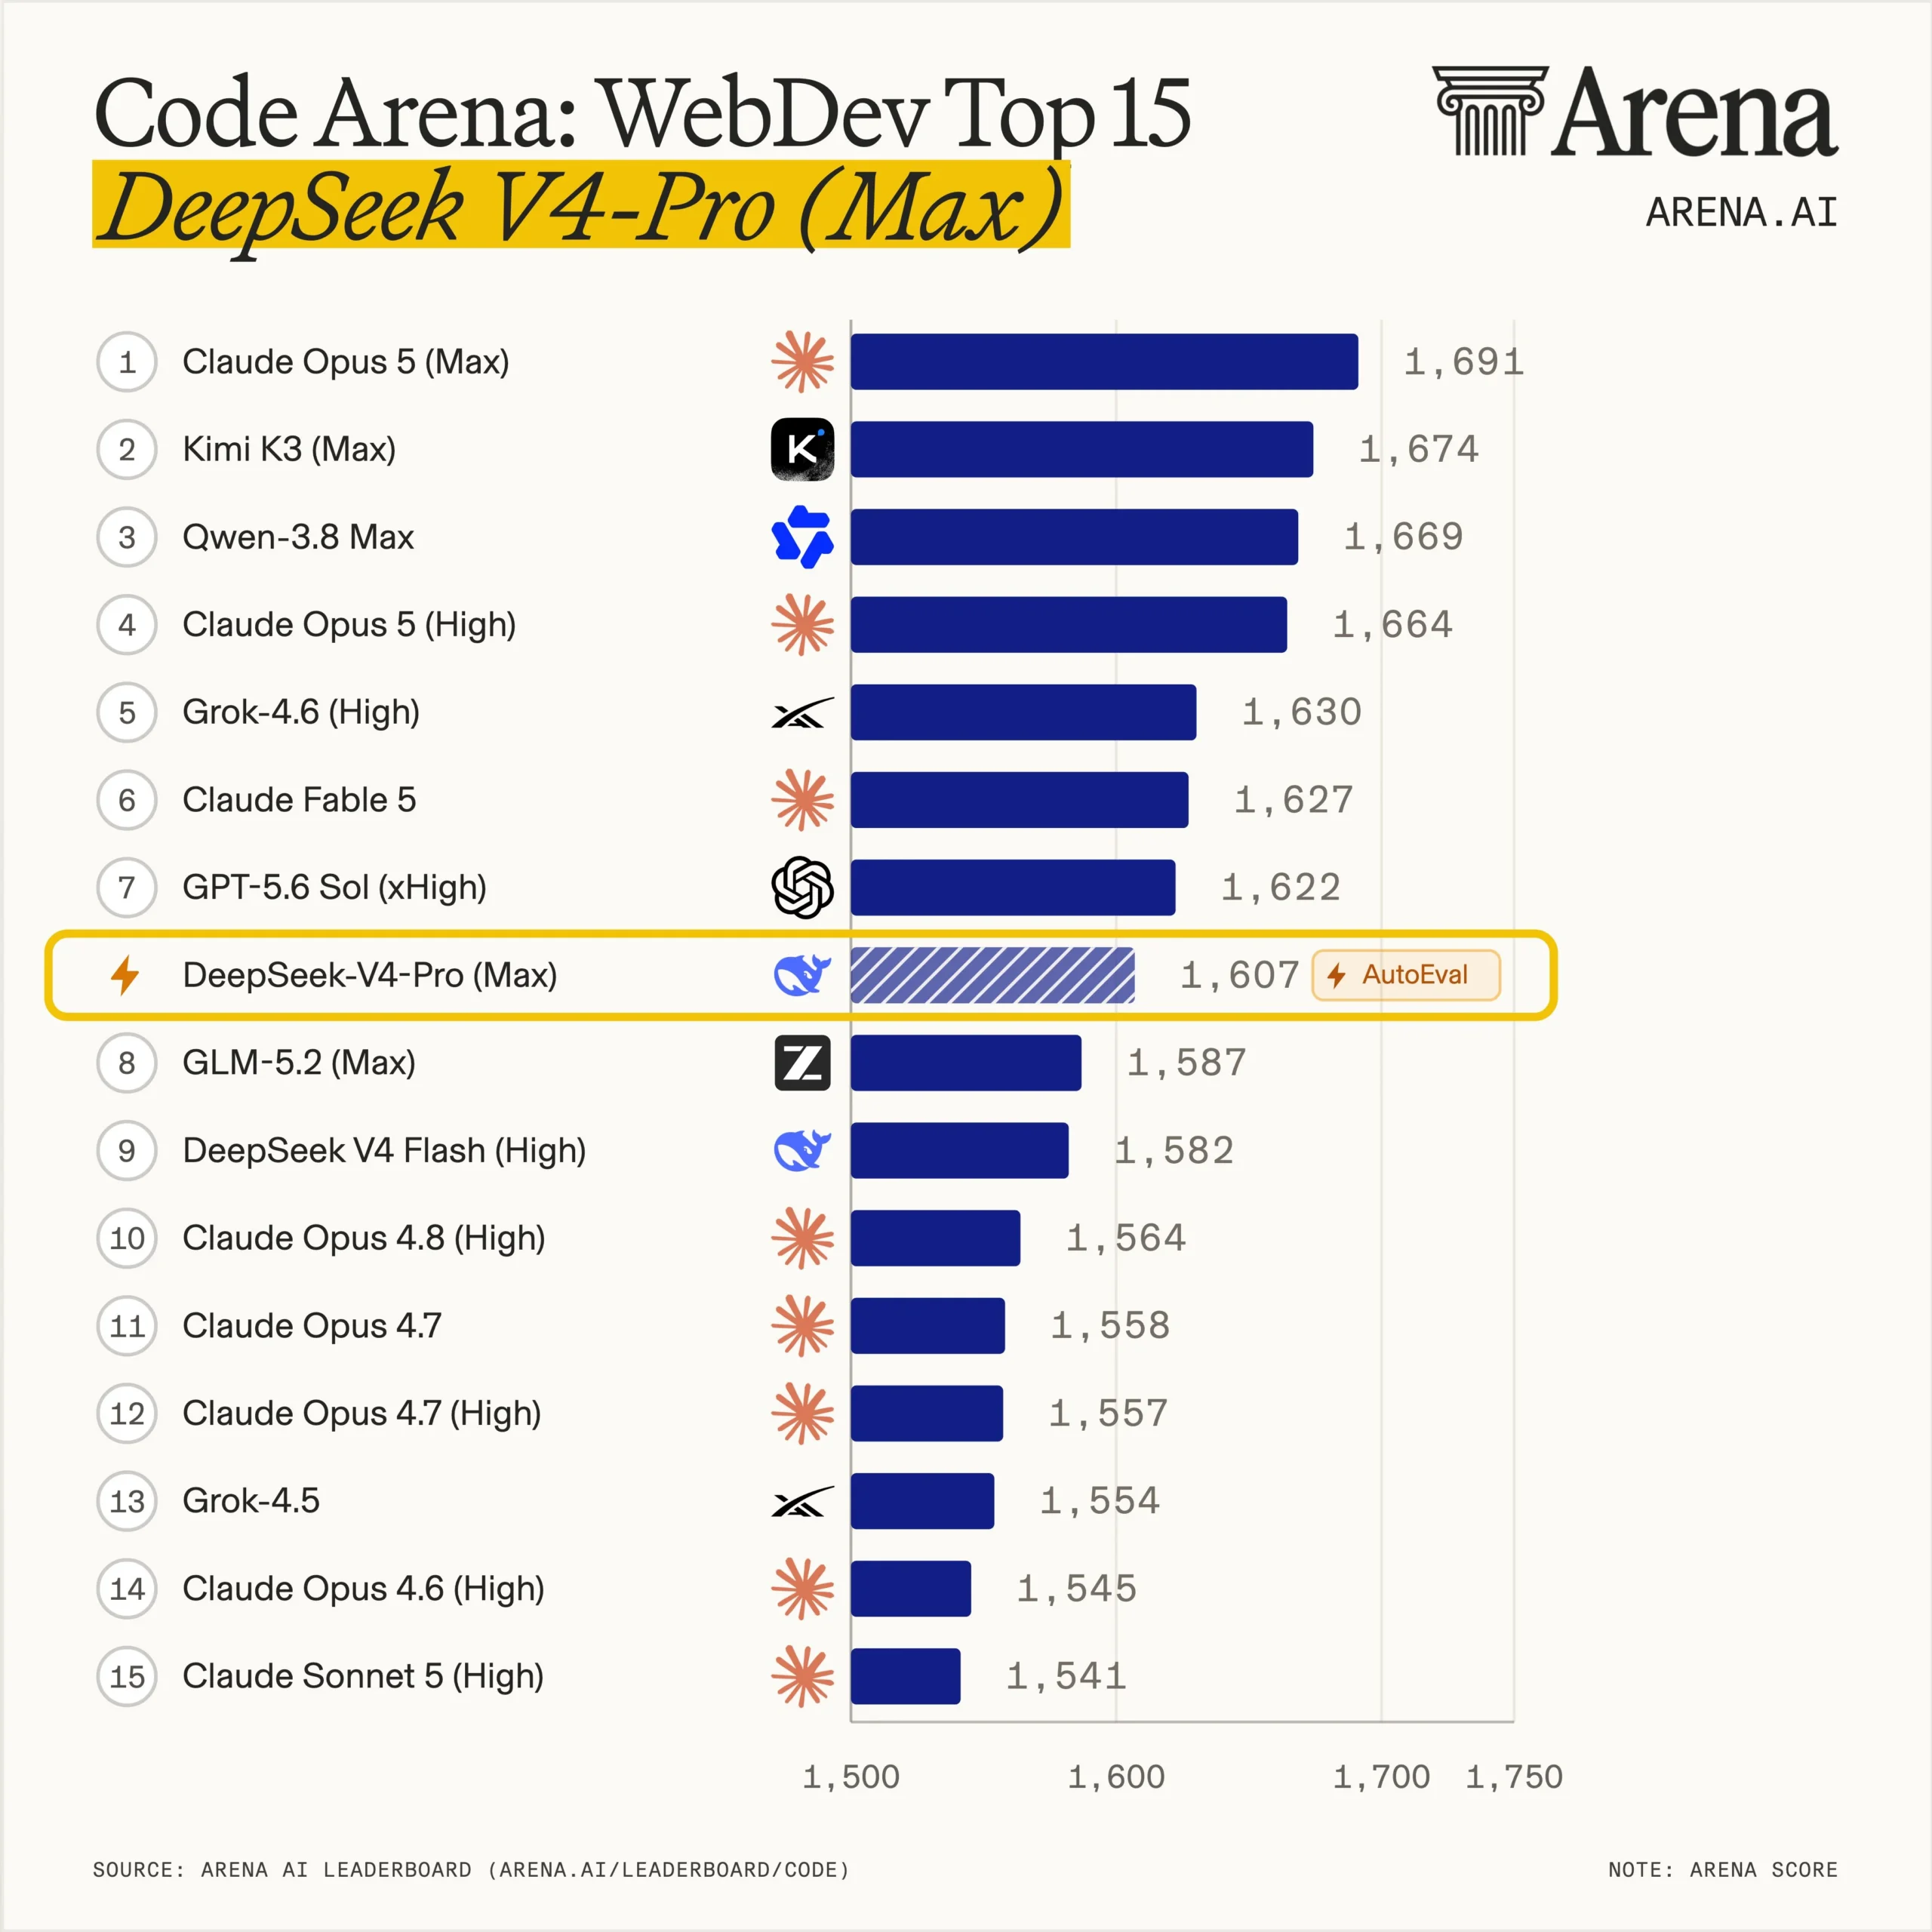
DeepSeek-V4-Pro 这两天在榜单上很显眼。Code Arena 的 WebDev 前 15 里,它排在第 8 左右,1607 分,前面是 Claude Opus 5、Kimi K3、Qwen-3.8 Max 这些大家伙。开源社区的动作也很快:有人把它的推理能力蒸馏到了 Qwen3.5 的
MiniMax 前两天又开源了一个新模型,这次是做图的:MiniMax-H3-Image。 我先说它最打动我的两点。第一,按官方介绍,它能原生直出 1600 万像素的图片——注意是原生直出,不是先生成一张小图、再靠超分放大,所以画面细节和纹理保留得更好。第二,文生图和图片编辑做到同一个模型里了,一次
大多数人做 AI 剧集,最后都落得一个下场:一支很惊艳的短片,外加一个同名同姓的陌生人。 他们先渲染,后导演。还没看到草稿,就先花钱上了 1080p。每个提示词都凭记忆重新描述一遍角色,然后纳闷脸怎么又变了。 这是一套 13 步的课程,能把这团乱麻变成一间每天出一集的工作室。 视频模型没有记忆。所以
今天 AI 圈一天之内来了两个重磅:通义千问 4(Qwen4)正式发布,Claude 最新旗舰 Fable 5.2 也登场了。两边撞在同一天,讨论很快就变成了一个问题:到底谁更能打? 先把我的判断放在前面:这场对决的看点已经不是谁跑分高,而是谁能把一个完整项目从头做到尾。下面这些案例都来自发布方和社
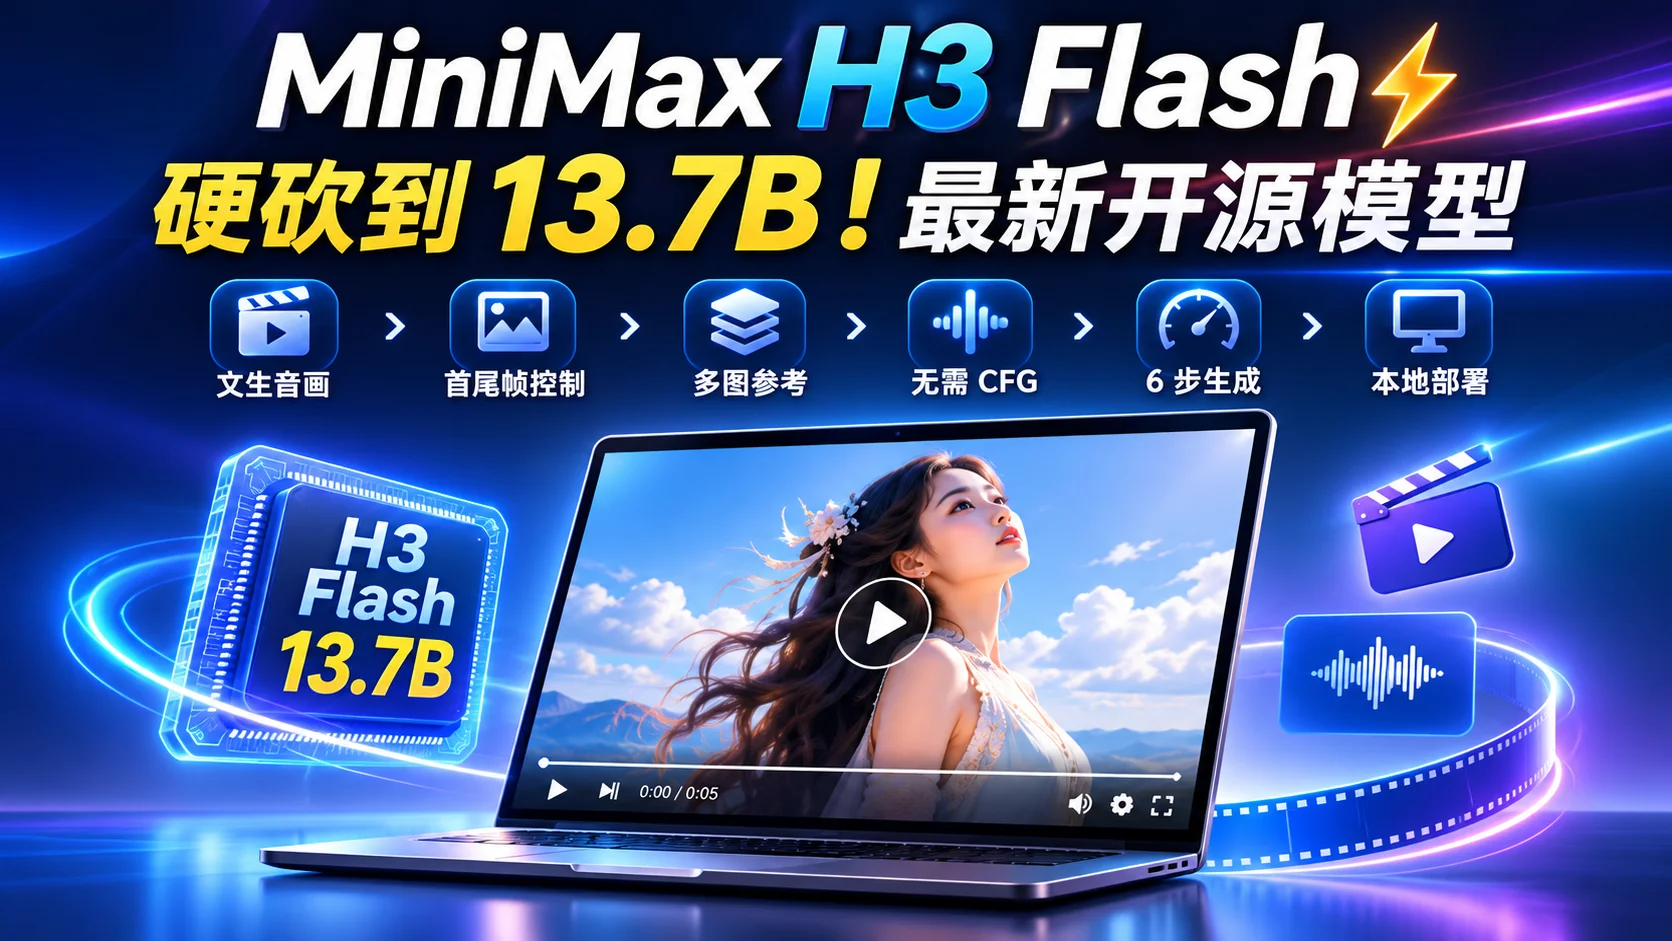
开源视频生成圈最近又出了个狠活:有人把 31B 参数的 MiniMax H3,硬生生砍到了 13.7B,还能本地跑。 做这件事的是 Video Rebirth 团队,项目叫 HyperFlow H3 Flash。关键不在于“变小了”本身,而在于它不是简单套一层加速 LoRA,而是直接对底层模型结构动
开源圈最近又出了一个自带话题的模型:Arete-27B。 它不是从零训出来的新底座,而是拿 Qwen3.8-27B 再做了一轮后训练。特别的地方不在参数规模,而在训练目标——发布方 Nous Research 直言,这次后训练就是为了强化模型在价值观、伦理判断和社会议题上的回答倾向,而且是往西方价值
Moonshot AI 最近放了个大招:Kimi K3.1 Pro 正式发布并开源,总参数规模 3 万亿(3T),权重已经可以在 Hugging Face 上下载。任何人都能把它拿到自己的机器或服务器上部署。 参数规模一出,第一个问题就来了:这么大的模型,普通人的电脑到底能不能跑?答案是能跑,但方式
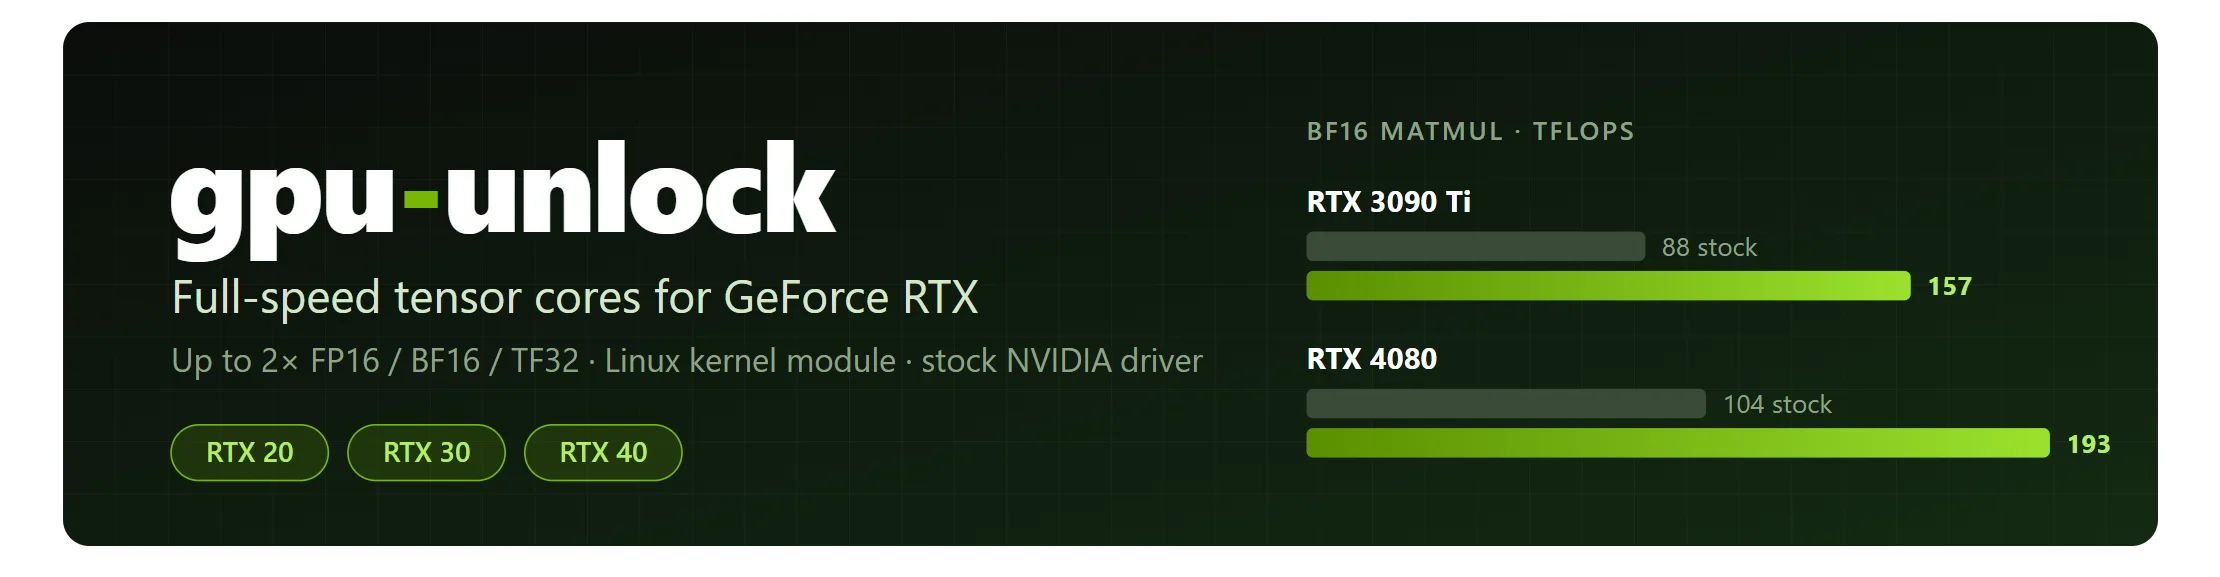
本地跑大模型卡,不一定是模型选大了。有时候瓶颈在显卡本身:同一张卡,某些算力路径并没有被完全放开,跑起来就显得比纸面参数慢。 最近有个开源项目 GPU-UNLOCK,打的就是这个点子:通过调整驱动或内核层面的限制,把一部分被压住的算力释放出来,让本地推理跑得更快。它不是换硬件,也不是给模型换个壳,效