DeepSeek-V4-Pro 被蒸馏进 4B/9B 小模型:拒答率从 99% 掉到 5%,轻薄本真能跑吗?
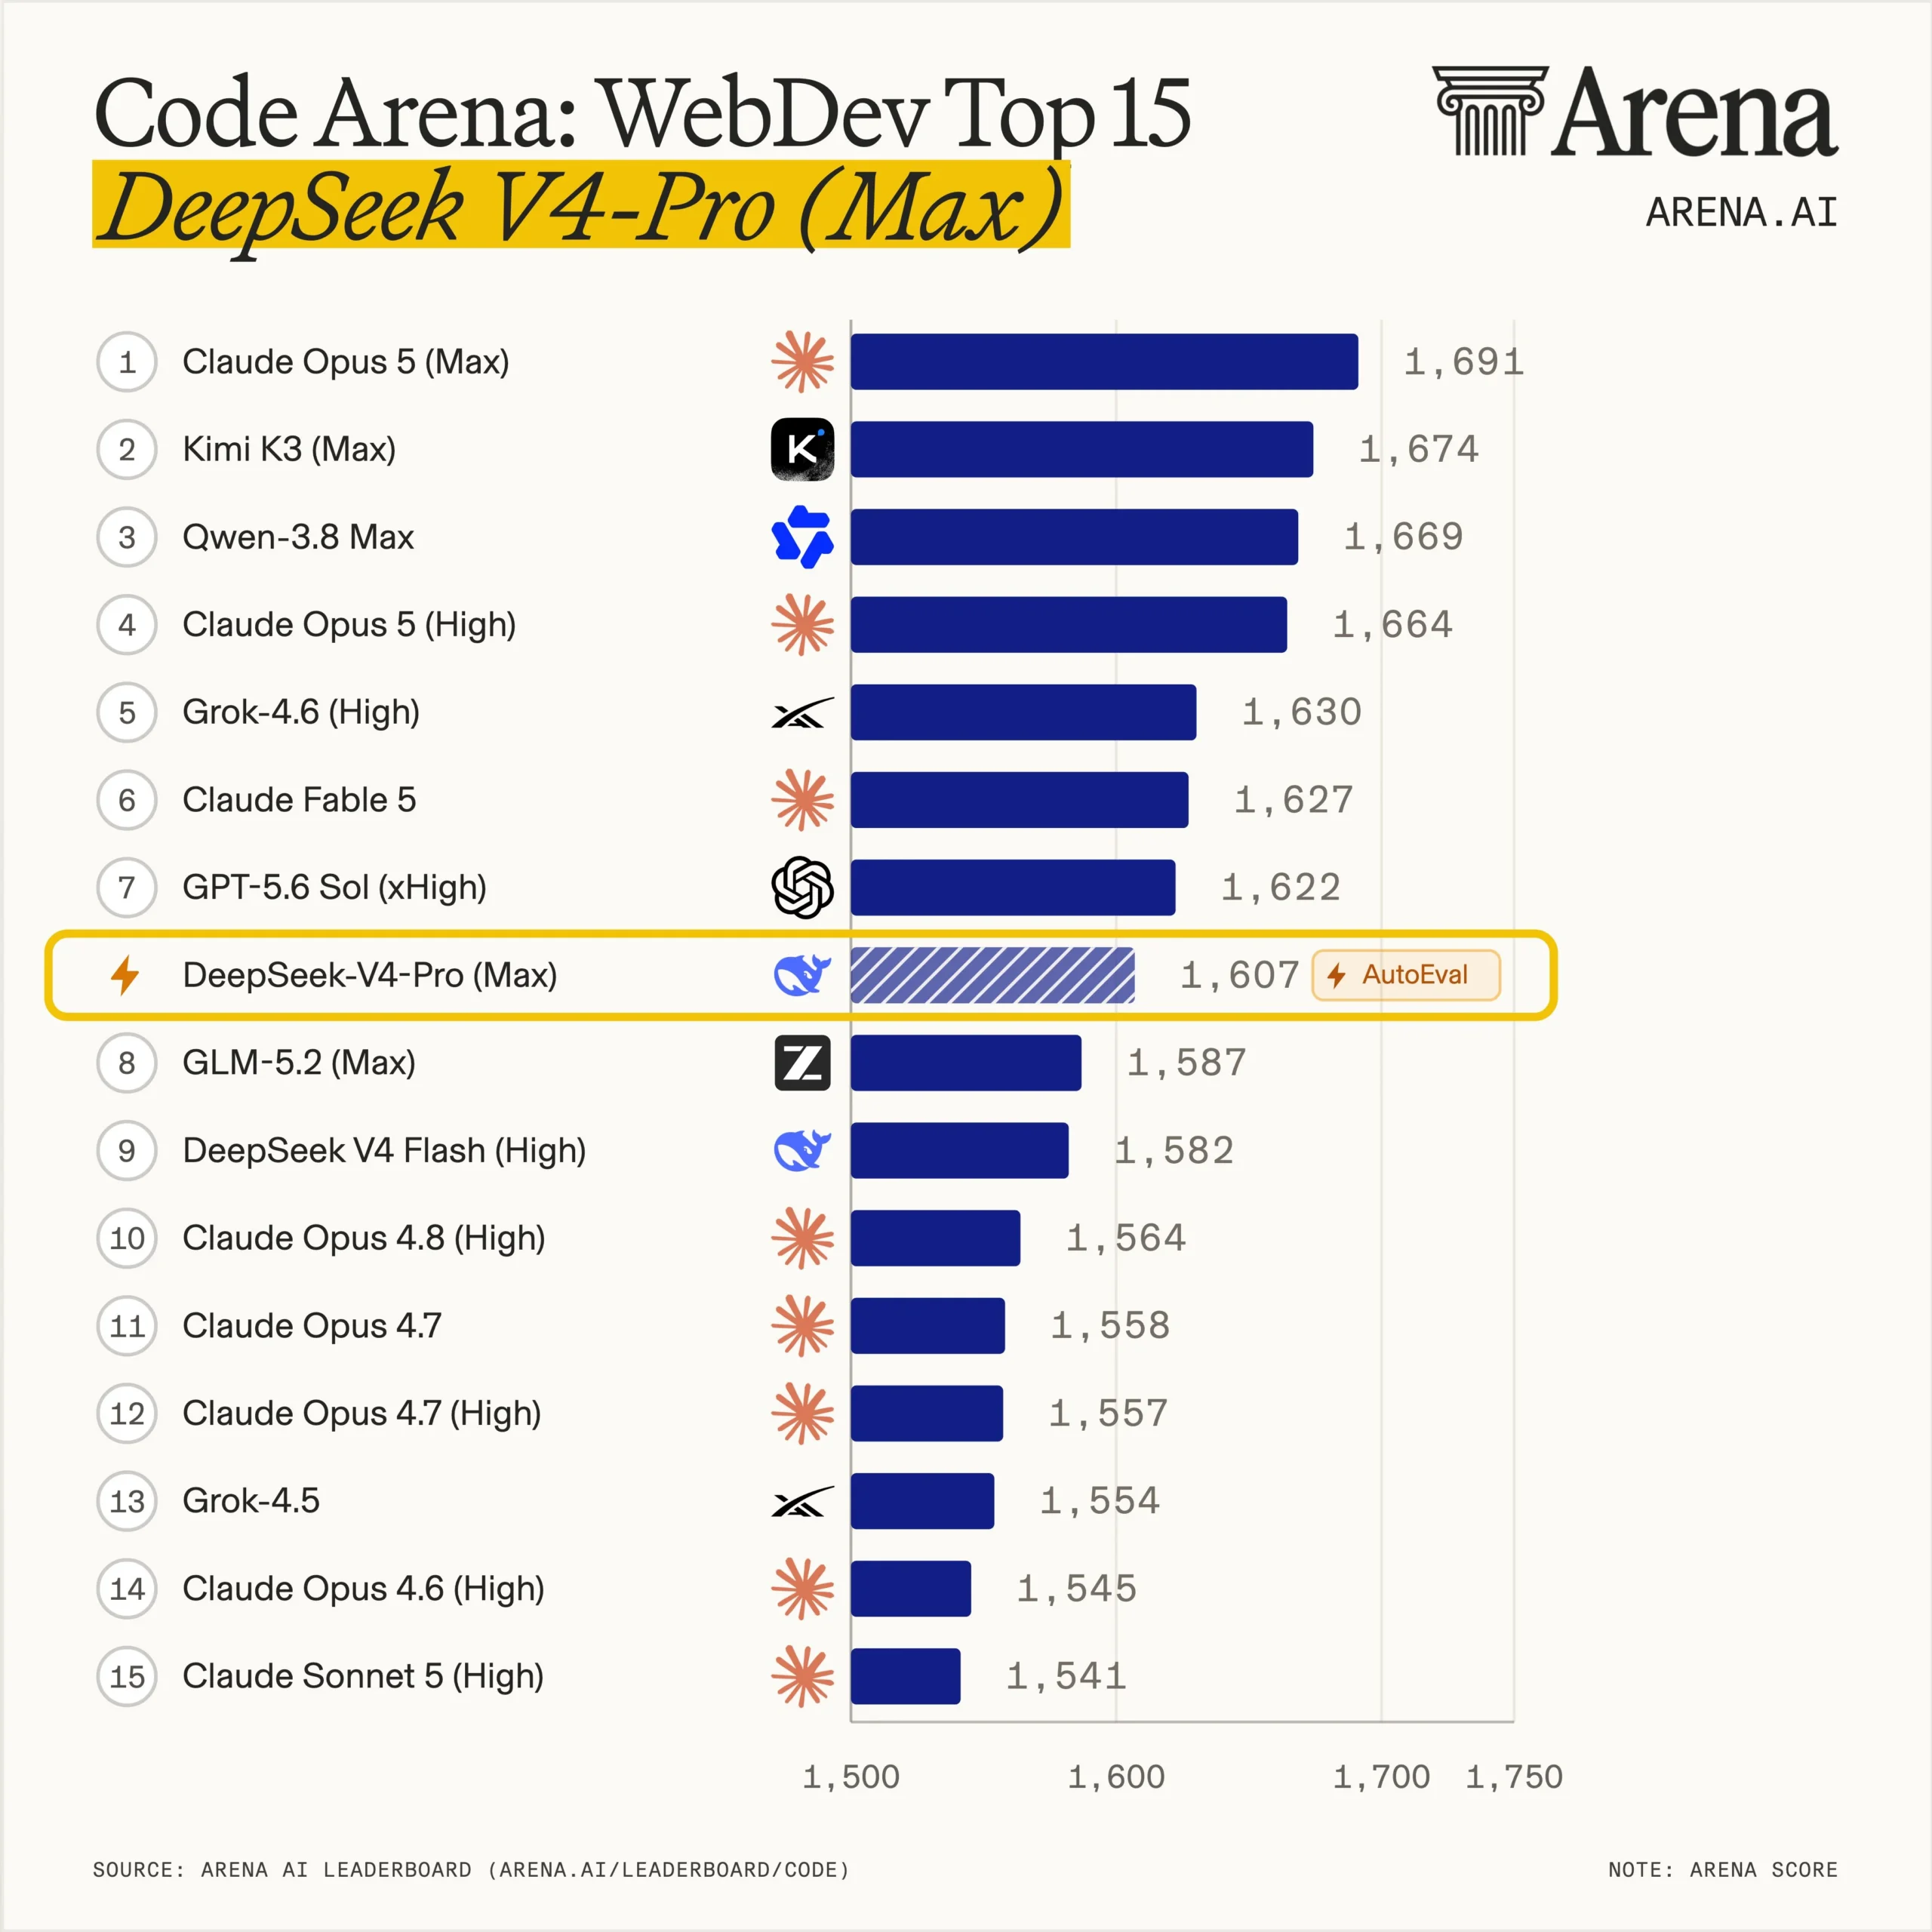
DeepSeek-V4-Pro 这两天在榜单上很显眼。Code Arena 的 WebDev 前 15 里,它排在第 8 左右,1607 分,前面是 Claude Opus 5、Kimi K3、Qwen-3.8 Max 这些大家伙。开源社区的动作也很快:有人把它的推理能力蒸馏到了 Qwen3.5 的 4B 和 9B 小模型里,还顺手做了一轮拒答调整。
先说我的结论:小参数承接大模型推理能力这个思路有意思,但“拒答率 99% 掉到 5%”这个数字,先别急着当真。
一、两个小模型是怎么来的
先看 4B 这个版本。它用的是 Heretic V2.0.0 的 ARA 算法,不动整个模型,只对第 16 到 32 层的权重做针对性调整。按发布方的说法,这样做的好处是把拒答率打下来的同时,KL 散度压在了 0.0378,数学和逻辑推理能力尽量保住,连 MTP 加速头都留着。
9B 那个版本路子一样:先把 DeepSeek-V4-Pro 蒸馏进 Qwen3.5 9B,再用 Heretic 做拒答调整。Q4 量化之后模型体积大约 5.6GB,普通轻薄本也有机会跑起来。
两个版本都是 Apache 2.0 开源协议,可以免费下载、本地部署。
二、拒答率那组数字,先冷静看
源文里最抓眼球的就是这组实测数字:100 道高危测试题,原版模型拒了 99 道;处理过的 4B 版本只拒 5 道;9B 版本更低,只拒 3 道。拒答率就这么从 99% 掉到了 5% 和 3%。
这组数字我得提醒三句,都是发布方口径,题库没公开,测试条件也是他们自己的:
第一,拒答率低不等于模型变强了。它只说明安全阀松了,模型更愿意开口回答,至于答得对不对、推理有没有缩水,是另一回事。
第二,KL 散度 0.0378 这个数,按发布方的说法是“智商几乎零损耗”。这个指标本身是衡量蒸馏前后模型输出分布变化的,数字越小说明保留得越好,但它同样是发布方自己测的,看看就好。
第三,这类做了去拒答处理的模型,只适合放在完全离线的私有环境里自己折腾。别拿去对外提供服务,也别用来绕平台规则。能回答和该不该回答,是两码事。
三、本地跑起来:先把 LocModel 升到 v3.3.0
源文里用的部署工具是 LocModel,最新版已经到了 v3.3.0。如果你之前装过旧版,记得先升级——只有新版才支持这类模型的格式转换和下载。工具可以去LocModel 官网下载。
硬件门槛按发布方的说法不高:9B 的 Q4 量化版大约 5.6GB,4B 的更小,8G 显存、苹果 MacBook 甚至核显轻薄本都能试着跑。下载模型需要能正常访问外网,网络环境自己提前准备好。
四、实测:拿两张图当首尾帧,本地生成 8 秒视频
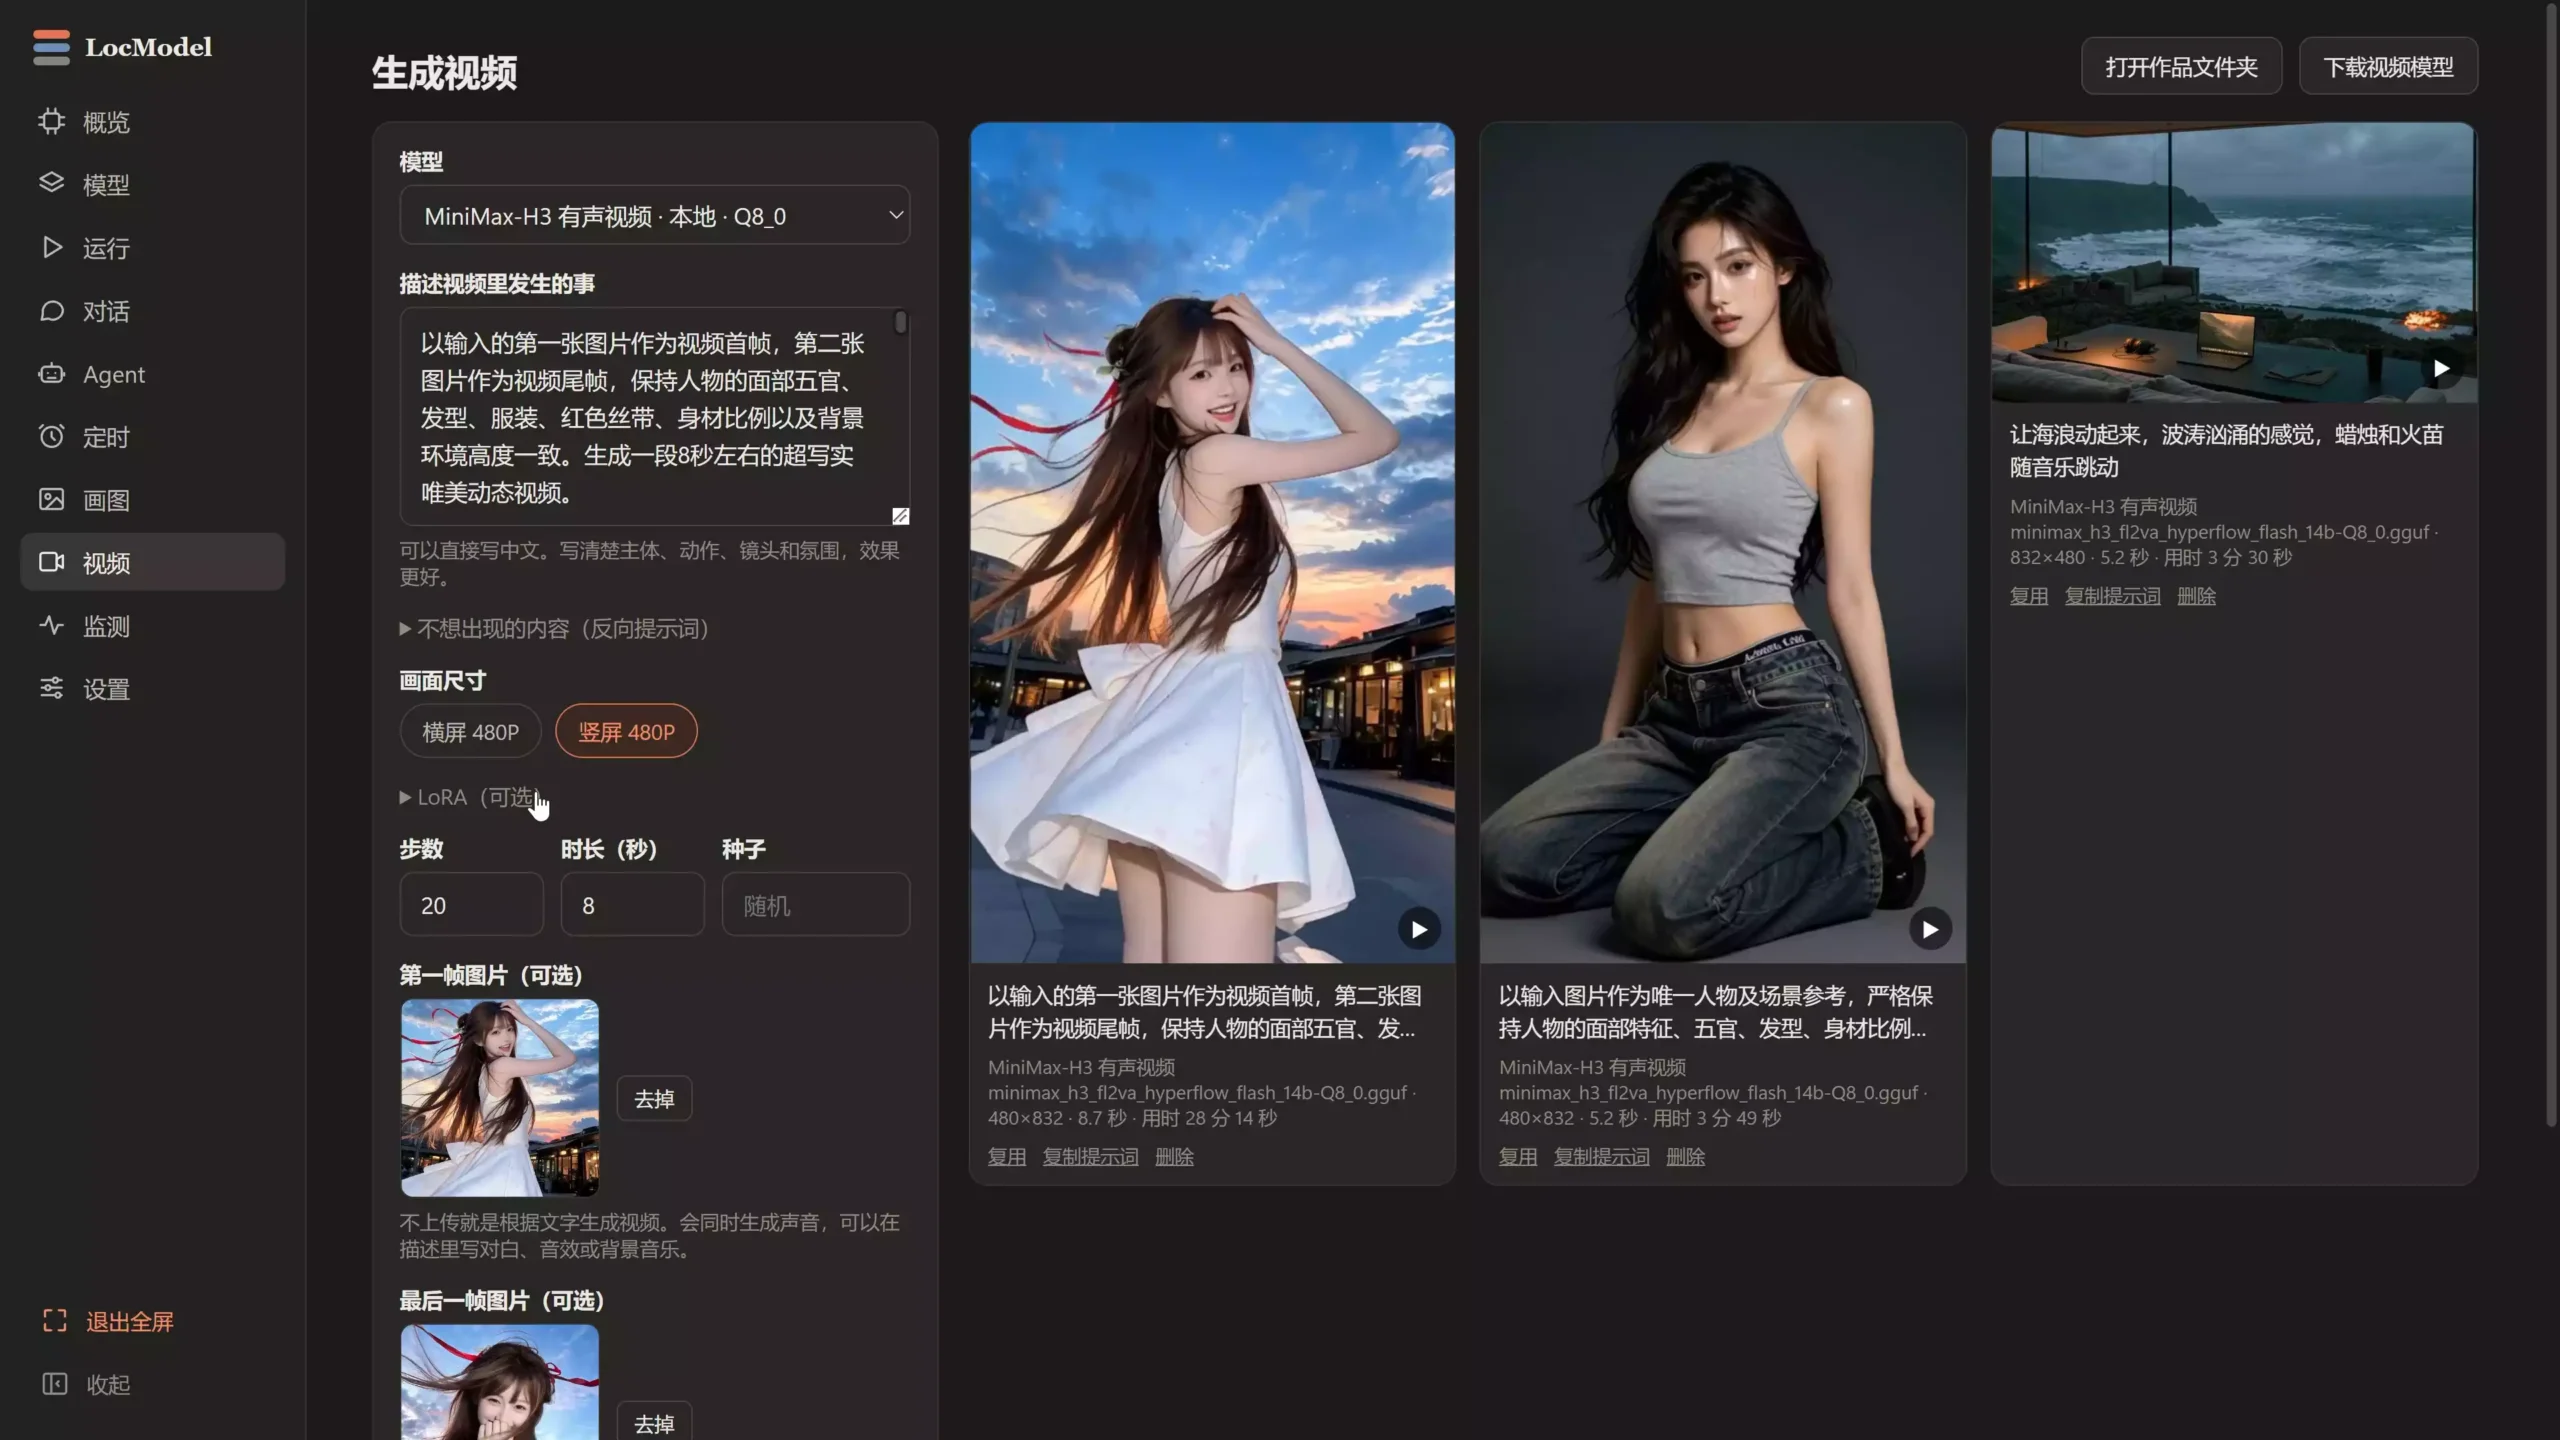
源文里比较实在的一段测试是图生视频。做法是拿两张图分别当视频的首帧和尾帧,提示词要求人物五官、发型、服装、红色丝带、身材比例和背景环境高度一致,生成一段 8 秒左右的超写实视频。分镜是按时间切的:开头镜头慢慢下移拉远、人物放下手露出笑容;中间转身回头;然后头顶比心;最后对着镜头比心加飞吻。画面要求电影级真实感、动作流畅,不能出现变脸、多余手指这些翻车项。
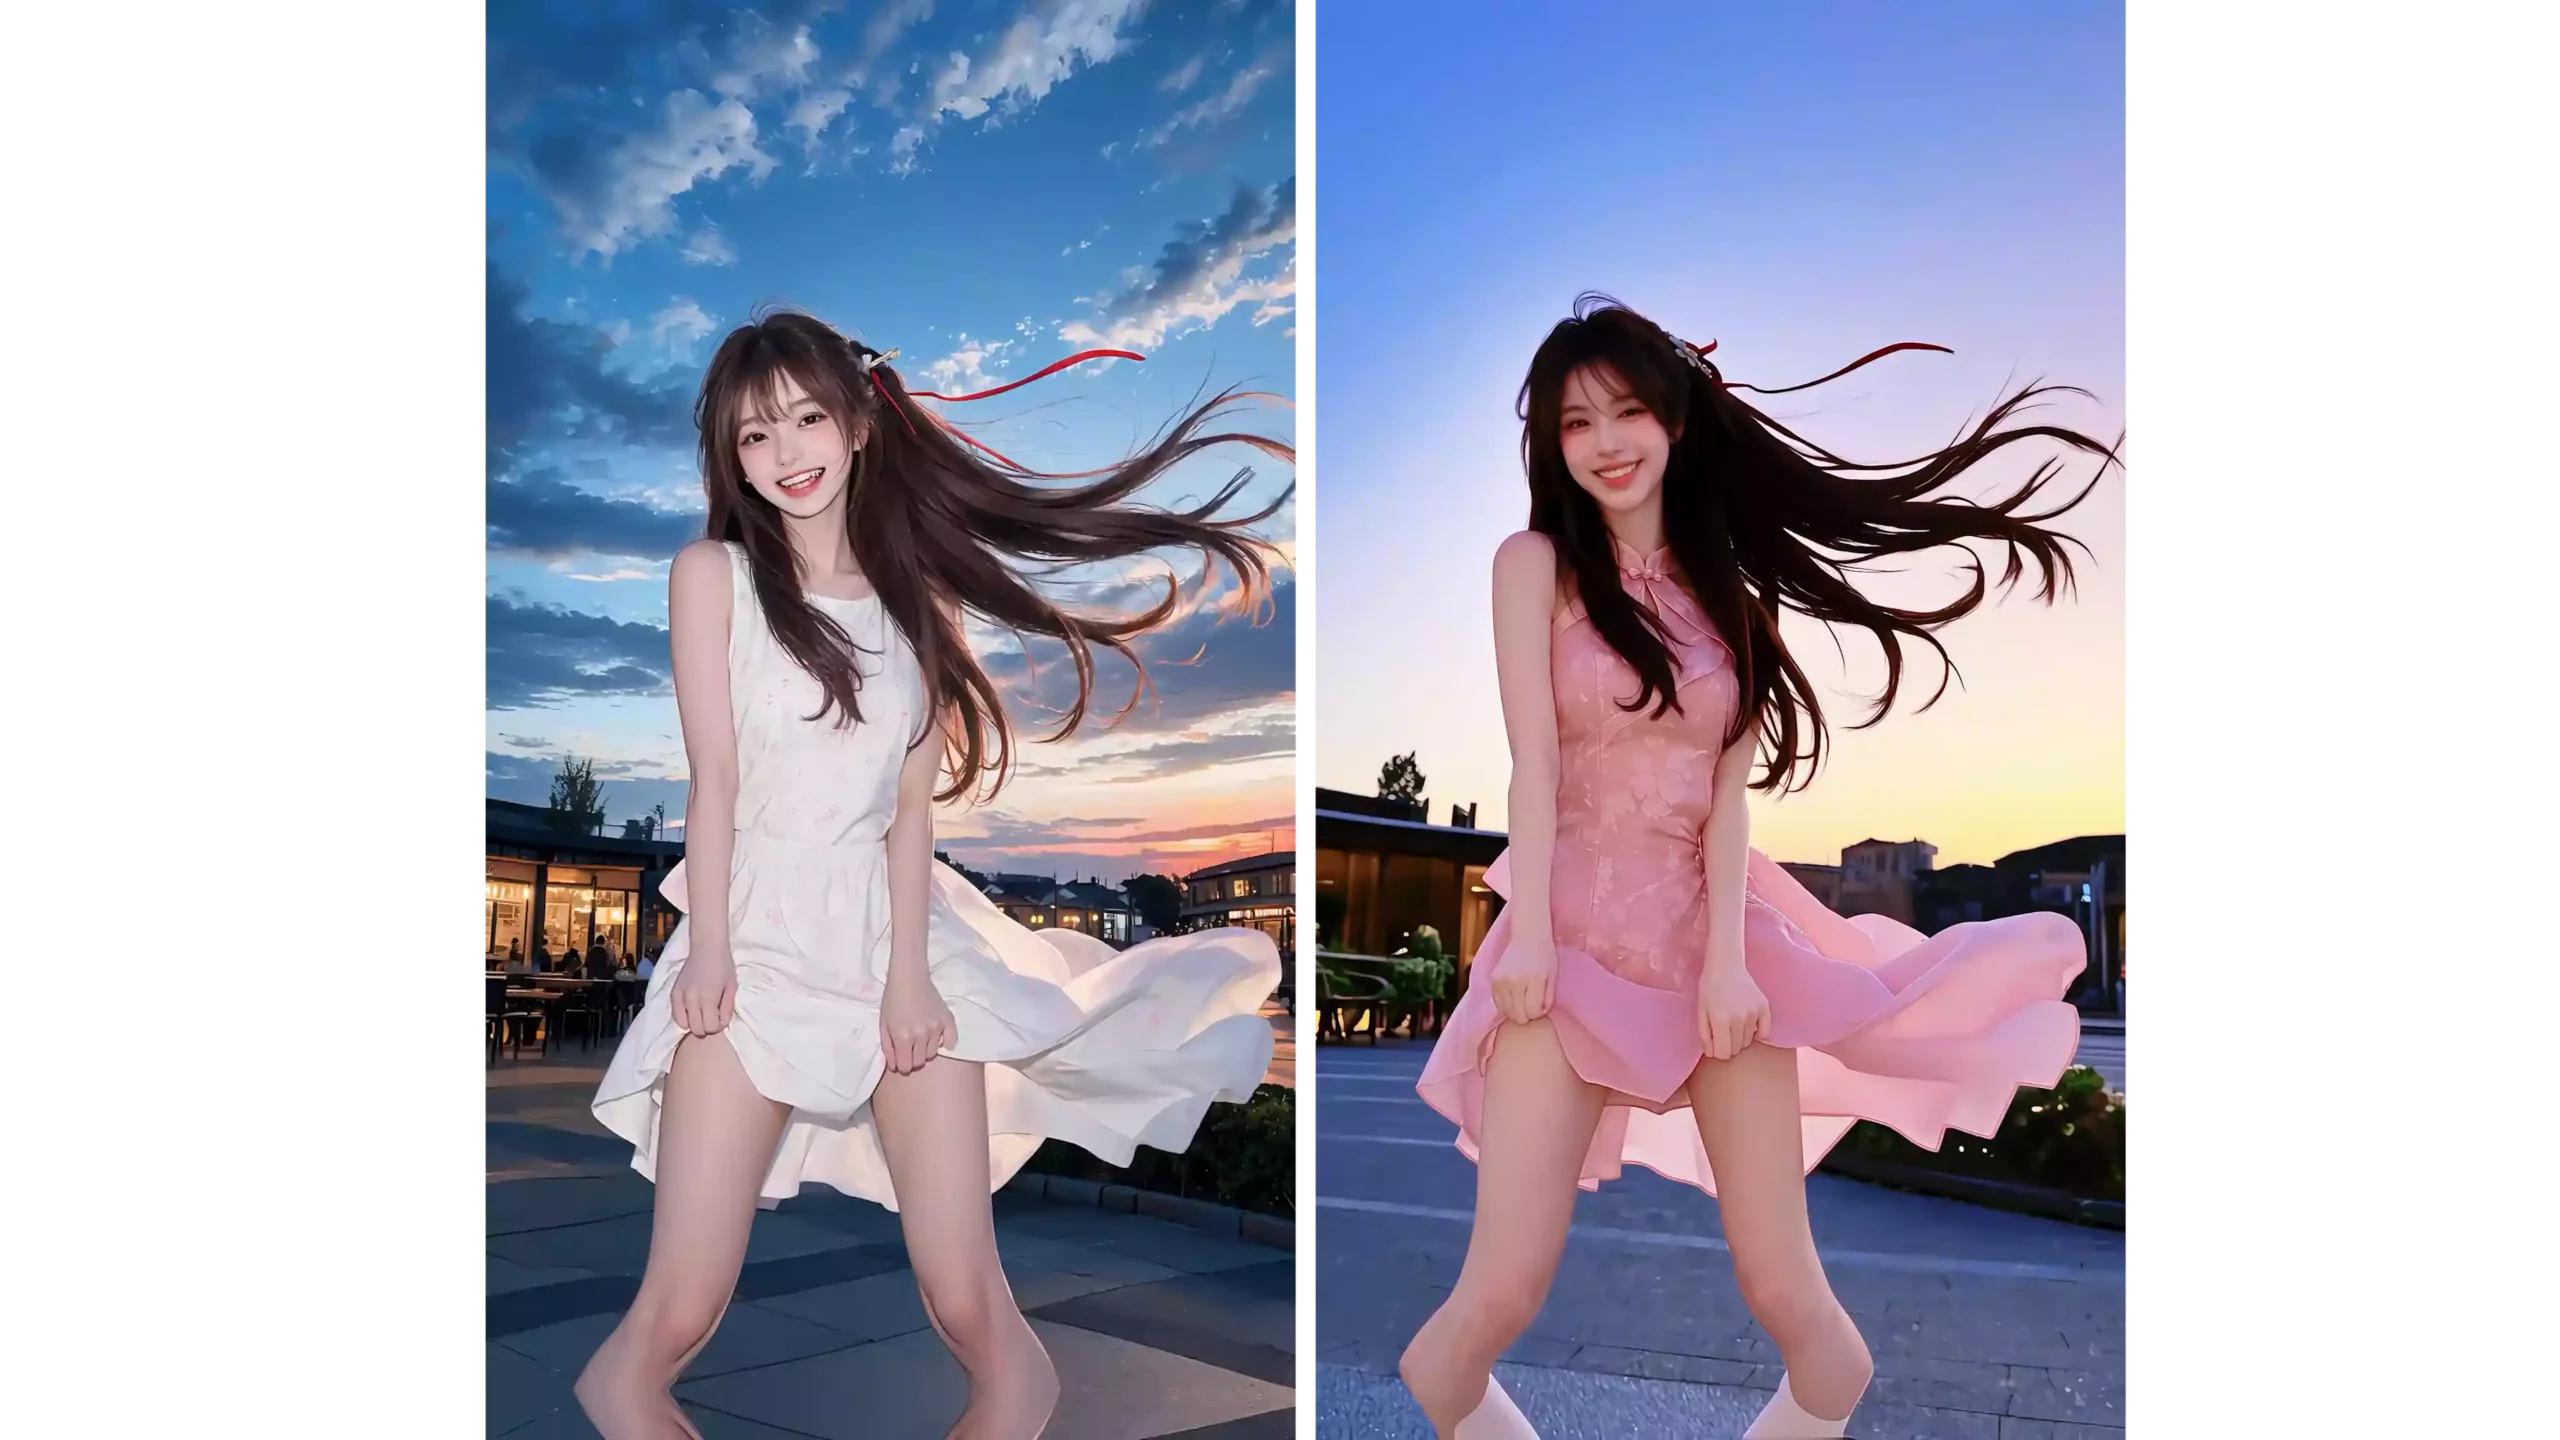
用的视频模型是 MiniMax-H3 有声视频,本地 Q8_0,竖屏 480P,20 步,8 秒。LocModel 的视频页里能直接看到生成结果和耗时,整个过程不用碰命令行。
五、顺带一个功能:定时任务
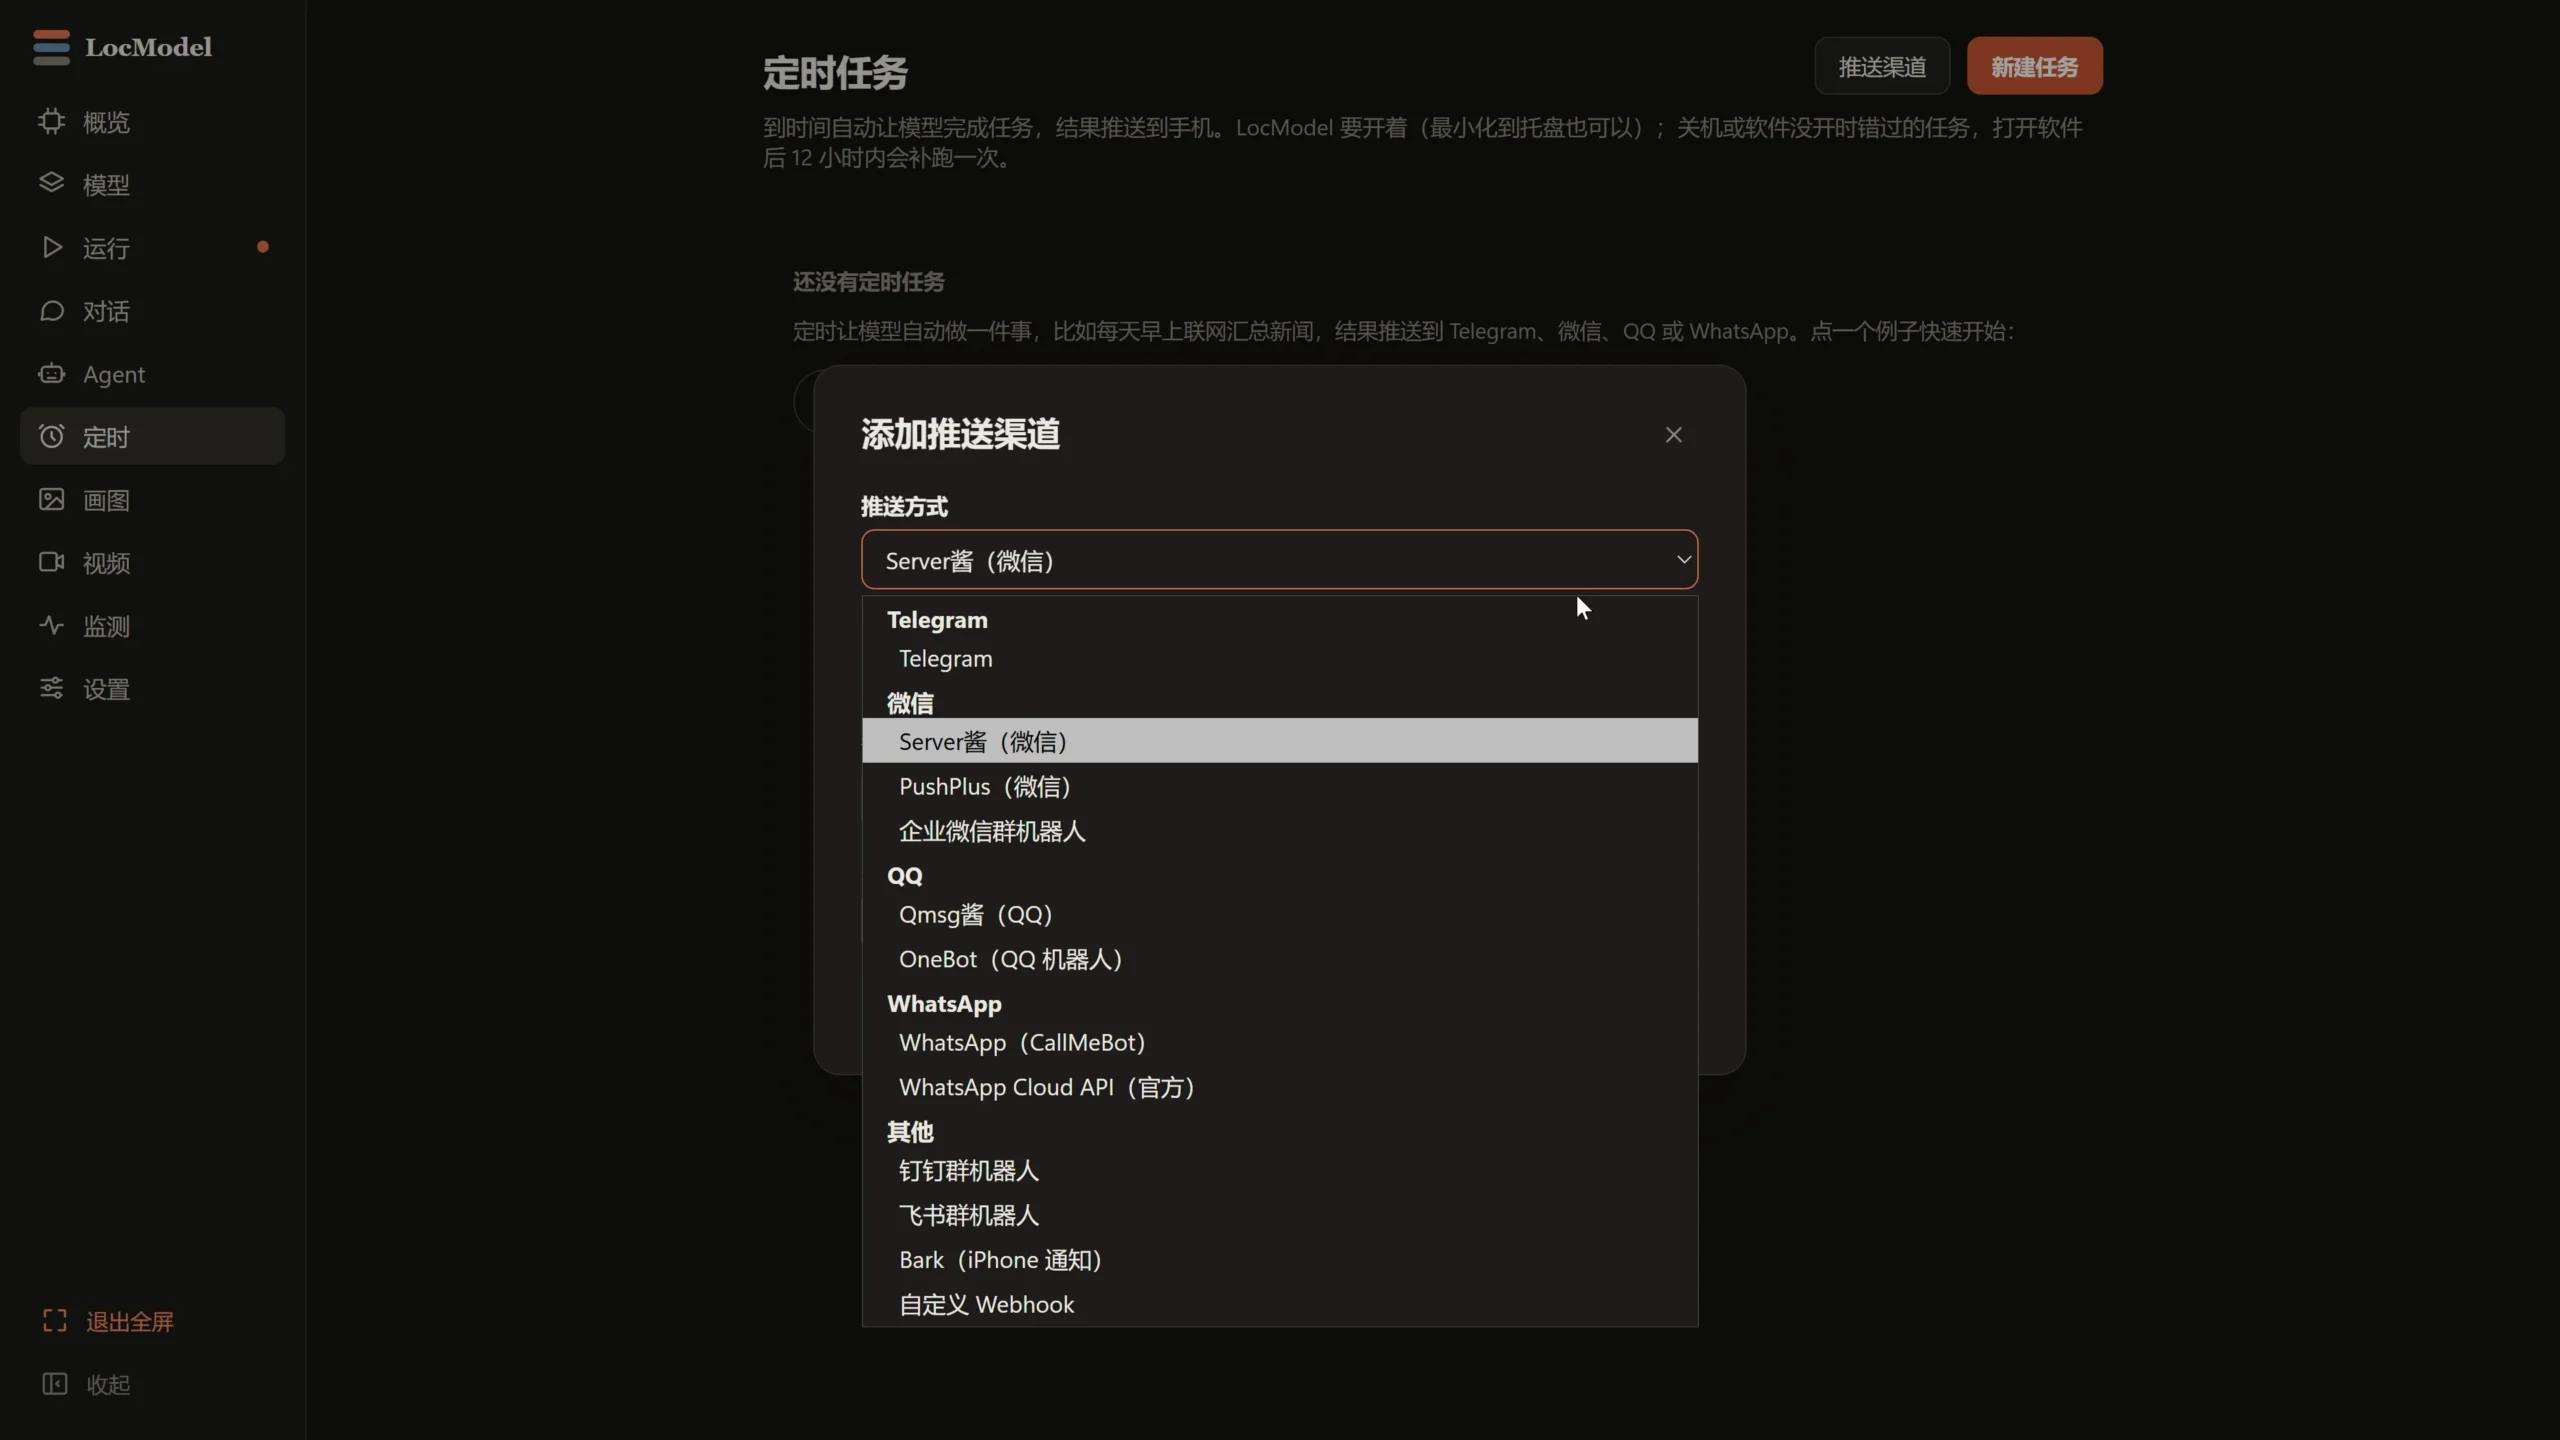
LocModel 还有个定时任务功能:到时间自动让模型完成任务,结果推送到手机。推送渠道支持 Telegram、微信、QQ、WhatsApp、飞书、钉钉这些,软件要开着(最小化到托盘也行);关机或者软件没开时错过的任务,打开软件后 12 小时内会补跑一次。每天早上自动汇总新闻这类用法,倒是挺适合挂着玩的。
值不值得试?
蒸馏到小参数、推理能力尽量保留,这个方向本身值得关注。4B、9B 的体积配上 5.6GB 上下的量化文件,本地部署的门槛确实下来了。
但这篇的两个模型,核心卖点就是“拒答率低”,数字是发布方口径,题库也不公开,看看就好。真想玩,等自己有离线环境、想清楚用途再说,别急着下。