一张照片、一首歌,照片就能开口唱歌:LocModel 对口型视频本地就能跑
刷短视频的时候,这种视频估计你也刷到过:一张静态照片里的人突然开口唱歌,嘴型对得上,表情还跟着音乐走,看着跟真唱似的。
做法其实没多神秘,就三样东西:一张人像照片、一首歌,再加一个能在本地跑的工具。不用剪辑基础,也不用把照片和音乐传到哪个网站上,在自己电脑上就能做出来。
先看效果,下面这段 31 秒的演示就是这么做出来的:
一、界面长这样:就一个“对口型视频”页
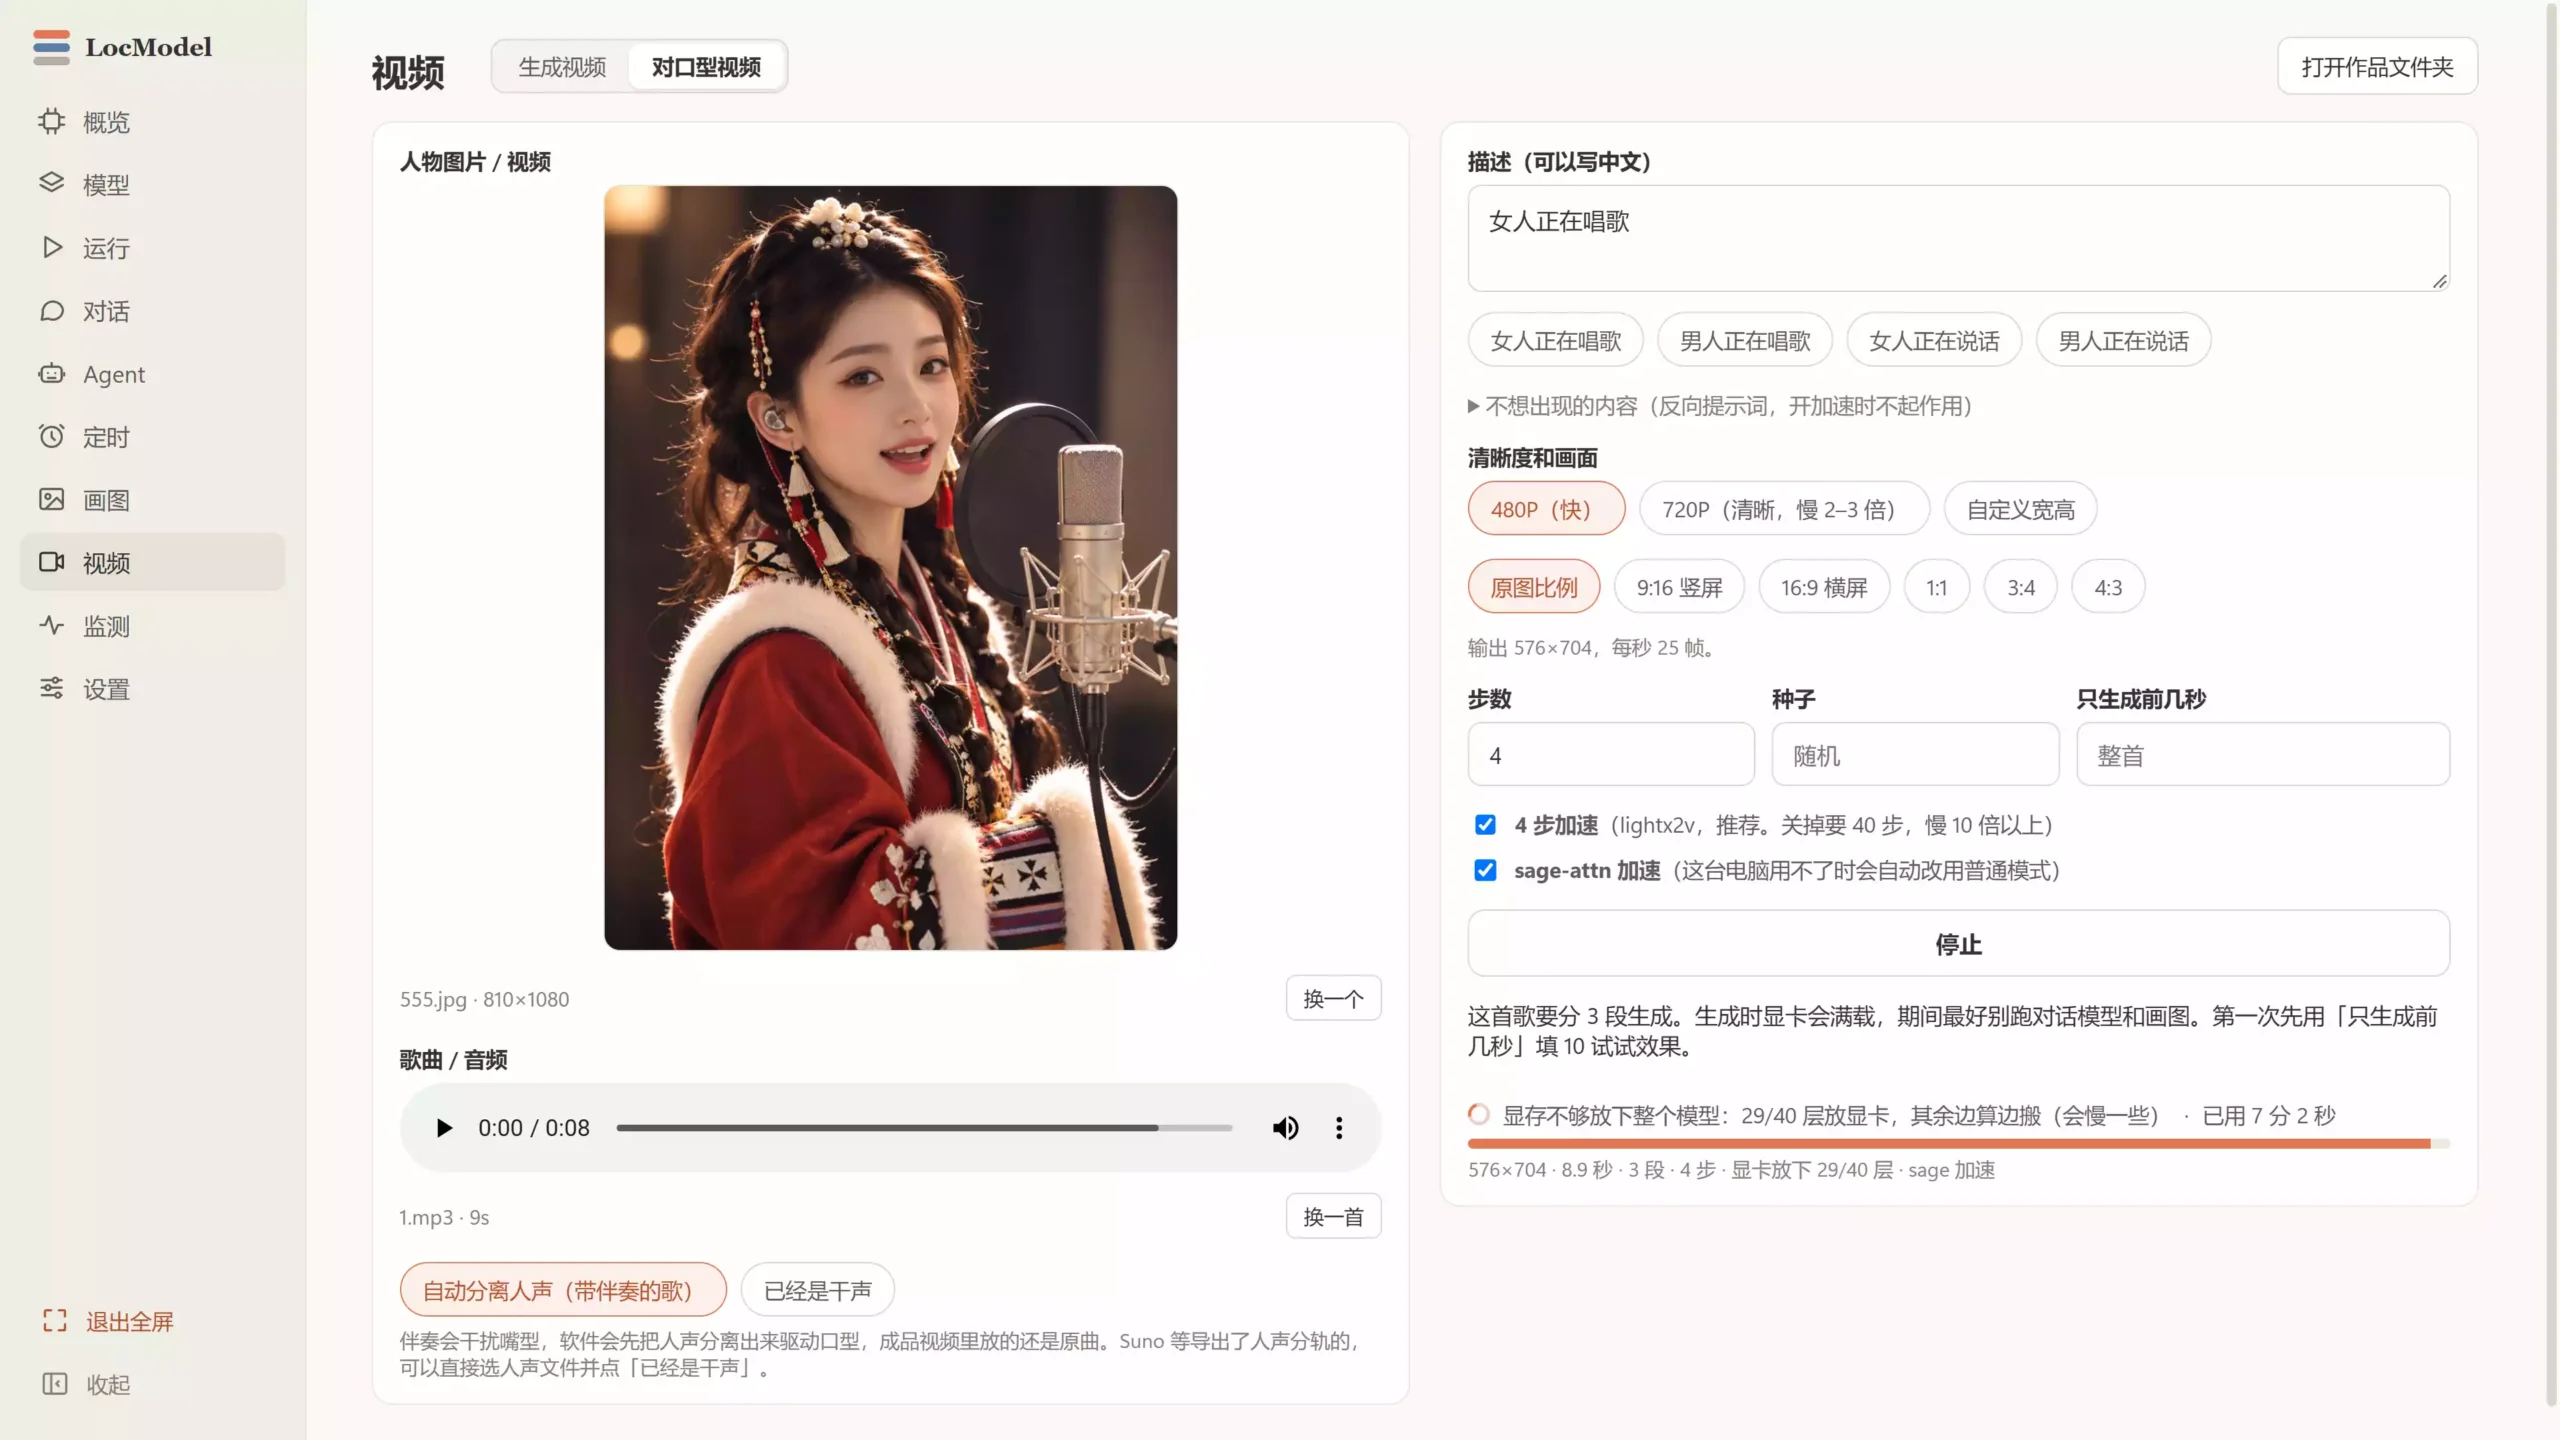
打开 LocModel,进“视频”页,点“对口型视频”,整个流程都在这一个界面上:左边传人物图片、下面传歌曲,右边写一句描述、选清晰度和画面比例,剩下的交给软件。
二、准备工作就三步
1、先把 LocModel 升到 3.5.0
按发布方的说法,这个功能要 LocModel 3.5.0 或更新版本才有。之前装过旧版的,先升级,不然可能根本找不到这个入口。工具可以去LocModel 官网下载。
2、准备一张人像图
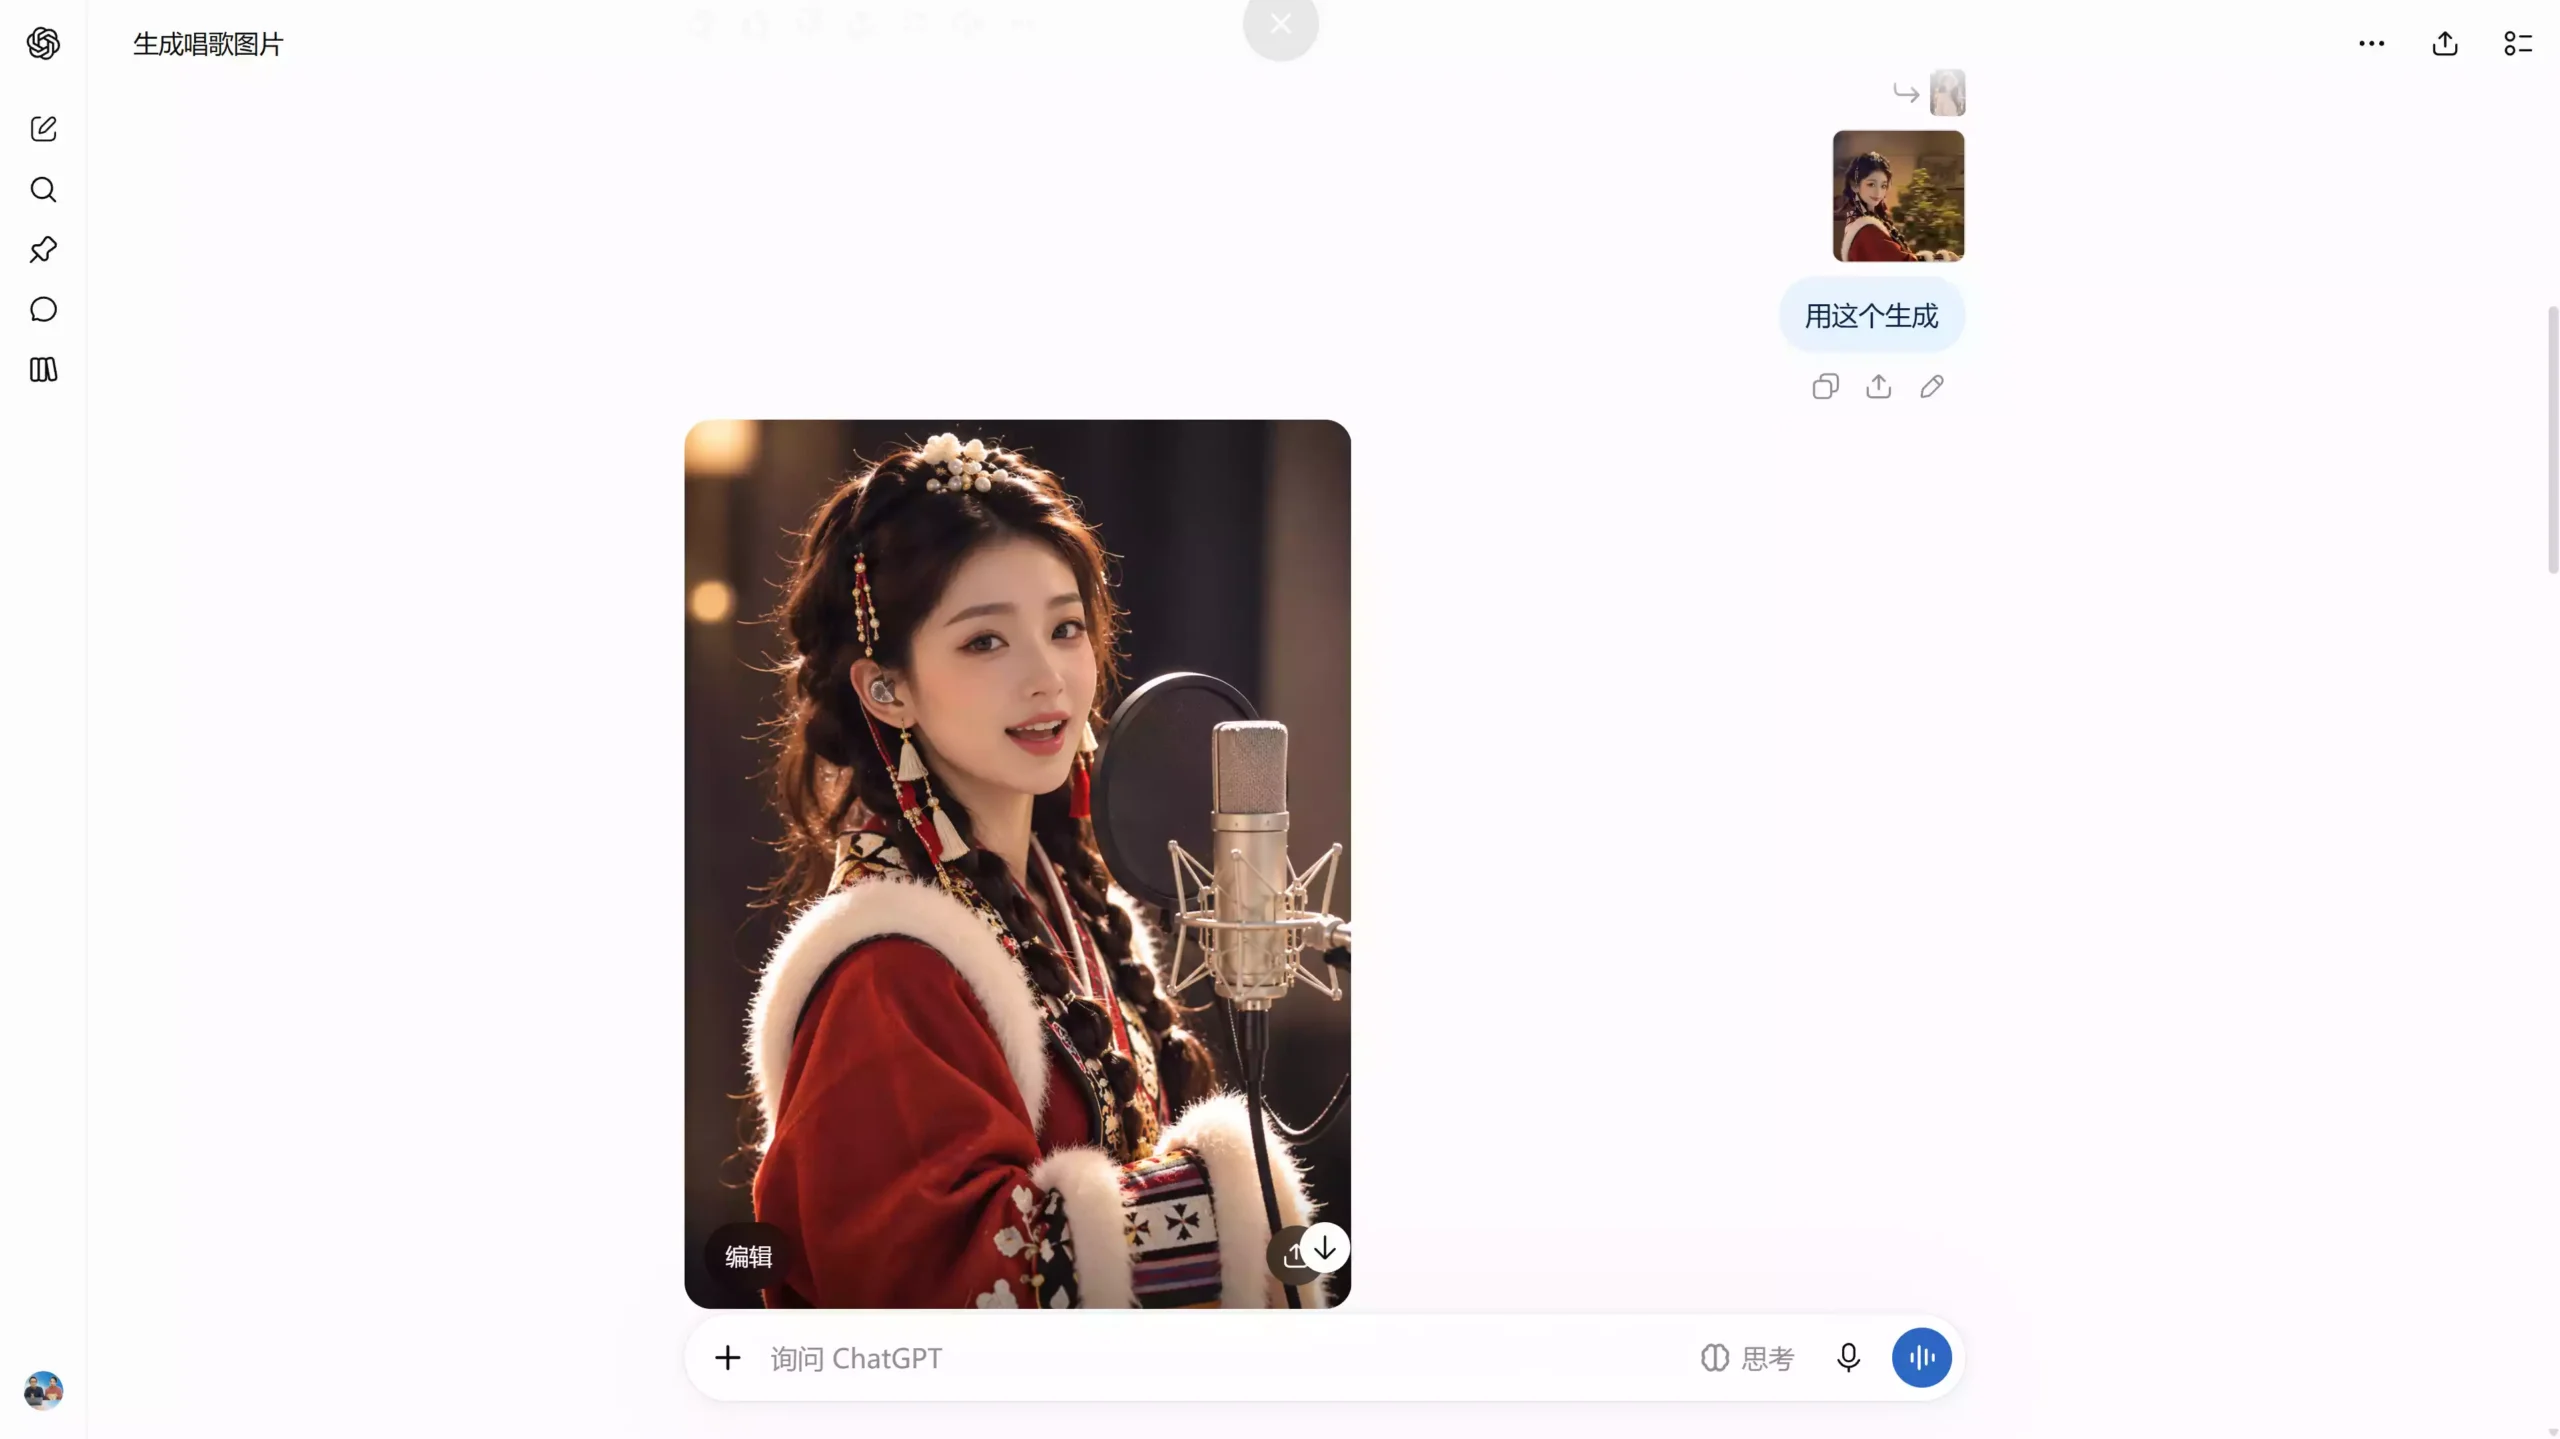
男声女声、什么风格,自己定。手头没有合适的照片,也不用现拍,让 AI 现画一张就行。源文里的做法是:上传任意一张人物图片到 ChatGPT,再加一句提示词:
通过这个人物,生成一个在麦克风前唱歌的图片
就能拿到一张现成的唱歌图:
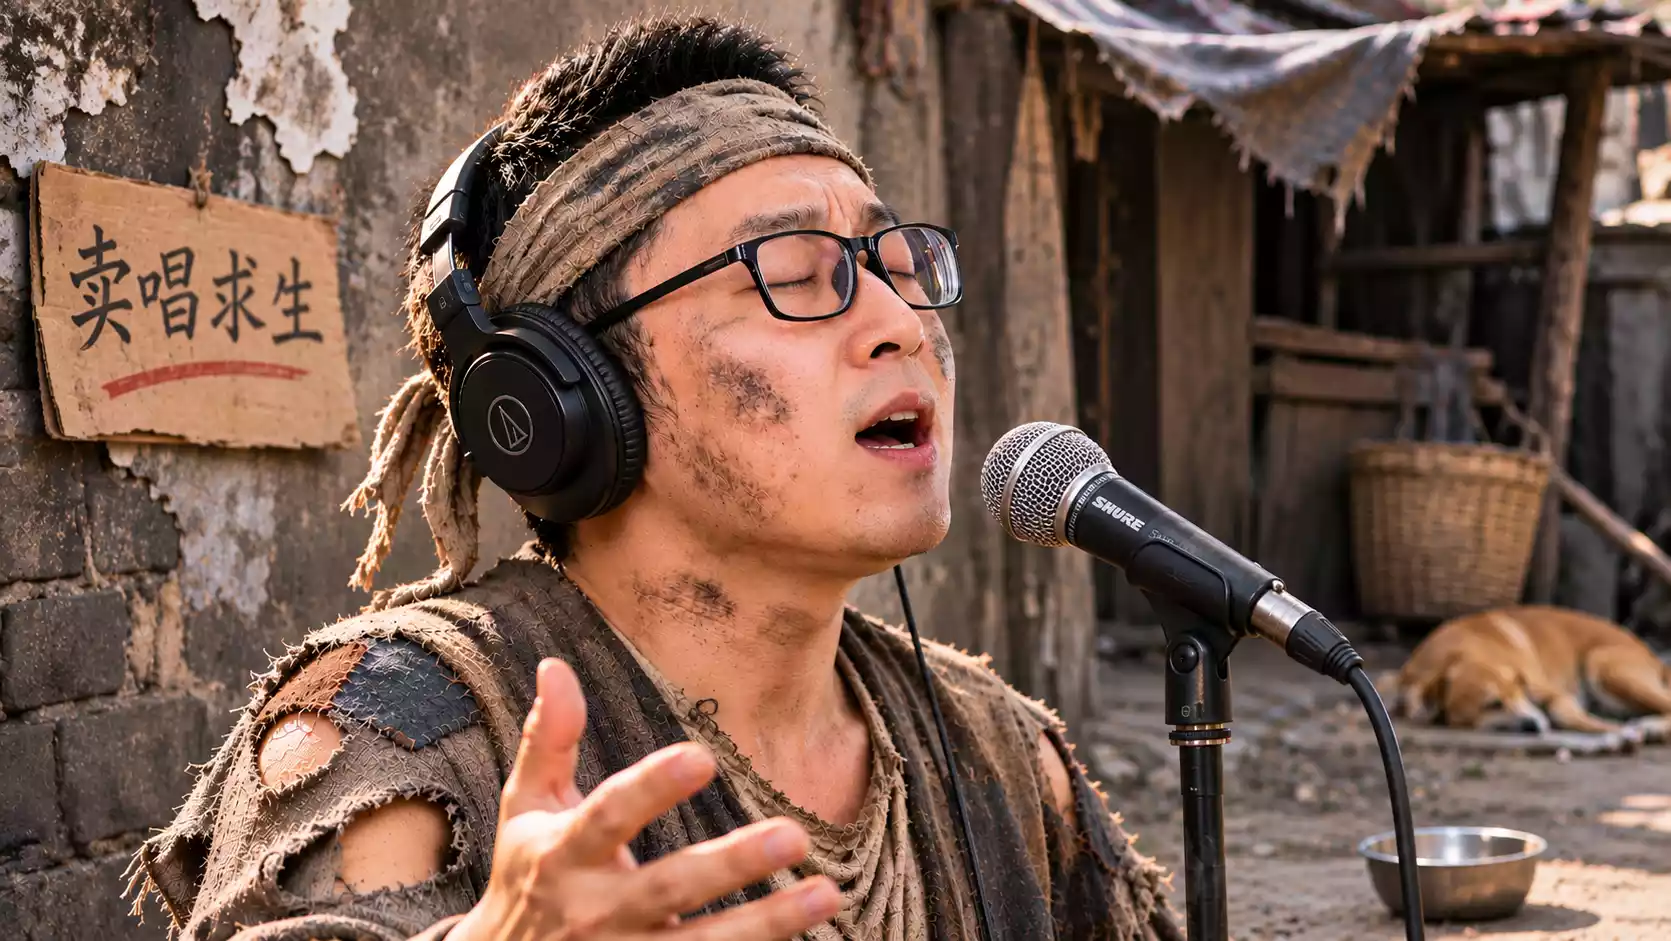
风格也可以放得很开。比如下面这张 AI 生成的街头歌手,耳机、话筒、纸牌子一应俱全,拿去当素材一样能开口唱:
3、准备一首歌
这个最简单。网上找一首自己喜欢的歌就行,支持 mp3、mp4、wav 这些常见格式,视频文件也可以直接拿来用。
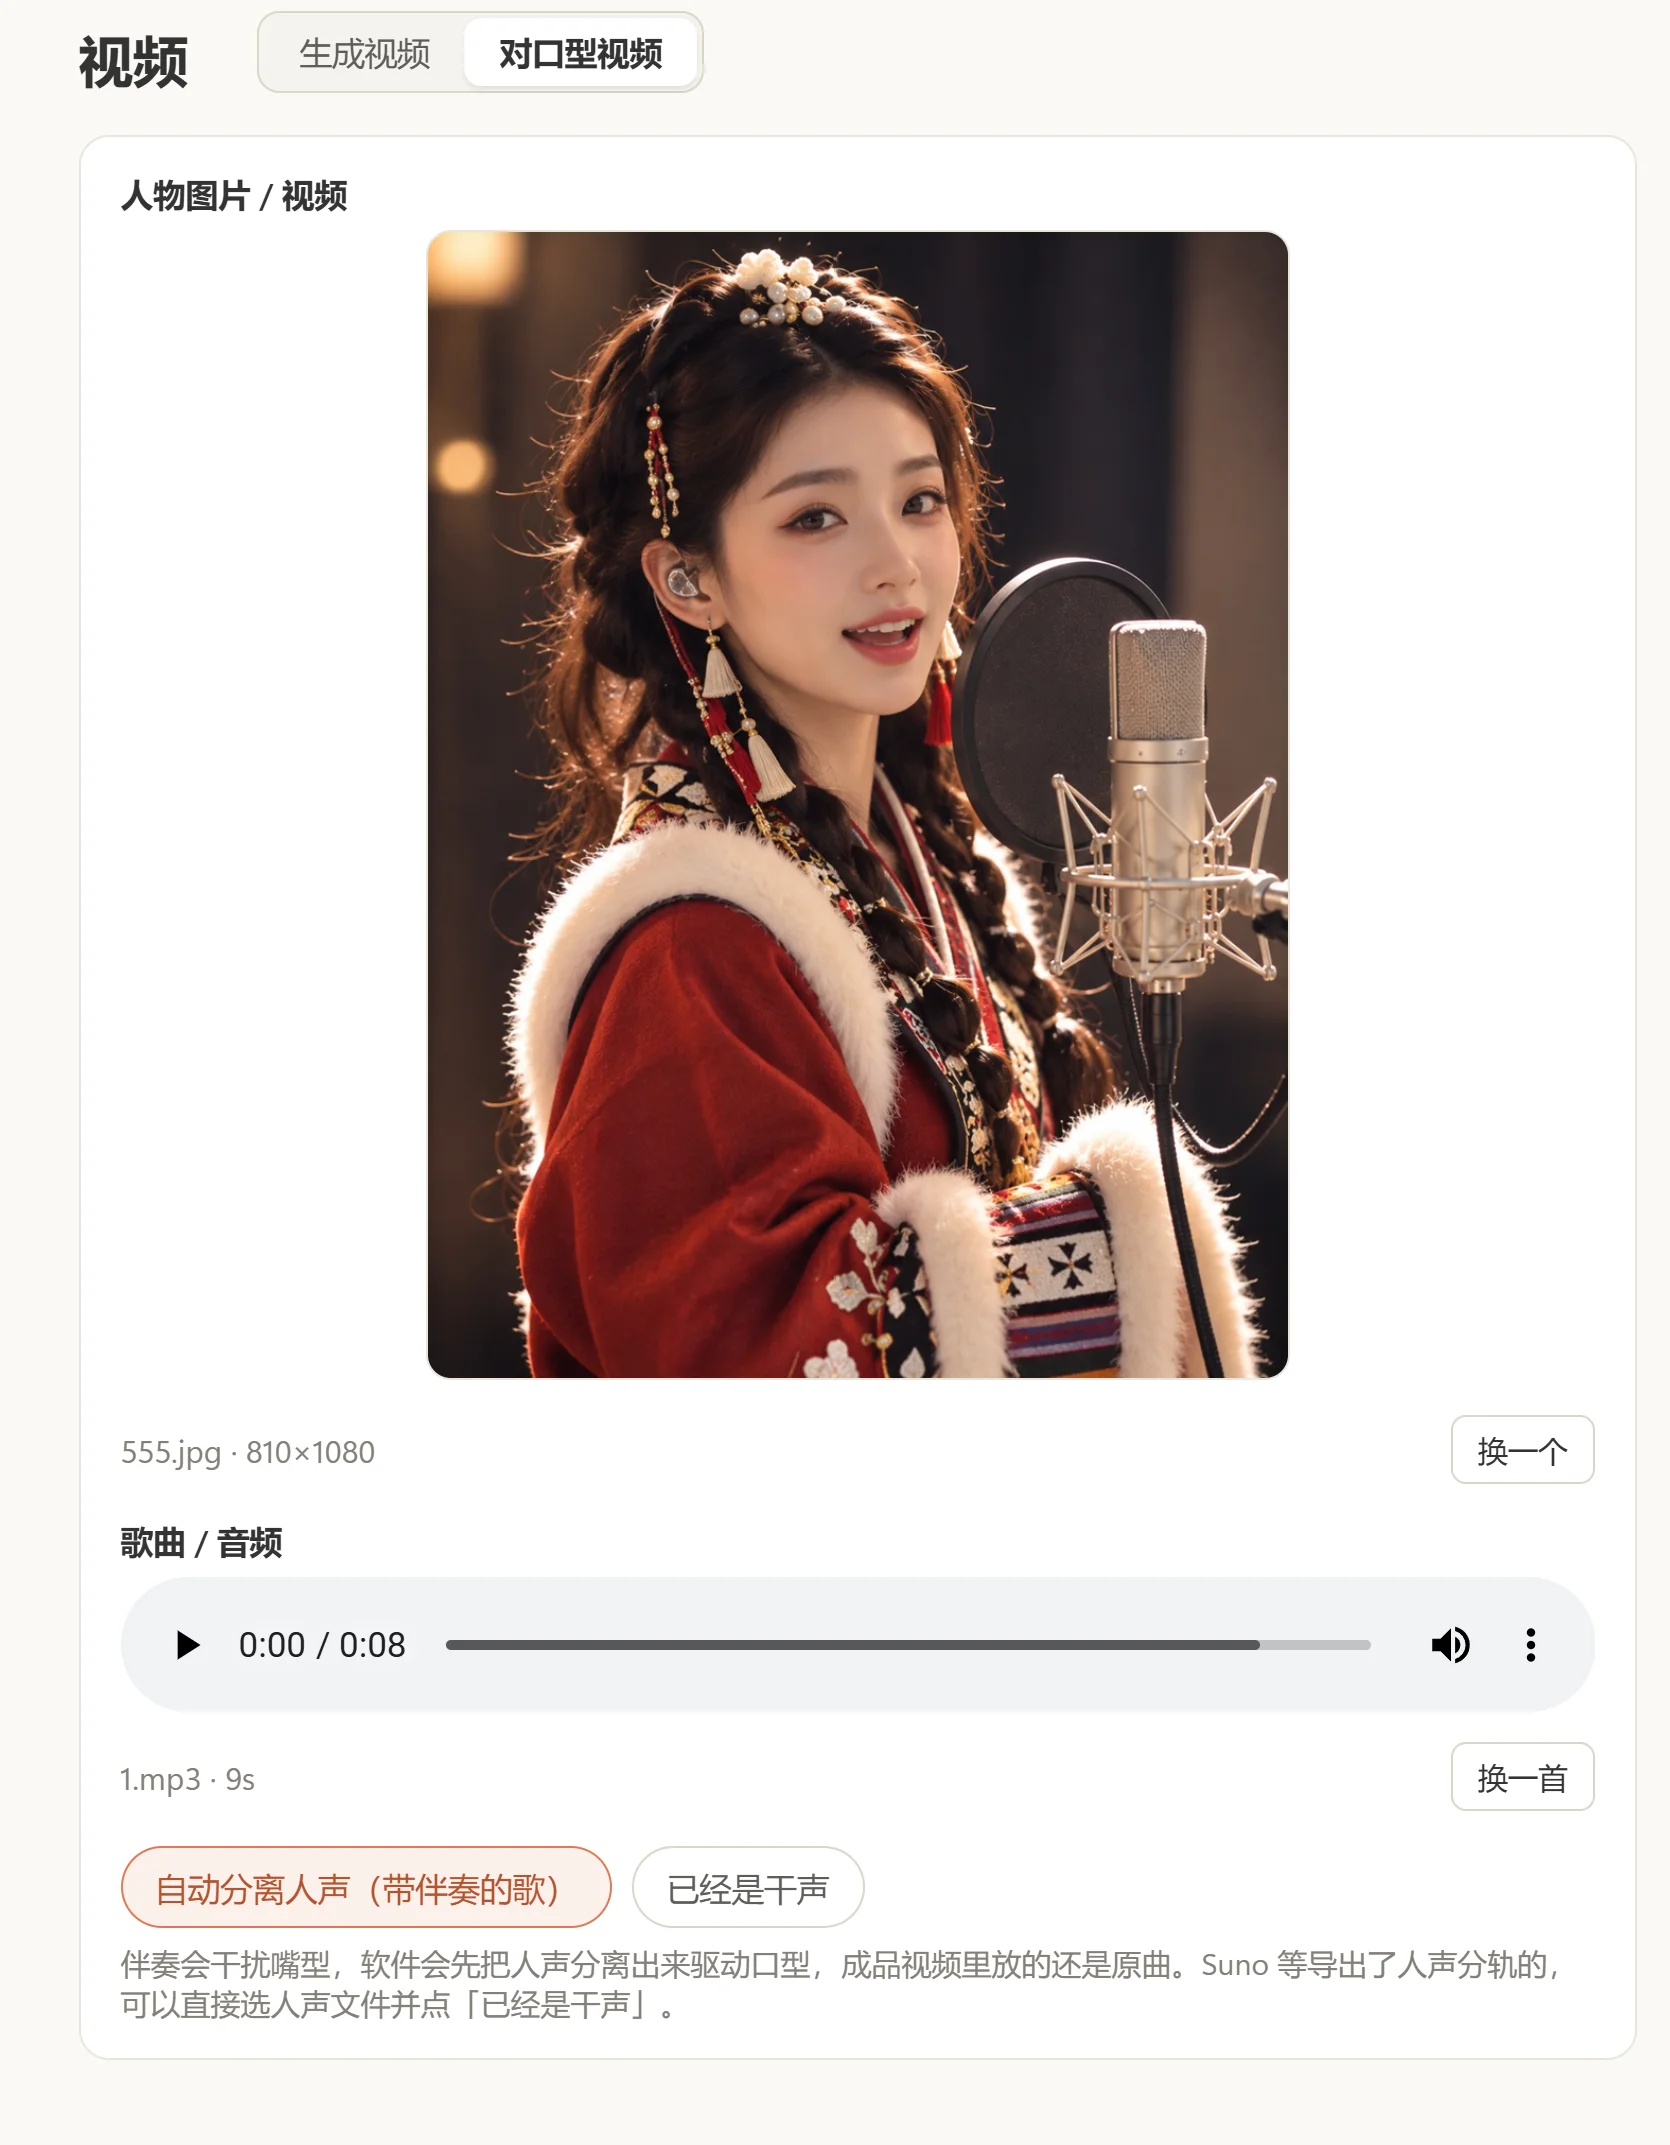
关键一点是:带伴奏的歌不用自己先处理。软件会先把人声分离出来驱动口型,成品视频里放的还是原曲,伴奏不会丢。要是你手头的音频已经是干声(比如 Suno 这类工具导出的人声分轨),直接选“已经是干声”就行:
三、生成之前,这几个设置先看一眼
这些都是软件界面上直接能看到的选项,按界面上的说法:
第一,描述:写一句就行,比如“女人正在唱歌”,界面还给了“男人正在唱歌”“女人正在说话”几个快捷选项,点一下就能填。
第二,清晰度:480P 生成快,720P 更清晰,但按界面标注要慢 2–3 倍。第一次试效果,先用 480P 就够了。
第三,画面比例:原图比例、9:16 竖屏、16:9 横屏、1:1 这些都有,竖屏发短视频直接选 9:16。
第四,步数:默认 4 步加速,界面建议就这么开着;关掉要跑 40 步,慢 10 倍以上。
第五,只生成前几秒:界面上的建议是第一次先填 10 秒试效果,满意了再生成整首。长歌会分段生成,生成时显卡会满载,期间最好别同时跑对话模型和画图。
四、提醒两句
第一,效果好不好,很大程度取决于原图和歌曲本身:人像越清晰、正面、光线越好,口型贴得越自然;歌曲人声越干净,分离出来驱动口型的效果也越稳。
第二,整套流程都在本地跑,照片和音乐不用上传到第三方平台,这点对不想把素材传上网的人很友好。但反过来也得注意:别拿别人的照片、别人的歌乱生成,肖像和版权问题自己先想清楚。
值不值得试?
想做这类唱歌视频、又不想把照片传到网上的人,这个本地路线值得一试。门槛就一张图、一首歌,工具免费,生成参数界面上都写明白了,第一次拿“只生成前几秒”试一把,成本很低。