显卡没换,本地 AI 先变快了?GPU-UNLOCK 的解锁思路,先看清能提速什么
本地跑大模型卡,不一定是模型选大了。有时候瓶颈在显卡本身:同一张卡,某些算力路径并没有被完全放开,跑起来就显得比纸面参数慢。
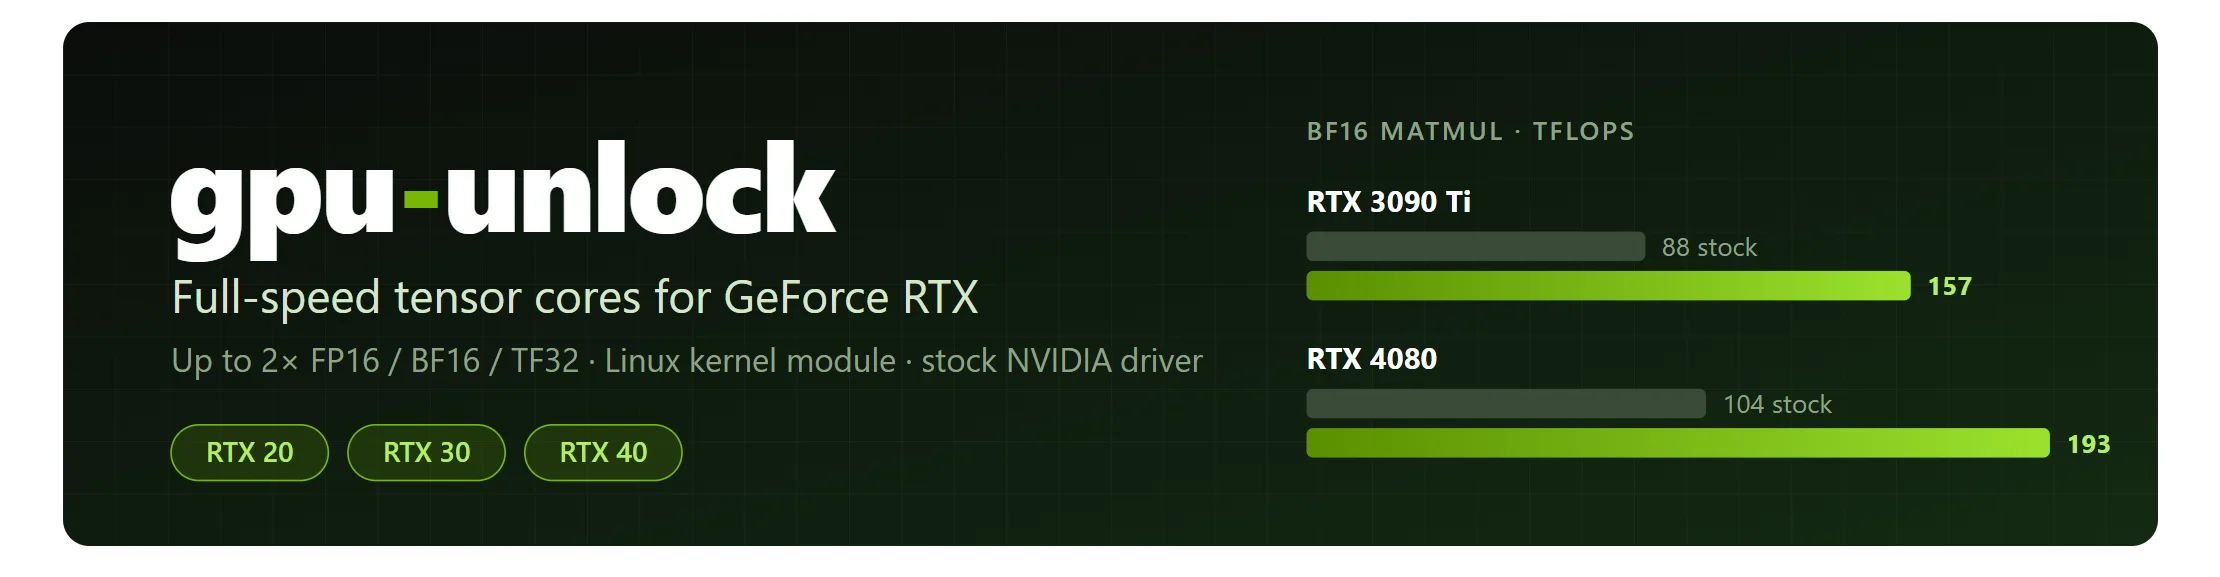
最近有个开源项目 GPU-UNLOCK,打的就是这个点子:通过调整驱动或内核层面的限制,把一部分被压住的算力释放出来,让本地推理跑得更快。它不是换硬件,也不是给模型换个壳,效果到底值不值得折腾,得先看它能提速什么、提速不了什么。
先说结论:它提速的是特定运算,不是所有场景
按项目方给出的口径,解锁之后变化最明显的是 BF16 这类矩阵运算。也就是说,模型里大量用到这类运算的环节,速度有机会上来。
但也有明确提速不了的地方:令牌逐个生成的解码环节、INT8、FP8、INT4 这类量化运算、游戏,以及 FP32 的 CUDA 运算,基本没有变化。输出结果本身也不变,变的只是速度。
这句话很关键:如果你平时最耗时的恰恰是解码环节,或者跑的是上述量化模型,那这个工具大概率不会让你有体感变化。先对上自己的使用场景,再决定要不要动手。
兼容性先对号:30 系最稳,50 系目前不支持
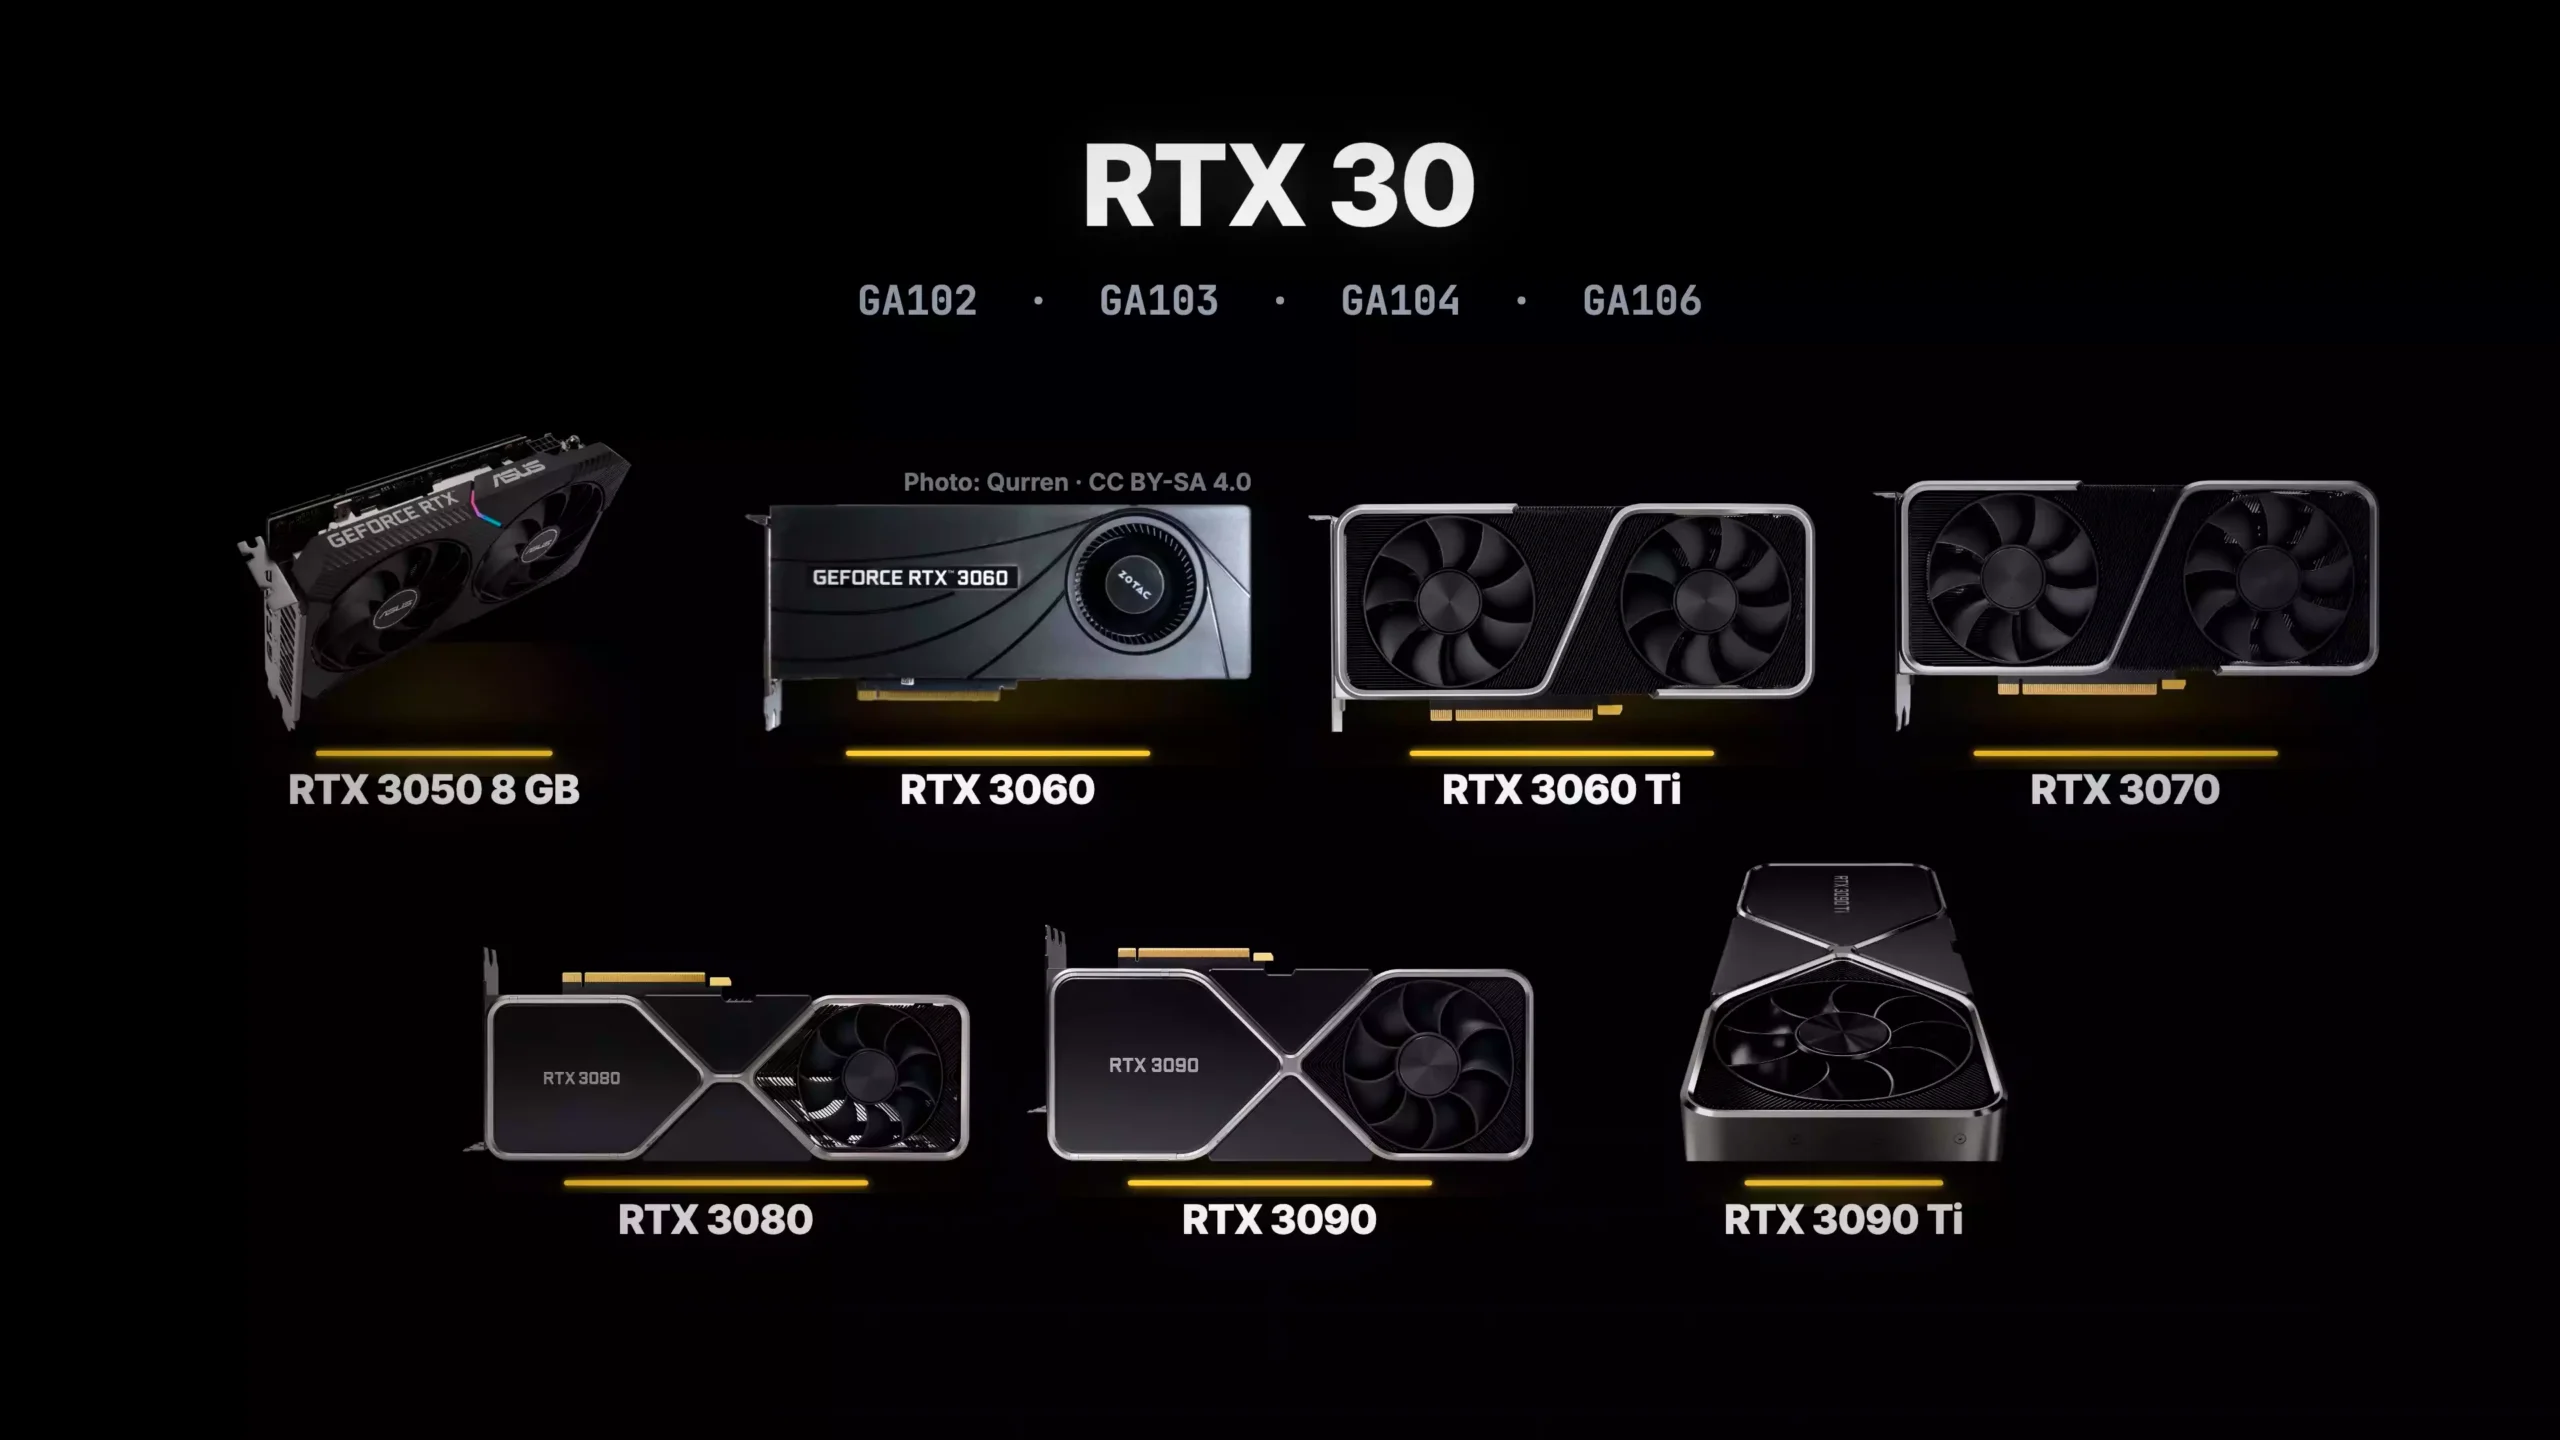
兼容性是动手之前必须先查的一张表。按项目方口径:
RTX 30 系相对稳定,是目前最适合尝试的一档;RTX 40 系和 20 系属于实验性,效果和稳定性因卡而异;RTX 50 系目前不支持,不用浪费时间试。
系统也有区别:Windows 上目前主要支持 30 系;想覆盖更广的型号,项目方更建议用 Linux。动手前最好先去项目里的兼容性报告区看一眼,有没有和你同型号、同系统的实测反馈,再决定。
实测数据怎么看:别只看百分比,要看测试条件
项目方和用户提交的实测里,有两个例子常被拿出来说:一个 BF16 的文生图模型,在 12GB 的 RTX 3060 上生成速度提升接近一半;另一个是 Qwen 3.5 9B,也有一定加速。
这两个数字可以参考,但不能直接当成自己的预期。同一张卡,模型量化方式、提示词长度、驱动版本不一样,结果都会差很多。真正靠谱的验证办法,是解锁前后用同一模型、同一设置、同一提示词各跑一遍,只比时间,不比感觉。
动手前的准备:Python 是必需的,路径选项别漏
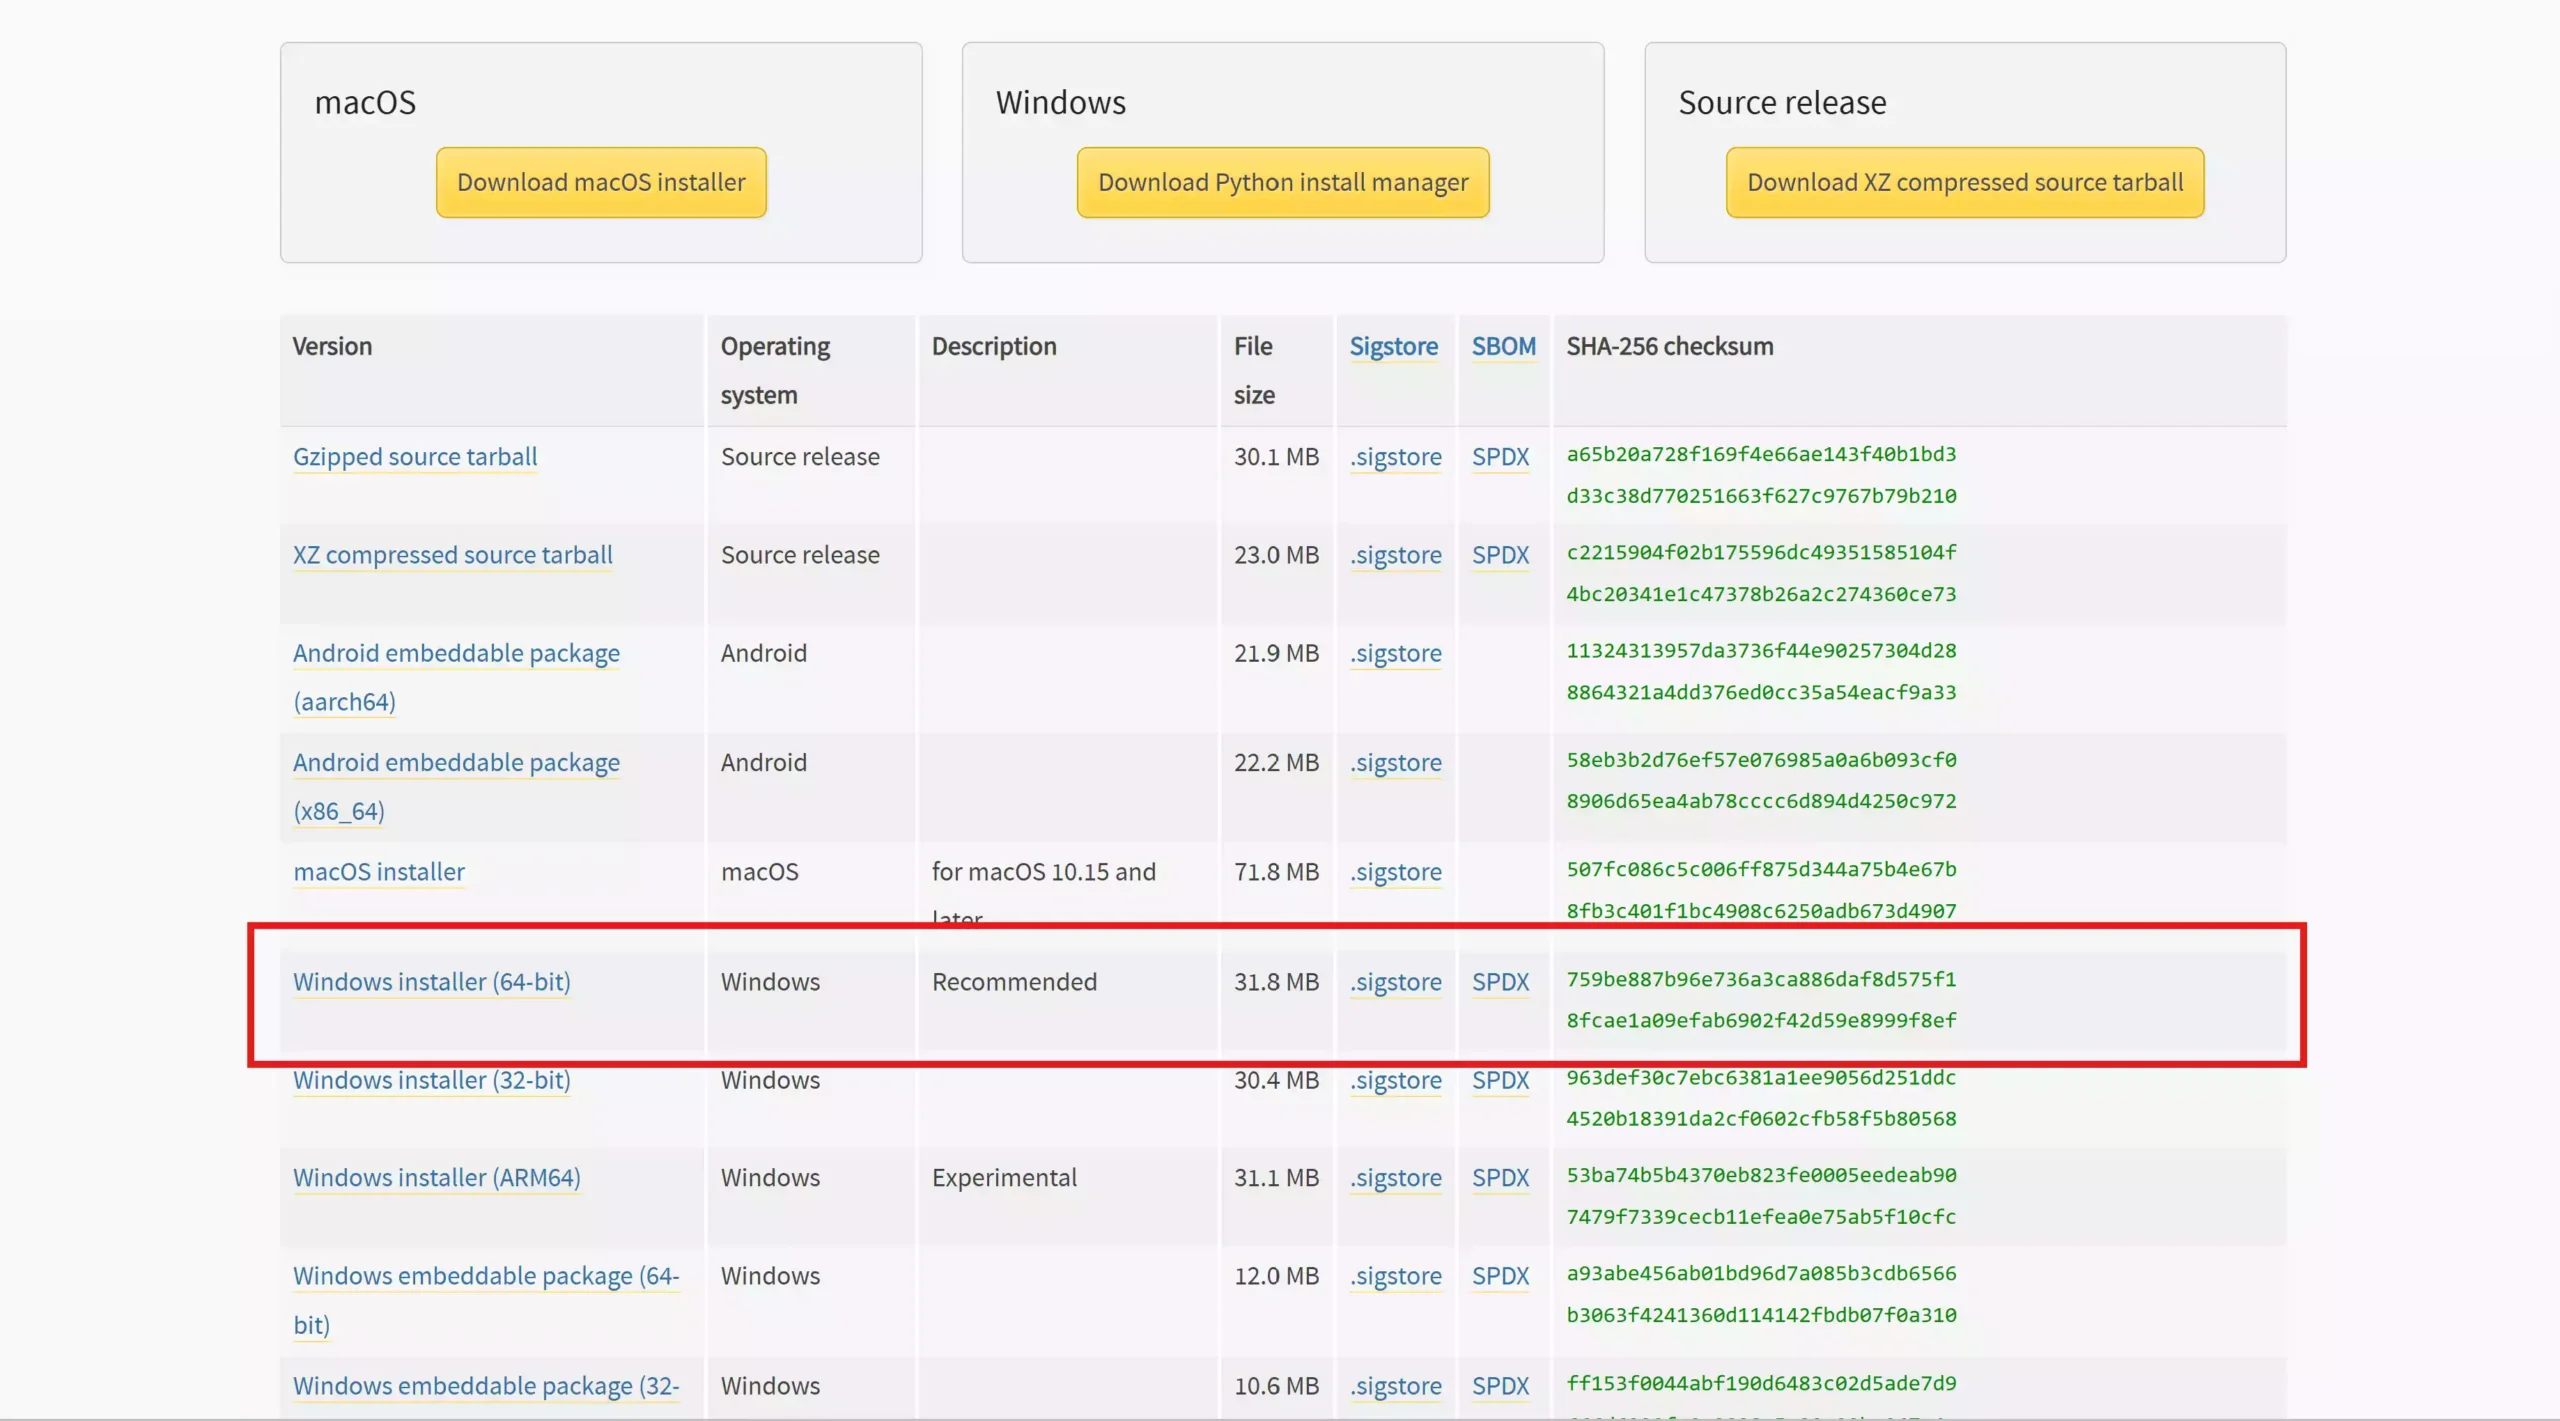
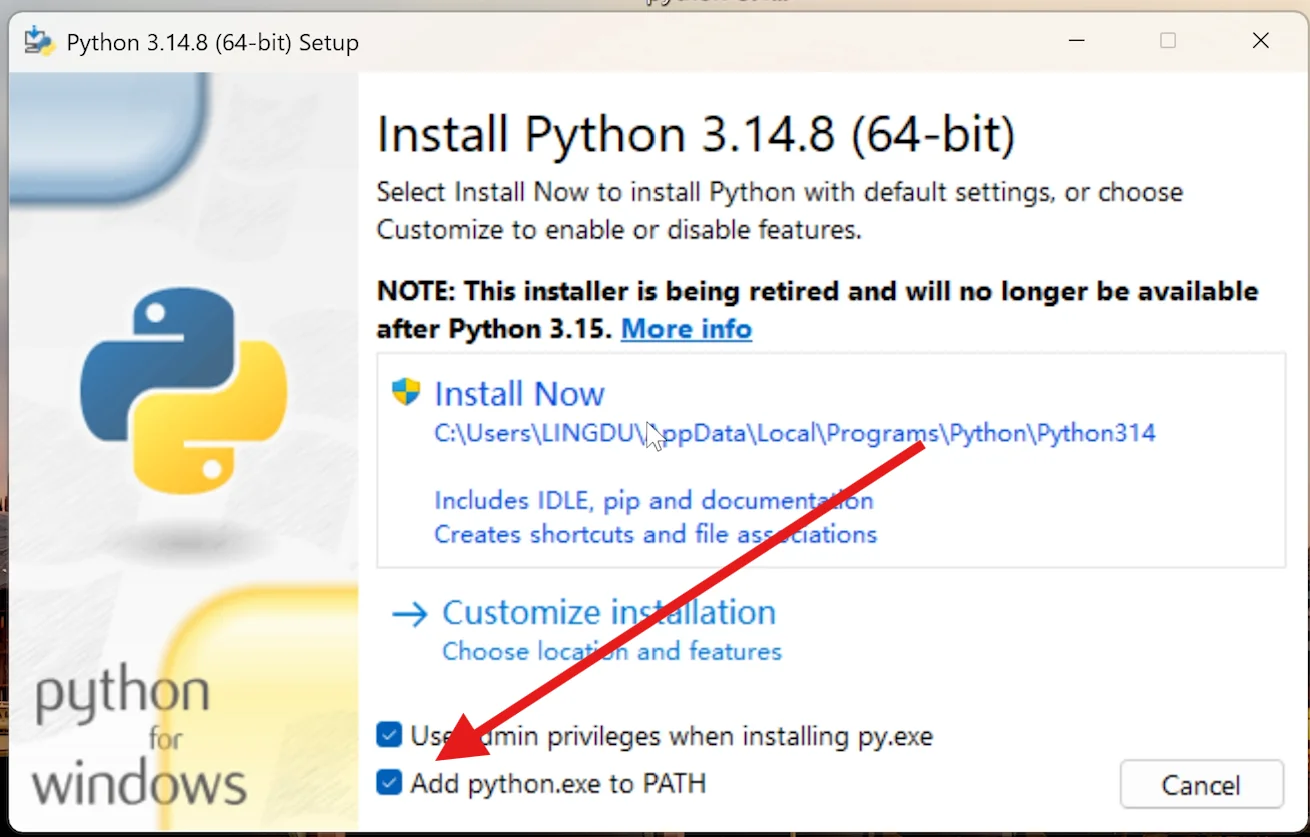
无论 Windows 还是 Linux,准备工作里都有 Python。项目方要求 Python 3.10 或更高版本,安装时务必勾选把 Python 加入系统路径的选项,否则后续步骤很容易因为找不到 Python 而报错。
可以去Python 官方下载页拿对应版本,Windows 建议选 x64 版本。
Windows 的做法:下载对应版本,解锁后重启验证
Windows 的流程相对直接:去Windows 版 GPU-UNLOCK(GitHub)下载对应版本,按项目说明完成解锁,然后重启机器,再用你平时跑的本地模型验证一次。
验证时别急着换新模型,先跑原来那个最熟悉的模型,时间、显存占用、输出质量三项一起看,确认没有异常再继续用。
Linux 的做法:多一步内核参数,改完也要重启
Linux 的版本在Linux 版 GPU-UNLOCK(GitHub)。大致顺序是:克隆项目、按说明安装,然后把需要的内核参数写进启动配置,也就是 GRUB 或 systemd-boot 那一层,保存后重启生效。
这一步是 Linux 流程里最容易出错的地方:启动配置改错可能影响正常开机。改之前先备份原配置文件,确认自己用的是 GRUB 还是 systemd-boot,别照着另一套改。
模型从哪跑:可以搭配本地部署工具一起用
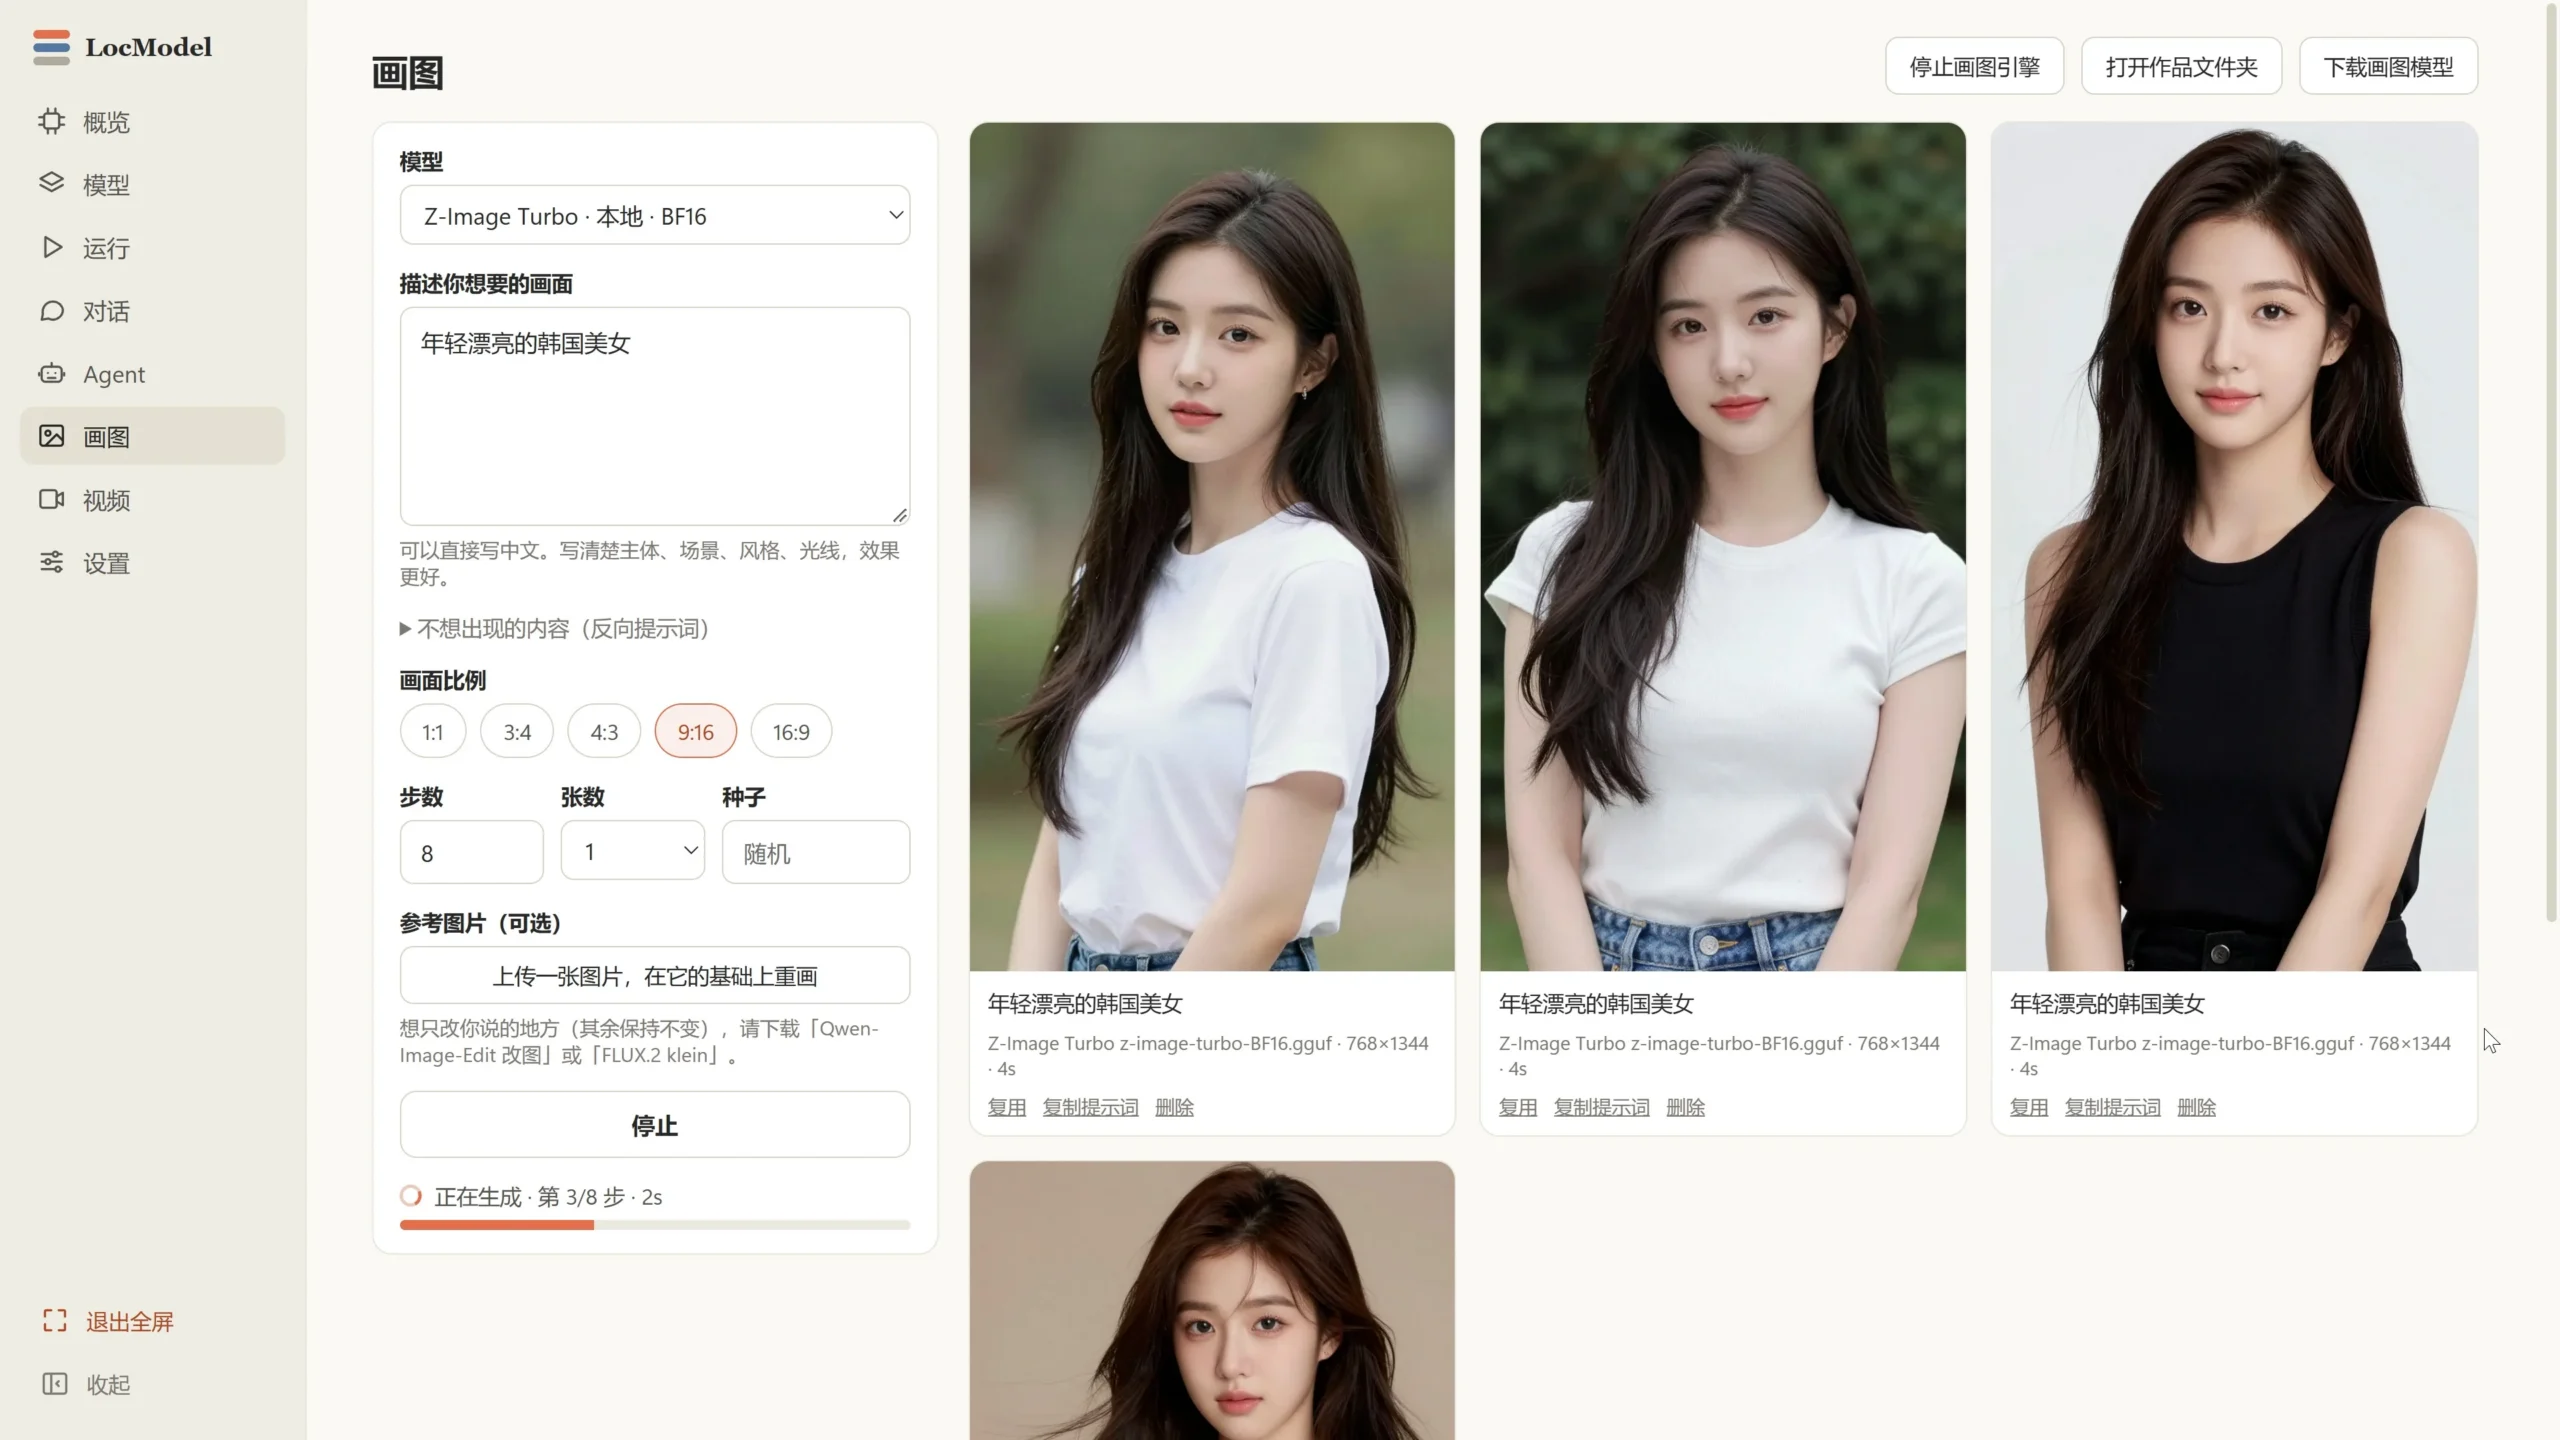
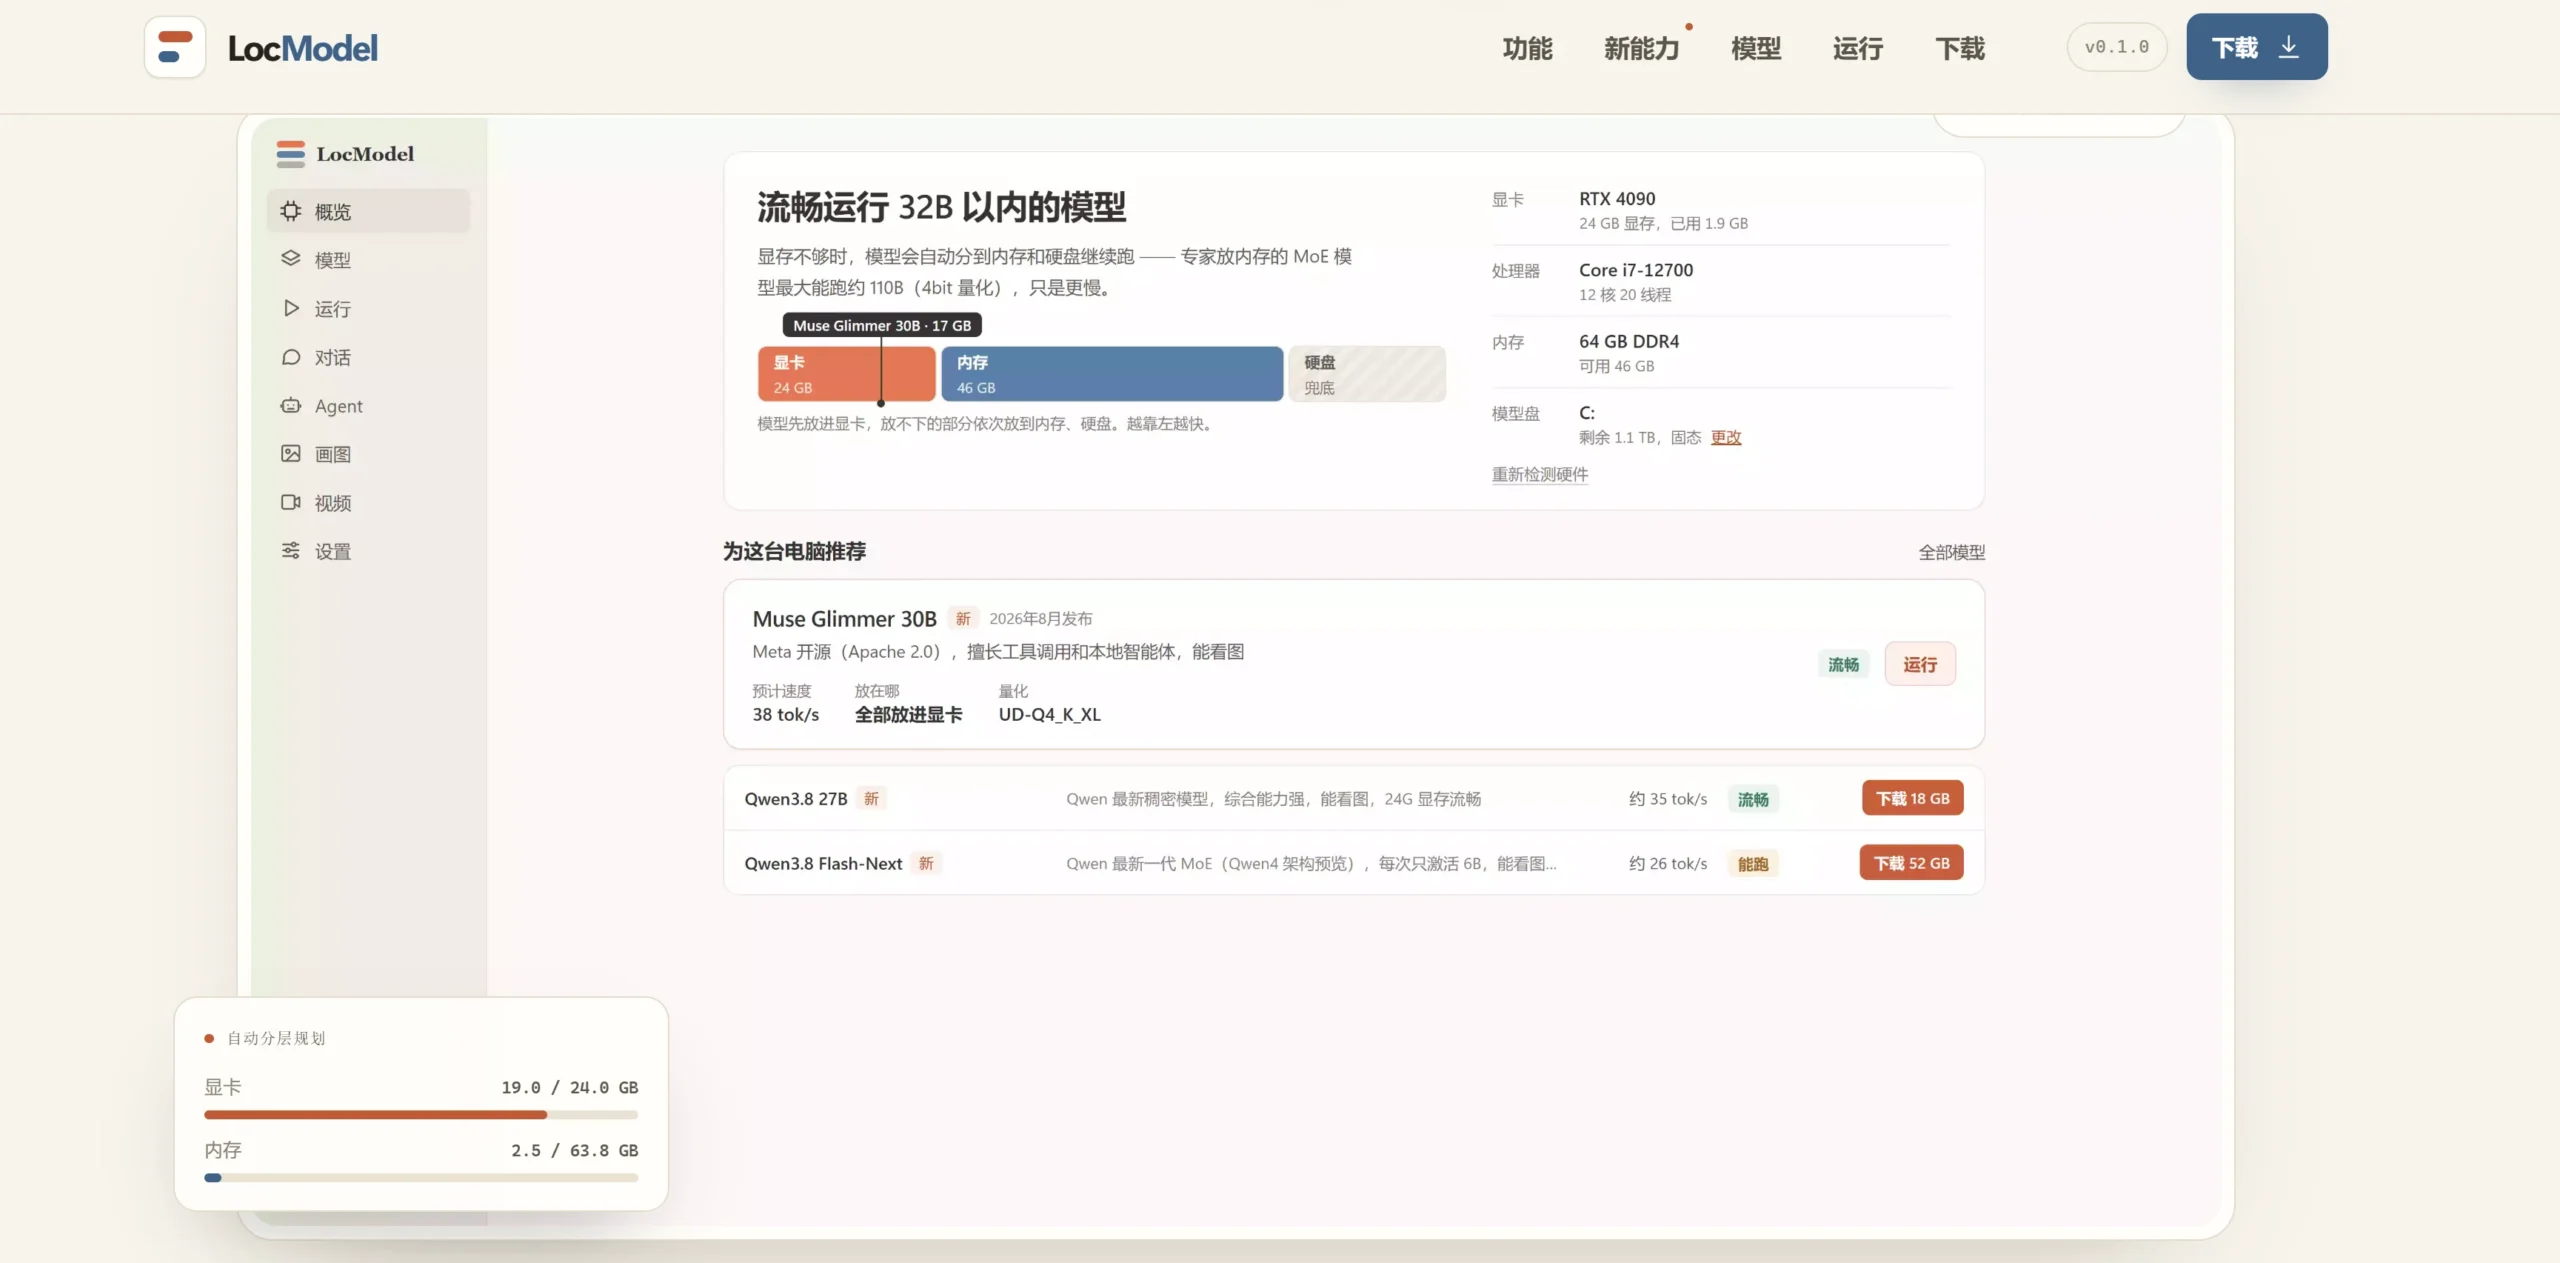
解锁本身只解决算力释放,模型还是要靠本地部署工具来跑。如果你之前用过 LocModel 这类工具,解锁之后可以直接用它加载原来的模型做对比测试,不用为了验证再搭一套新环境。
可以去LocModel 官网下载;模型方面,显存紧张的话可以先从小一点的版本起步,比如Qwen 3.5 9B GGUF 版本(Hugging Face),跑顺了再考虑更大的档位。
风险要先说清楚:这不是零成本的优化
这类工具动的是驱动和内核层面的东西,收益和风险是绑在一起的:可能不稳定、可能在驱动更新后失效、也可能在某些型号上根本没效果。建议只在非主力测试机上先试,改动前备份重要数据和启动配置,确认能还原再动手。
如果你的卡在支持列表之外,或者你平时跑的恰恰是它提速不了的那几类运算,那不折腾反而是更省时间的决定。显卡没换就想变快可以理解,但先看清提速边界,比先动手更重要。
更多同型号的实测和问题反馈,可以去GPU-UNLOCK 兼容性报告(GitHub)查。