Inkling 2 Mini 开源了:26.4B 参数塞进 16GB 显存,本地跑编程 Agent 够不够用?
11 月 20 日,Mira Murati 的 Thinking Machines Lab 放出了新开源模型 Inkling 2 Mini。上线 24 小时,Hugging Face 上的下载量就超过了 23 万次——这个数字是发布方自己报的,热度确实不低。
先说最抓人的一点:它总参数 26.4B,却是 MoE 架构,单次推理只激活 34 亿参数,再加上循环 Transformer——同一组参数多跑几轮循环计算来提推理能力。账面上的意思就是:参数规模不小,实际吃掉的算力没那么夸张,普通消费级显卡有机会在本地把它跑起来。
官方评测:13 项里 10 项赢了 Qwen3.8-27B
按官方公布的数据,Inkling 2 Mini 在 13 项主流基准里有 10 项超过了同规模的 Qwen3.8-27B 稠密模型。几个跟写代码和 Agent 直接相关的数:
- SWE-bench Verified:79.2%
- Vibe Code Bench:77.9%
- DeepSearchQA:85.3%
- MCP Atlas 工具调用:82.7%
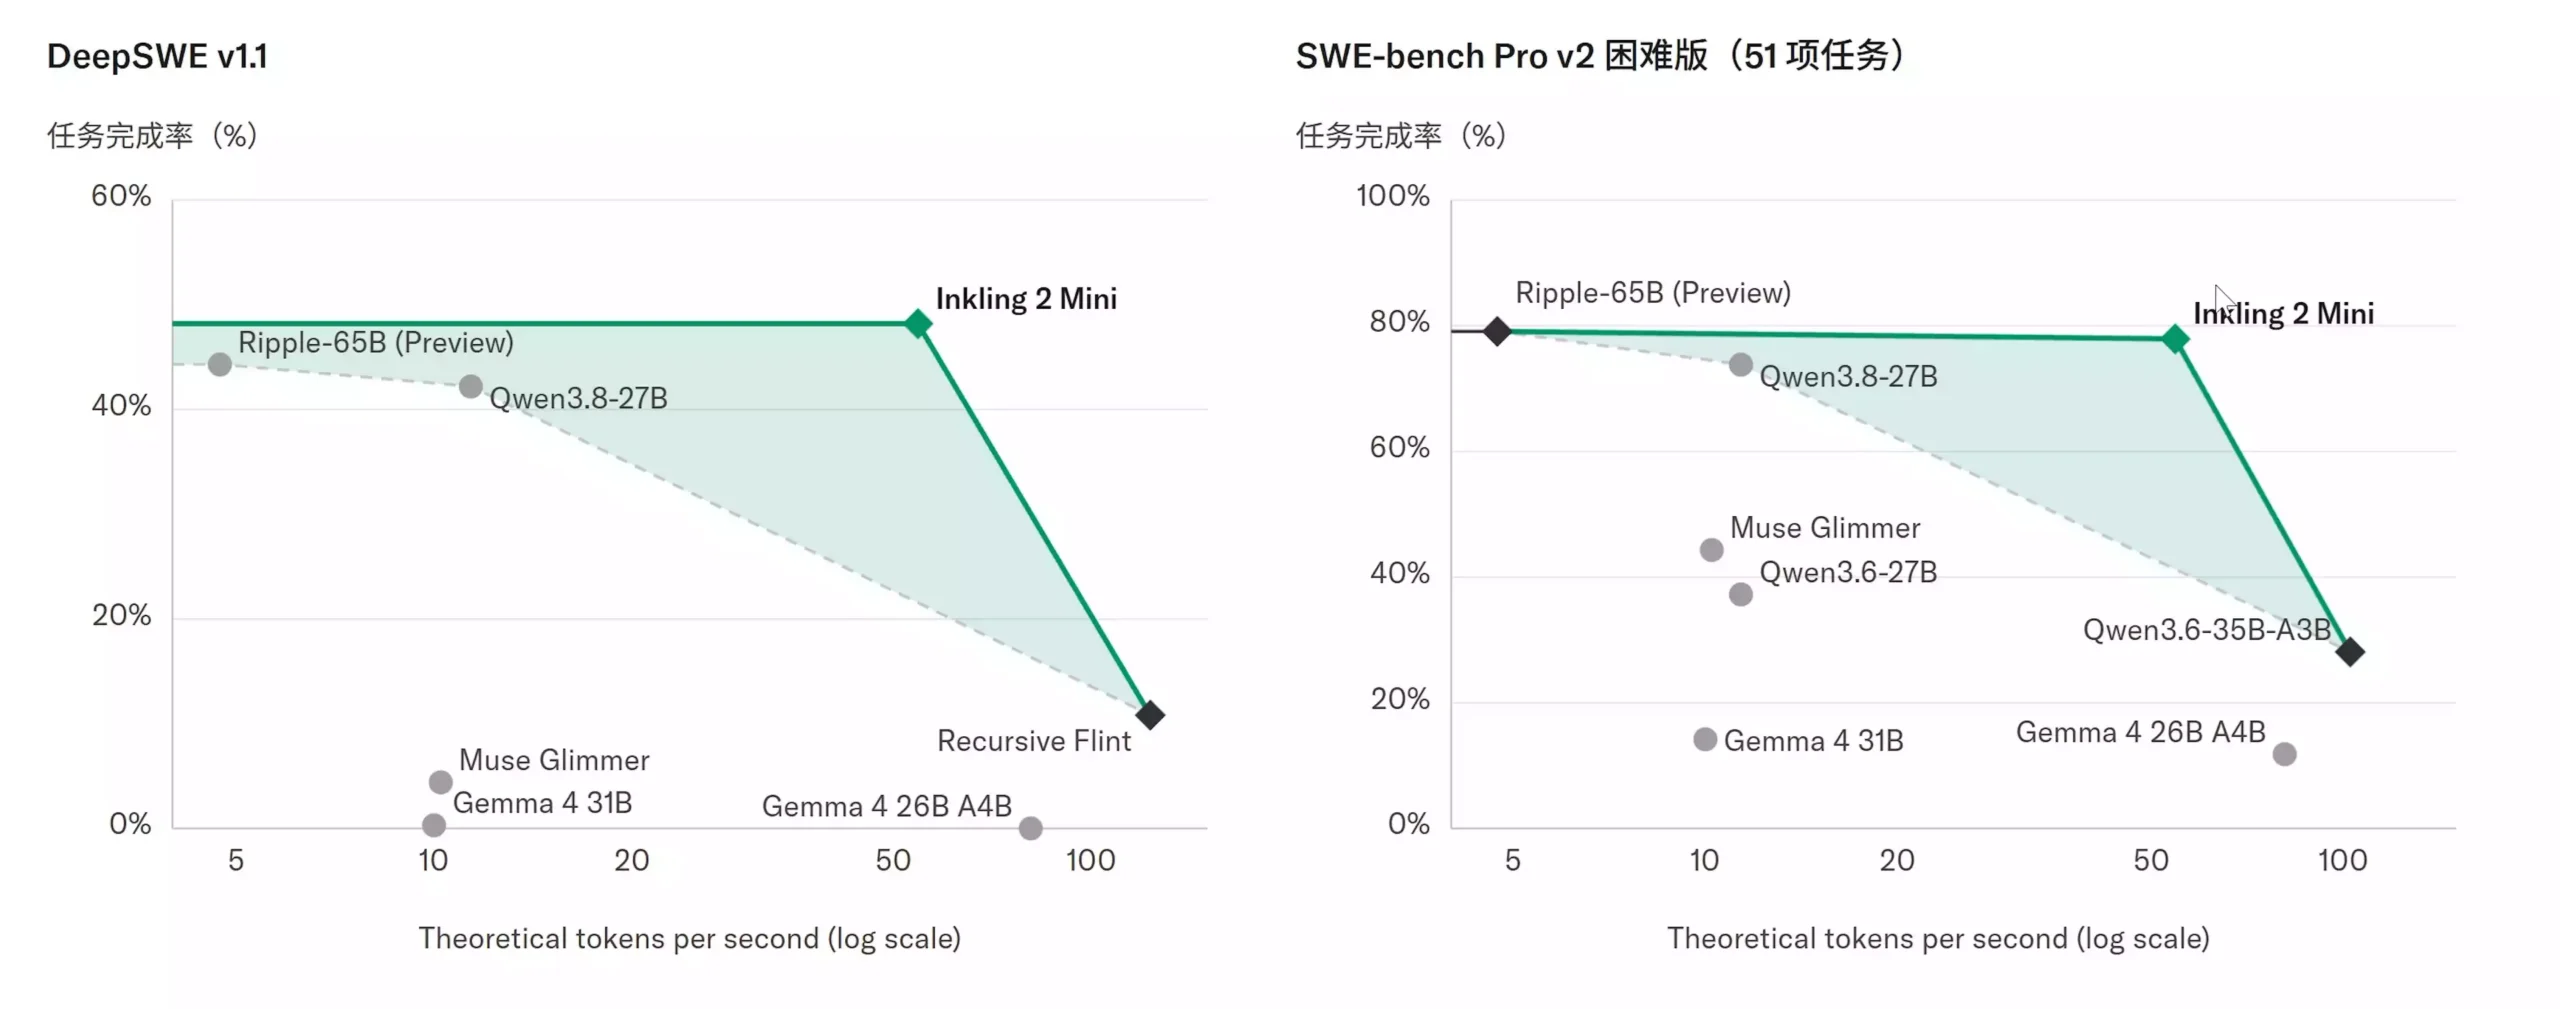
官方还放了两张对比图。左边 DeepSWE v1.1、右边 SWE-bench Pro v2 困难版(51 项任务),横轴是理论每秒 token 数——Inkling 2 Mini 在两张图里都压过了 Qwen3.8-27B,跟 65B 的 Ripple 预览版打得有来有回,而 Gemma 4 那几款同量级模型则被甩在后面。
先打个预防针:这些都是官方口径的评测,榜单成绩好看不等于你家电脑上就一定顺手。真正有参考价值的,是下面这种拿它干活的实测。
模型本身是 Apache 2.0 协议开源,社区已经做了 GGUF 量化版本,方便本地部署。
本地部署:模型从哪拿,量化版本怎么挑
模型在 Hugging Face 上免费下载。社区做的 GGUF 版在Unsloth 的 Inkling-2-Mini-GGUF 仓库,其中主线版(Mainline_Support)是常规选择;同一个仓库里也有多模态版本。
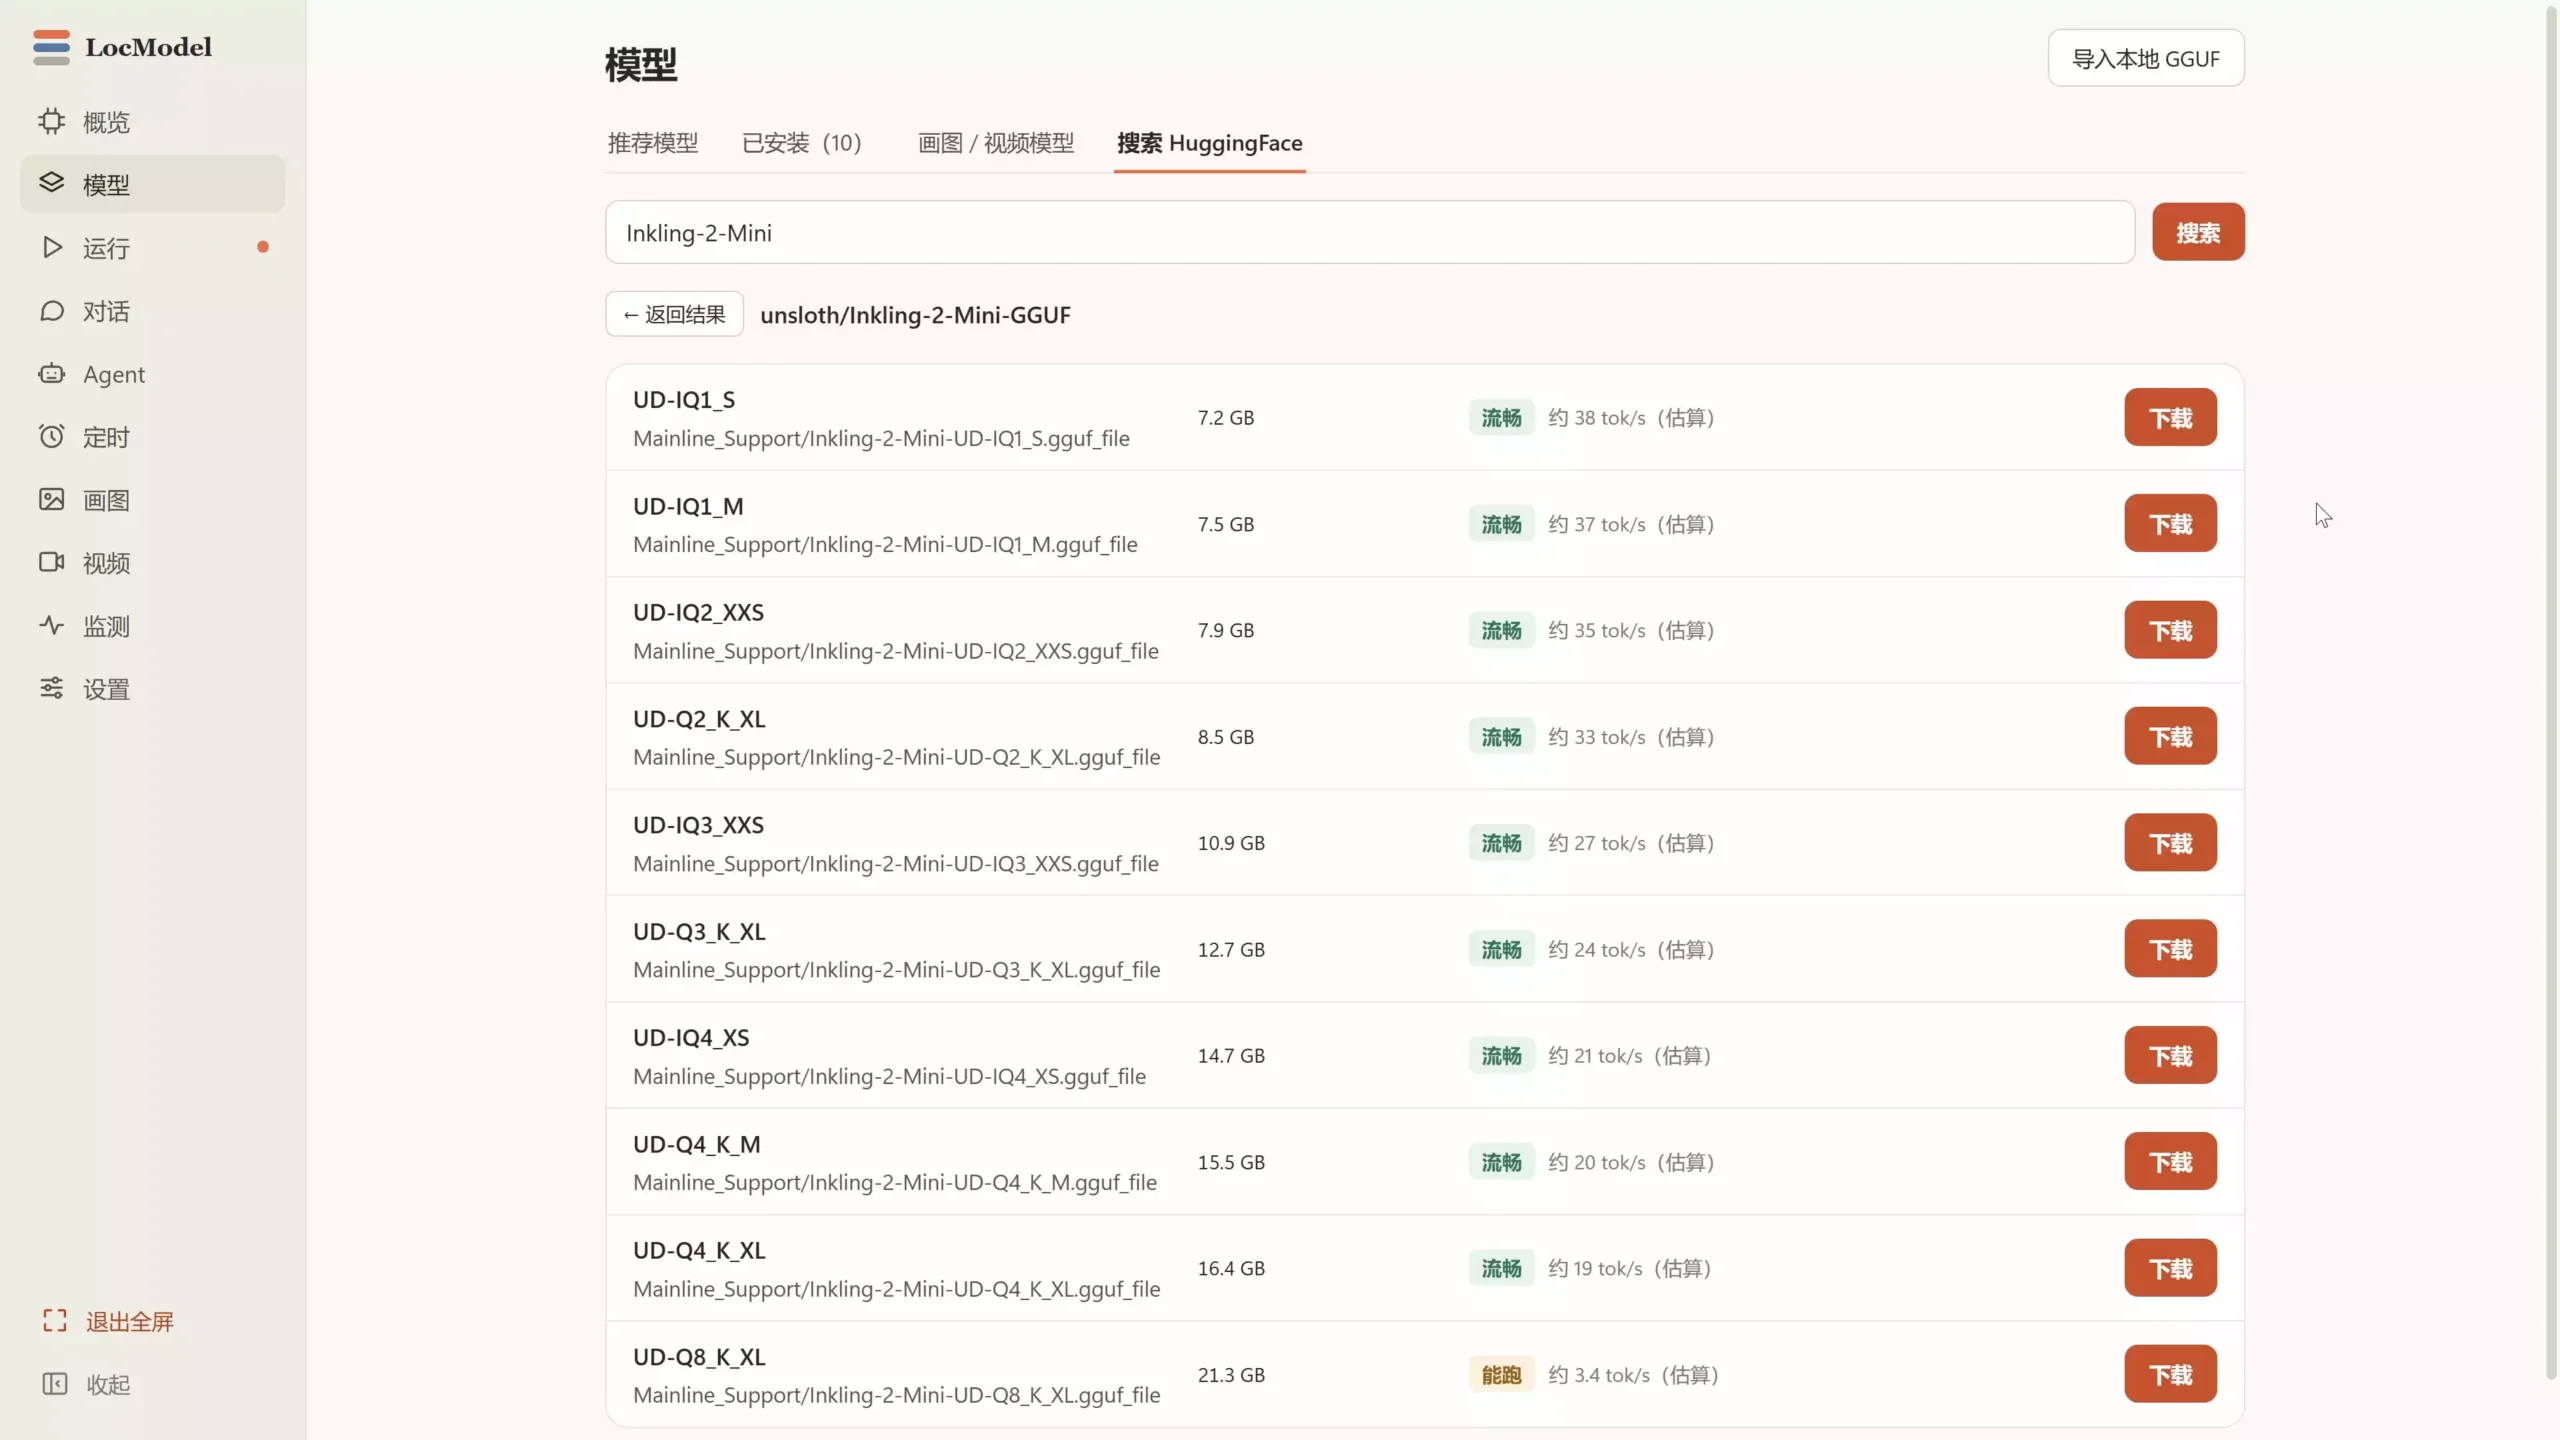
量化版本直接决定显存占用和速度。在 LocModel 里搜这个模型,能看到一排量化文件和软件给出的估算:
- UD-IQ1_S:约 7.2GB,估算约 38 tok/s
- UD-IQ2_XXS:约 7.9GB,估算约 35 tok/s
- UD-Q2_K_XL:约 8.5GB,估算约 33 tok/s
- UD-IQ3_XXS:约 10.9GB,估算约 27 tok/s
- UD-Q3_K_XL:约 12.7GB,估算约 24 tok/s
- UD-IQ4_XS:约 14.7GB,估算约 21 tok/s
- UD-Q4_K_M:约 15.5GB,估算约 20 tok/s
- UD-Q4_K_XL:约 16.4GB,估算约 19 tok/s
- UD-Q8_K_XL:约 21.3GB,估算约 3.4 tok/s
“16GB 显存就能跑”这个说法,对应的就是上面这些中低量化版本——量化越狠,文件越小、速度估算越高,但精度也会跟着掉。自己按显卡显存挑,别无脑上最高精度那档。上面这些速度都是 LocModel 界面里的估算值,实际表现跟你的硬件有关。
加载模型的工具,看顺手就行。开源的 Ollama、llama.cpp 都能跑,想省事就用一键部署工具 LocModel:去LocModel 官网下载安装,模型可以从 Hugging Face 在线搜着下载,也能把下好的 GGUF 文件直接导入。提醒一句:在线下载走的是 Hugging Face,国内网络可能需要自己解决访问问题。
代码能力实测:一个提示词,要一个完整 FPS 游戏
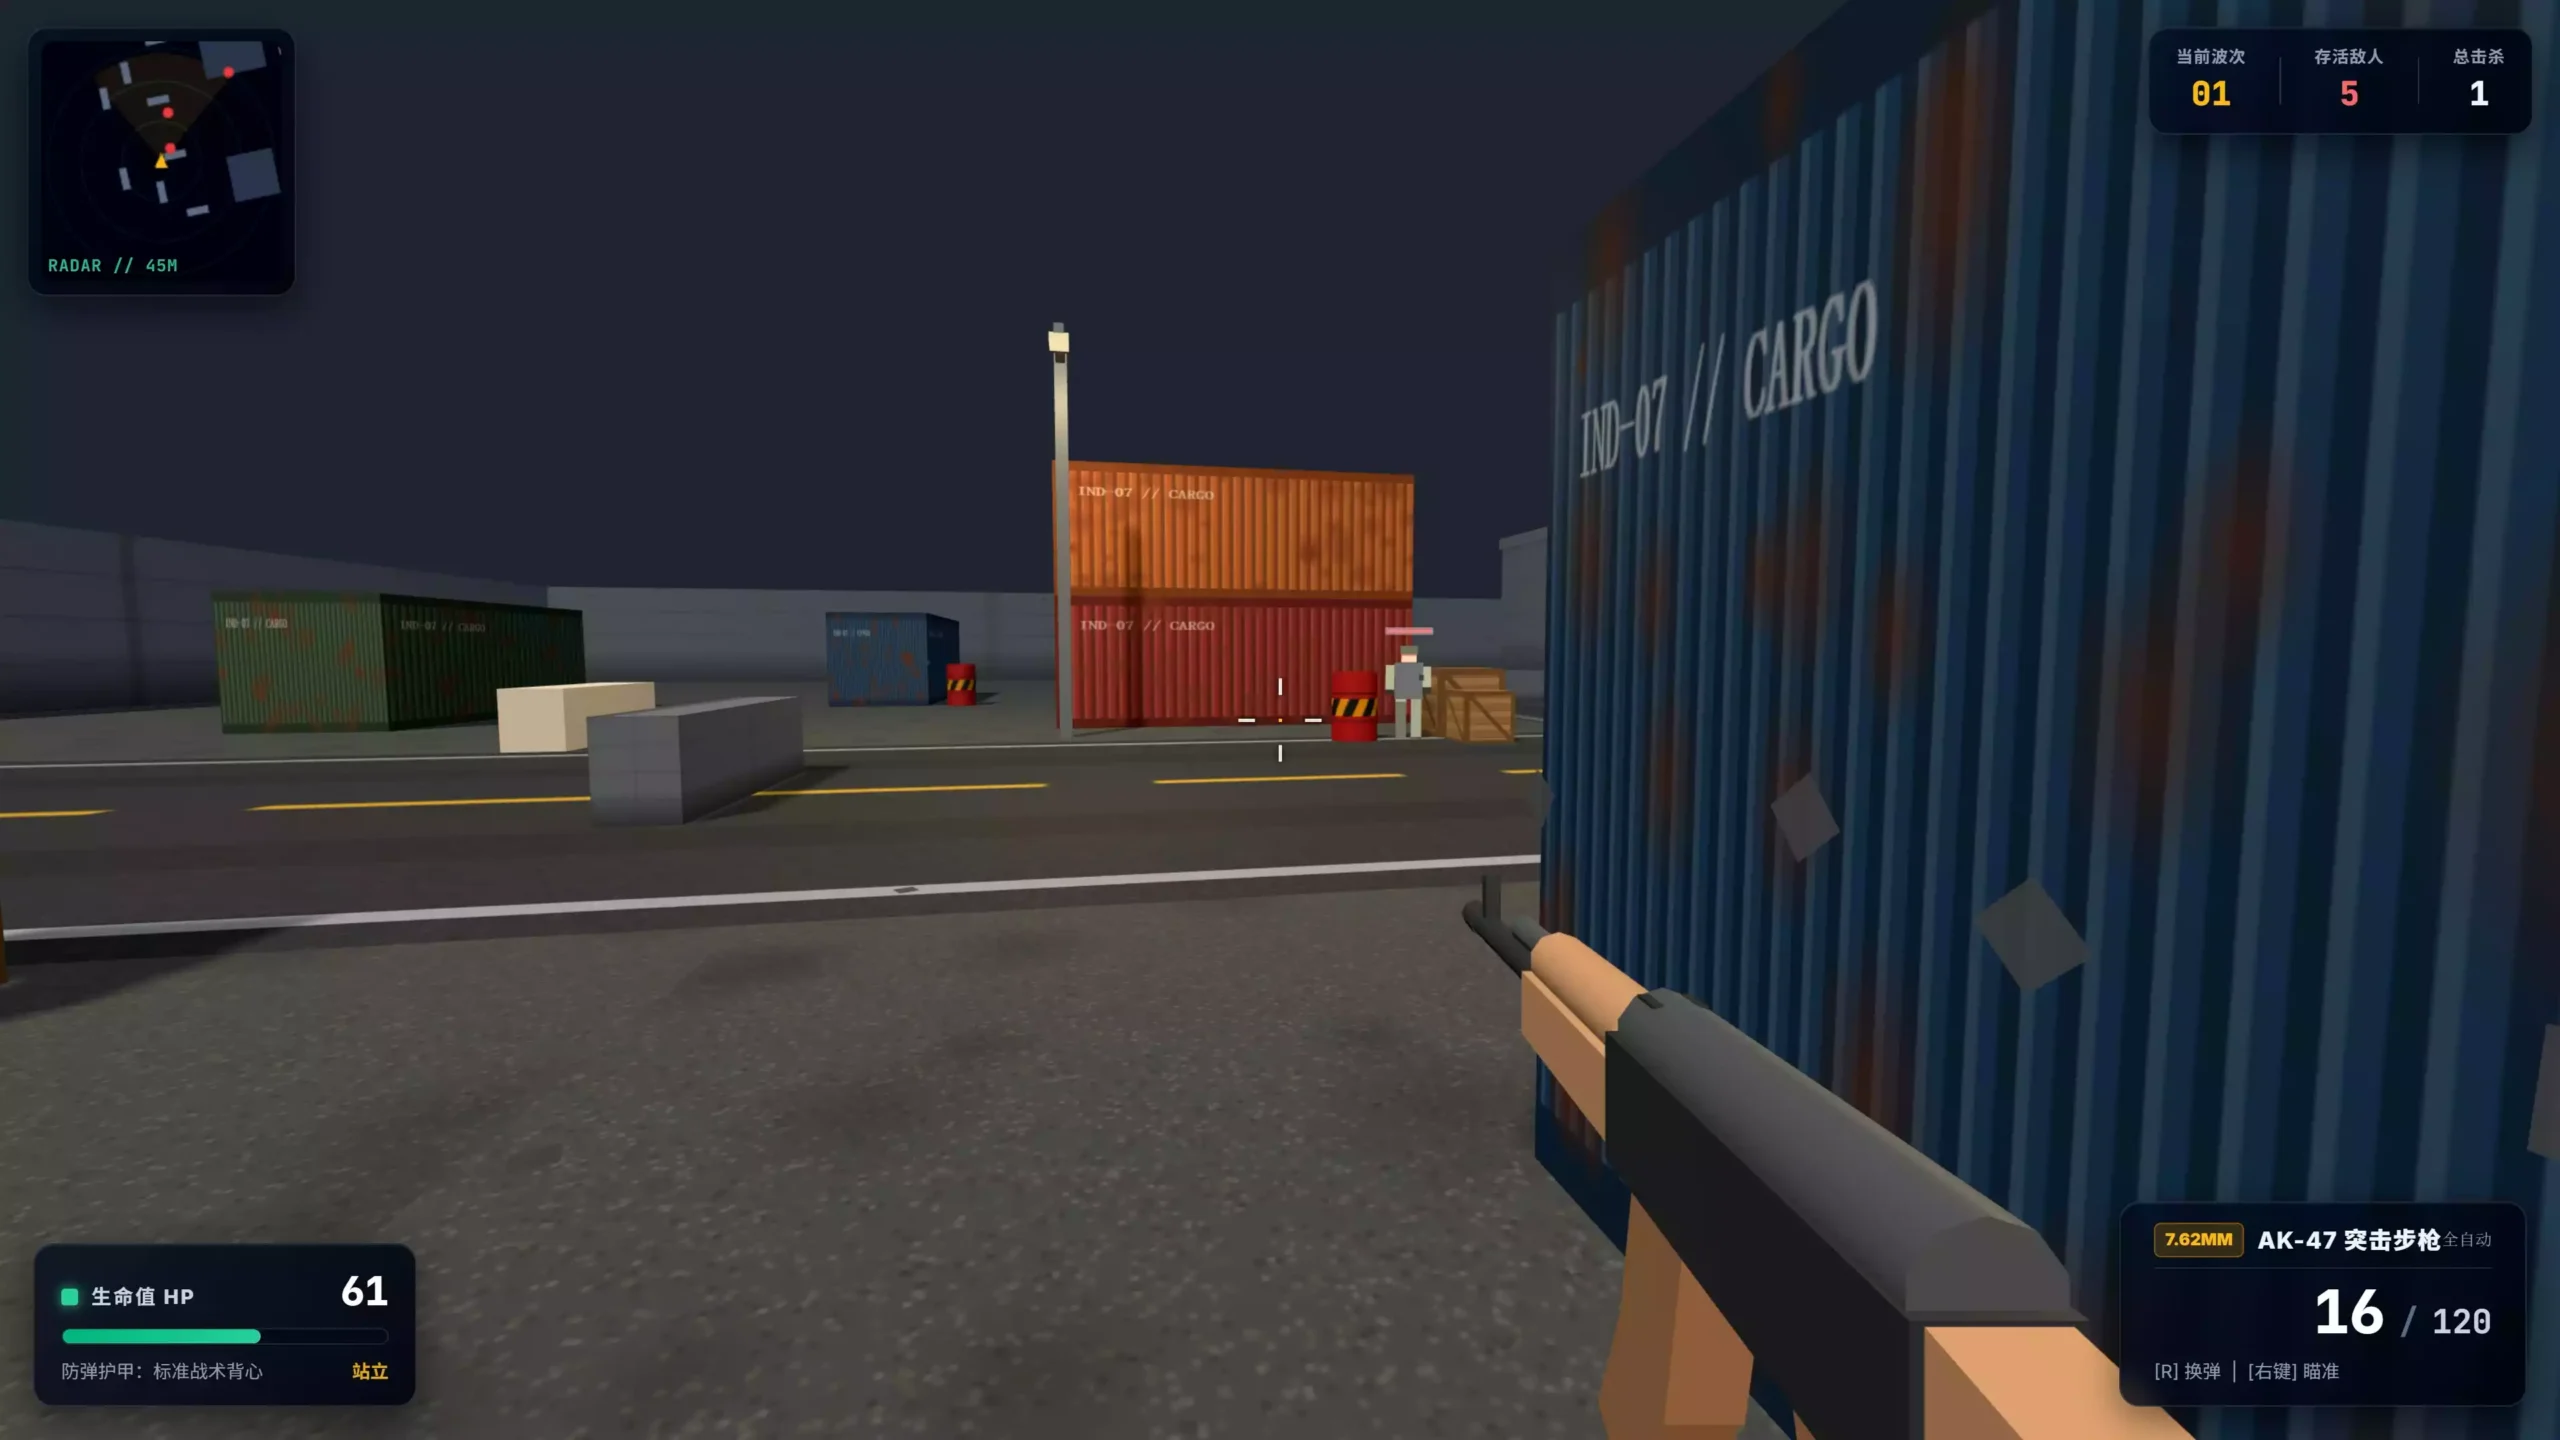
实测分两块。第一块是代码能力:让模型用 Three.js 写一个完整的 3D 第一人称 FPS 射击游戏,要求一次给全——现代废弃工业园区的场景、WASD 移动加鼠标视角、AK47 的射击动画和音效、会巡逻追击的敌人 AI、子弹碰撞和 HUD,一个 HTML 文件直接能跑。
结果是能跑起来的。LocModel 界面里这次生成的记录是 11566 个 token、56.7 tok/s,单次生成上万 token 还能保持这个速度,对本地跑的模型来说算利索的——当然这只是这一次的记录,不同硬件、不同量化版本,速度会差不少。
下面这张就是生成出来的游戏实机画面:小雷达、波次和击杀数、生命值、弹药数都在 HUD 上,集装箱场景也有模有样。
Agent 能力实测:让它在 Blender 里从零造一艘飞船
第二块更有意思:Agent 工具调用。LocModel 支持接 MCP 服务,让模型直接操作本地软件,这次拿 Blender 做演示。
接线分三步,都是只做一次的事:
1. 装 uv:MCP 配置里的 uvx 是 uv 自带的命令,用它自动下载并运行 blender-mcp。在 PowerShell 里跑一键安装脚本,装完重启 LocModel,不然程序找不到 uvx。
2. 在 Blender 里装 blender-mcp 插件:去blender-mcp 项目(GitHub)下载 addon.py。Blender 4.2 及以上在“编辑 → 偏好设置 → 获取扩展”里从磁盘安装,旧版在“插件”页安装,然后在插件列表勾选启用。
3. 每次使用前先在 Blender 里连上:3D 视图按 N 打开右侧边栏,找到 BlenderMCP 标签页,点连接。这一步要在 LocModel 连接之前做,Blender 关了就要重新点。
然后回到 LocModel 的 MCP 服务面板,保存并连接。第一次连接时 uvx 要下载 blender-mcp,会慢一点。面板里能看到 Blender 服务显示已连接,10 个工具可用。
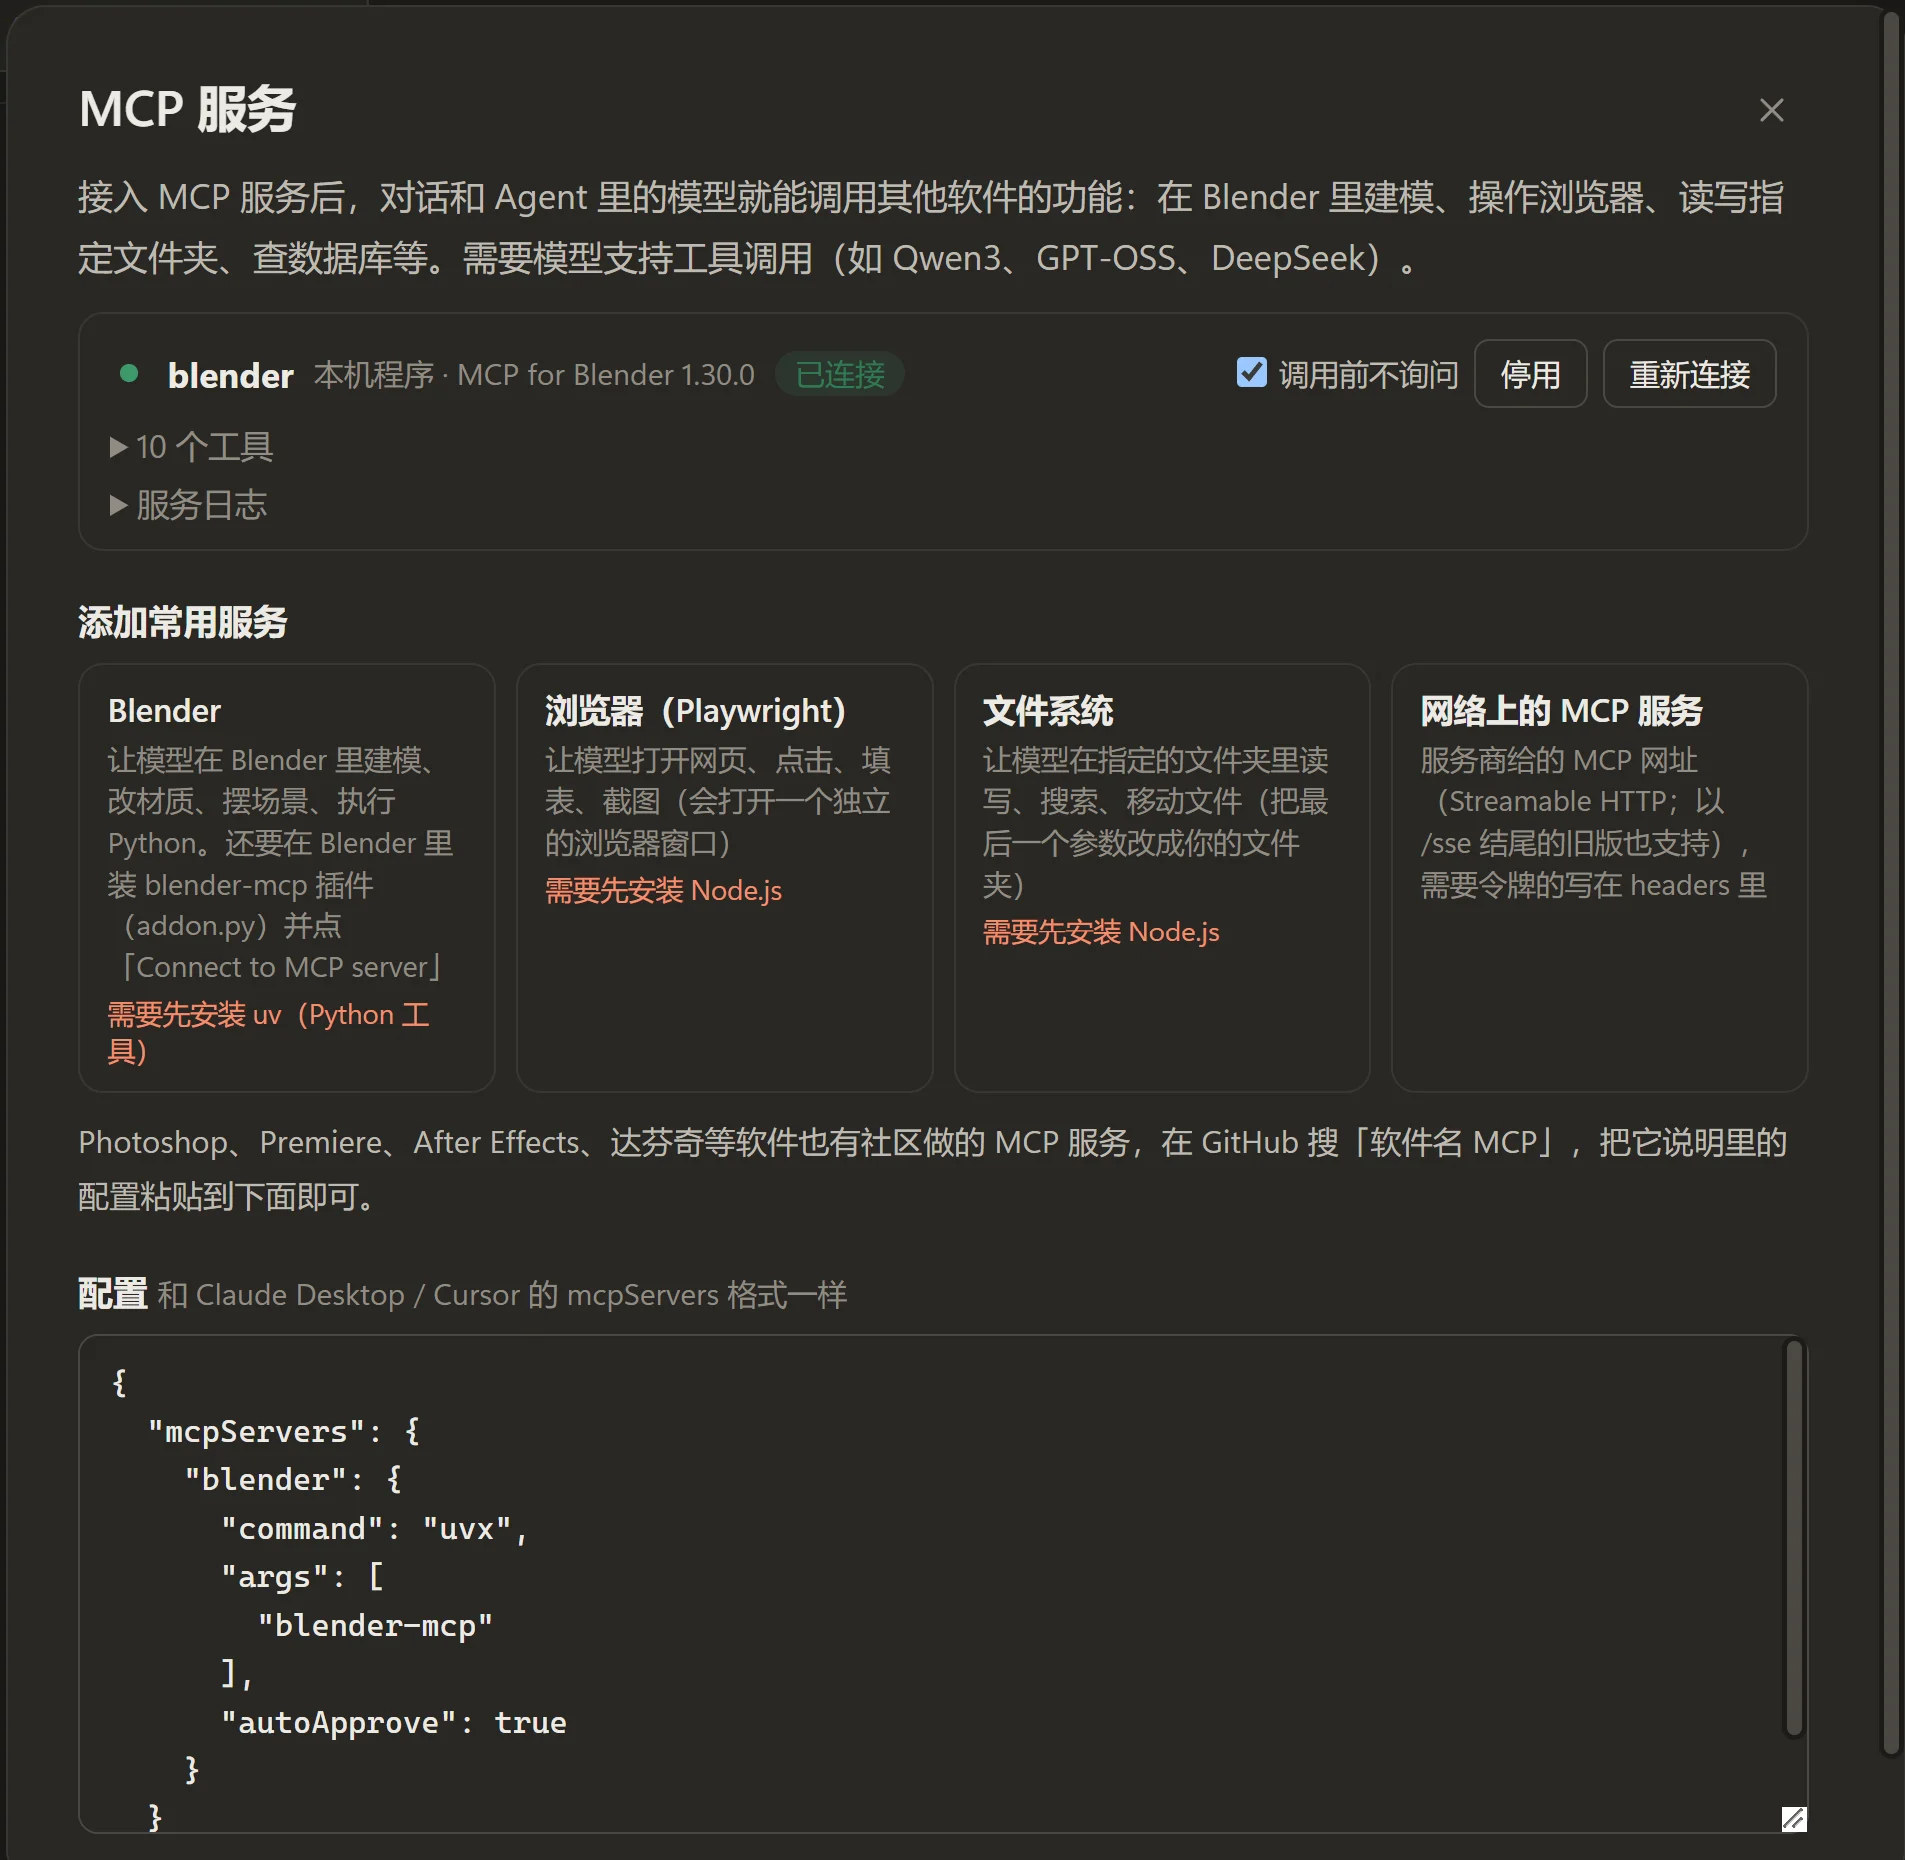
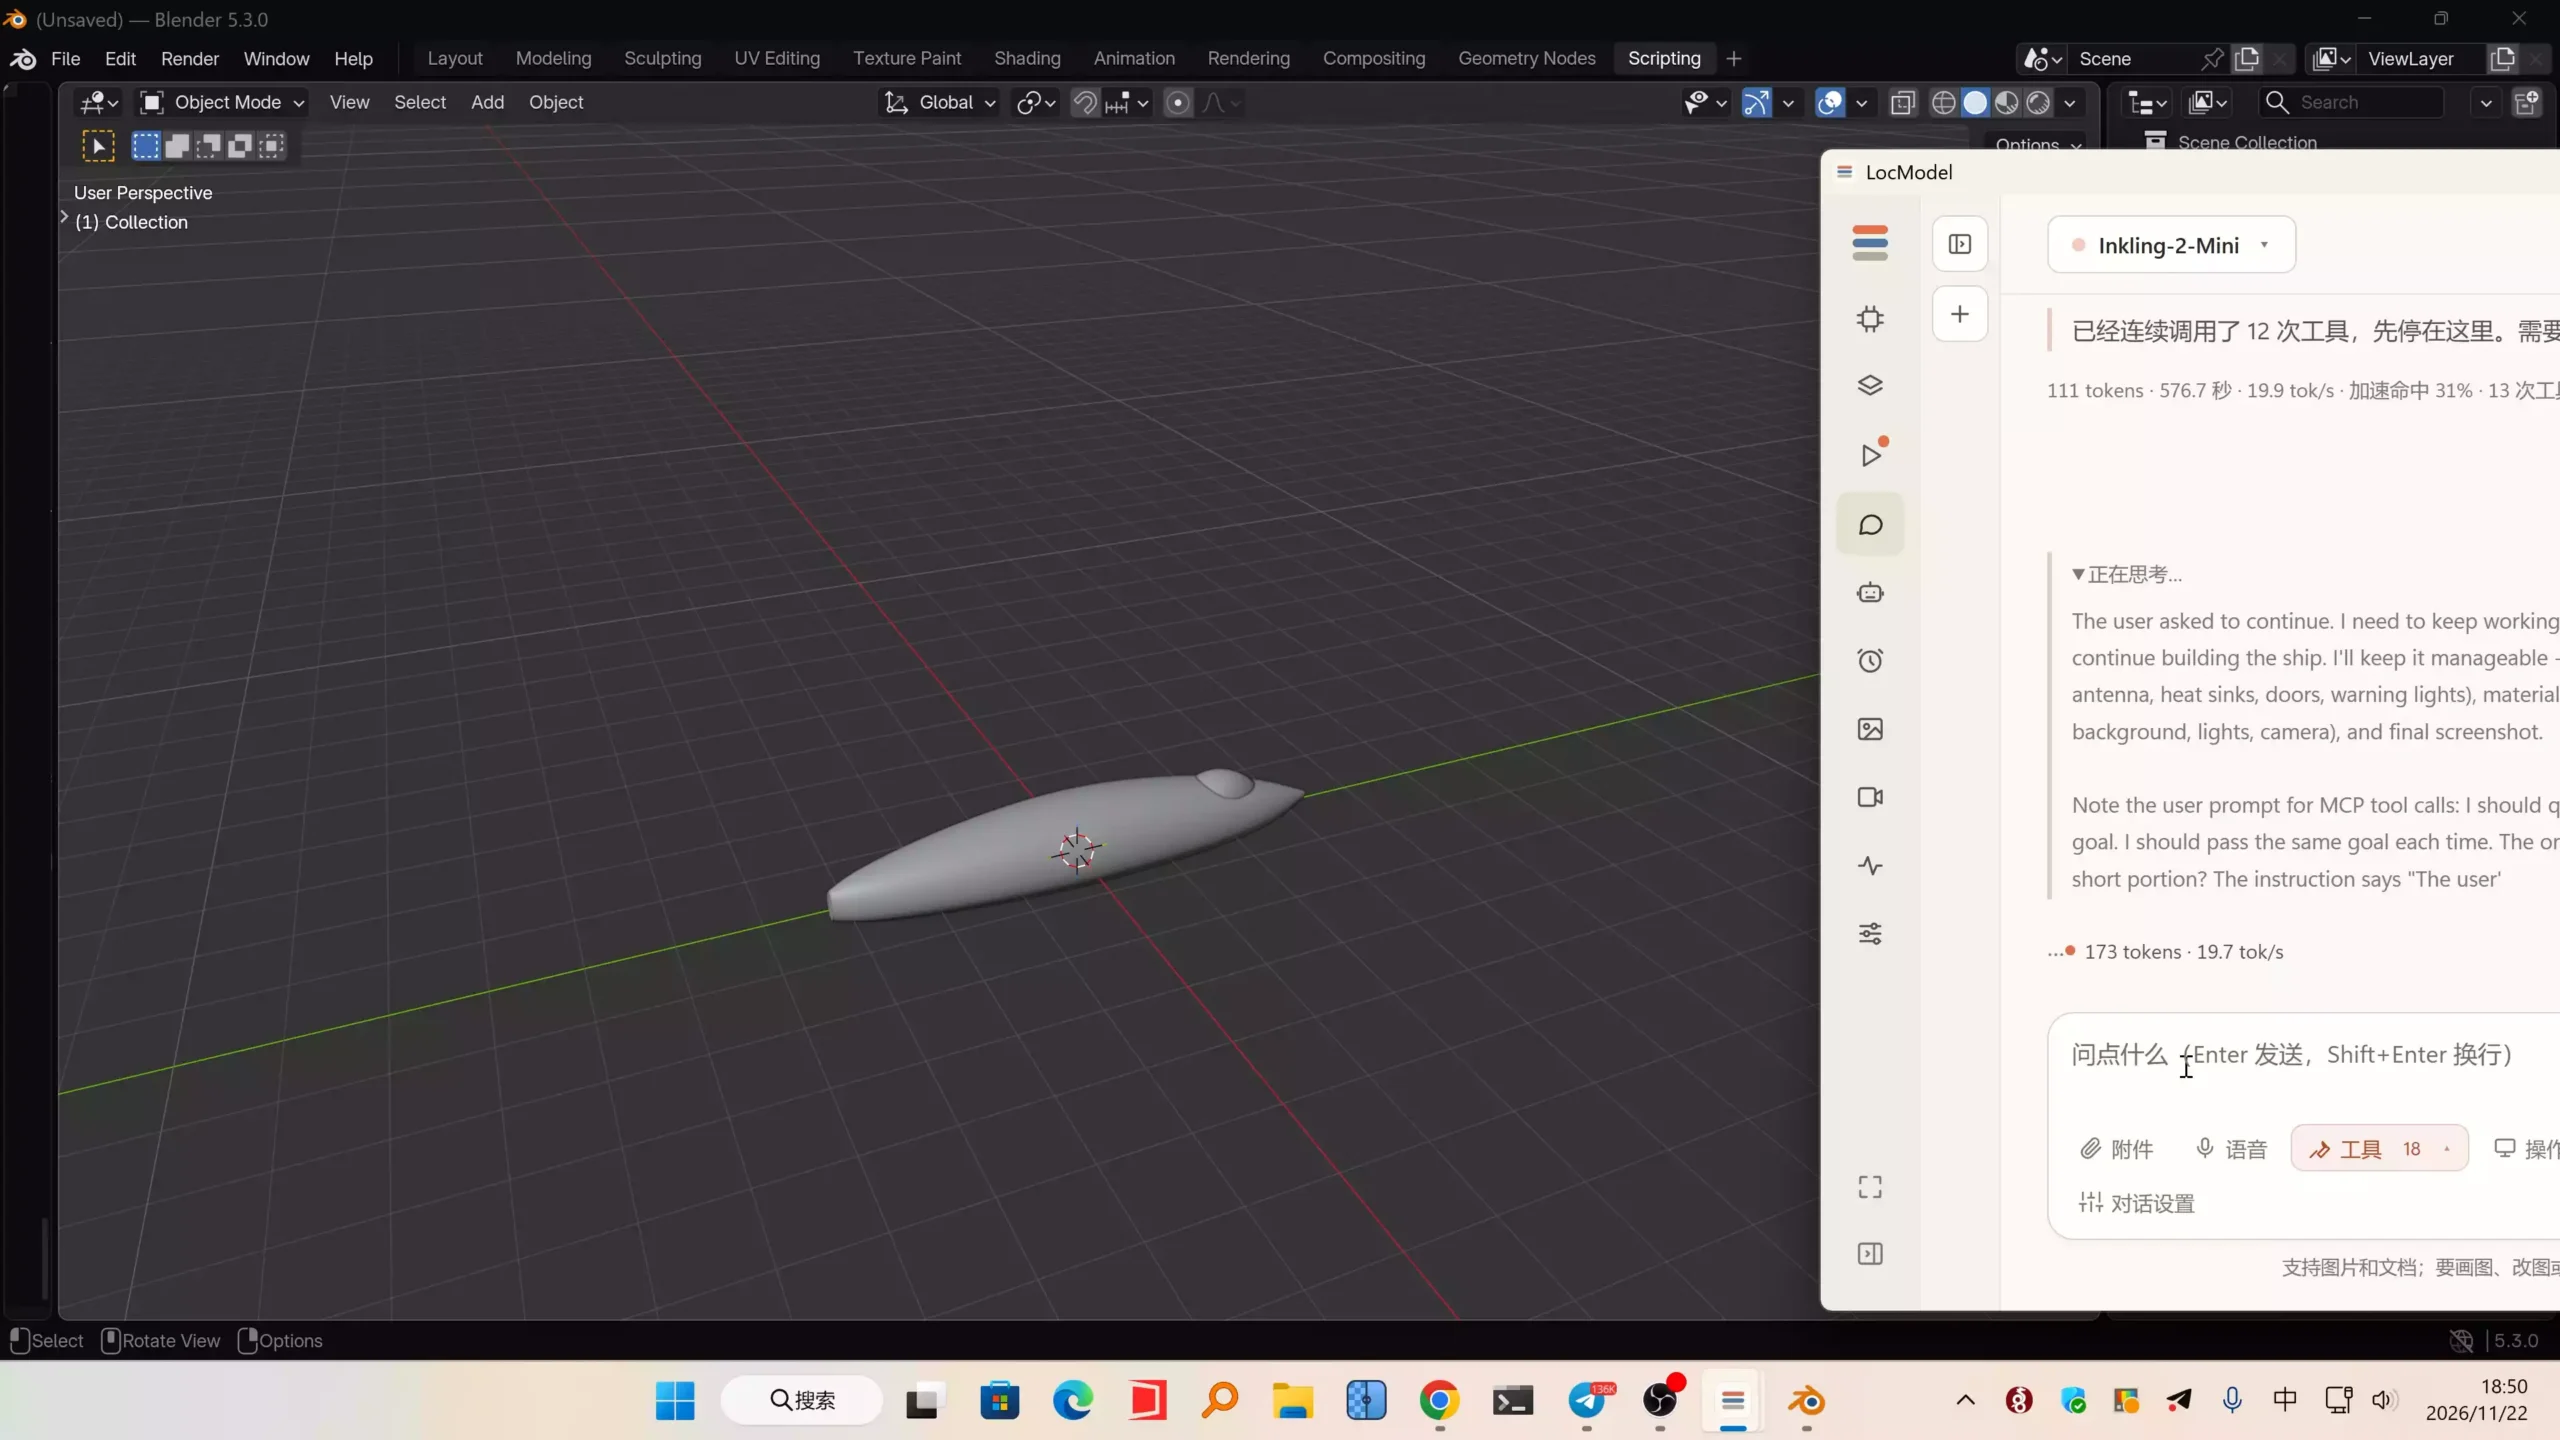
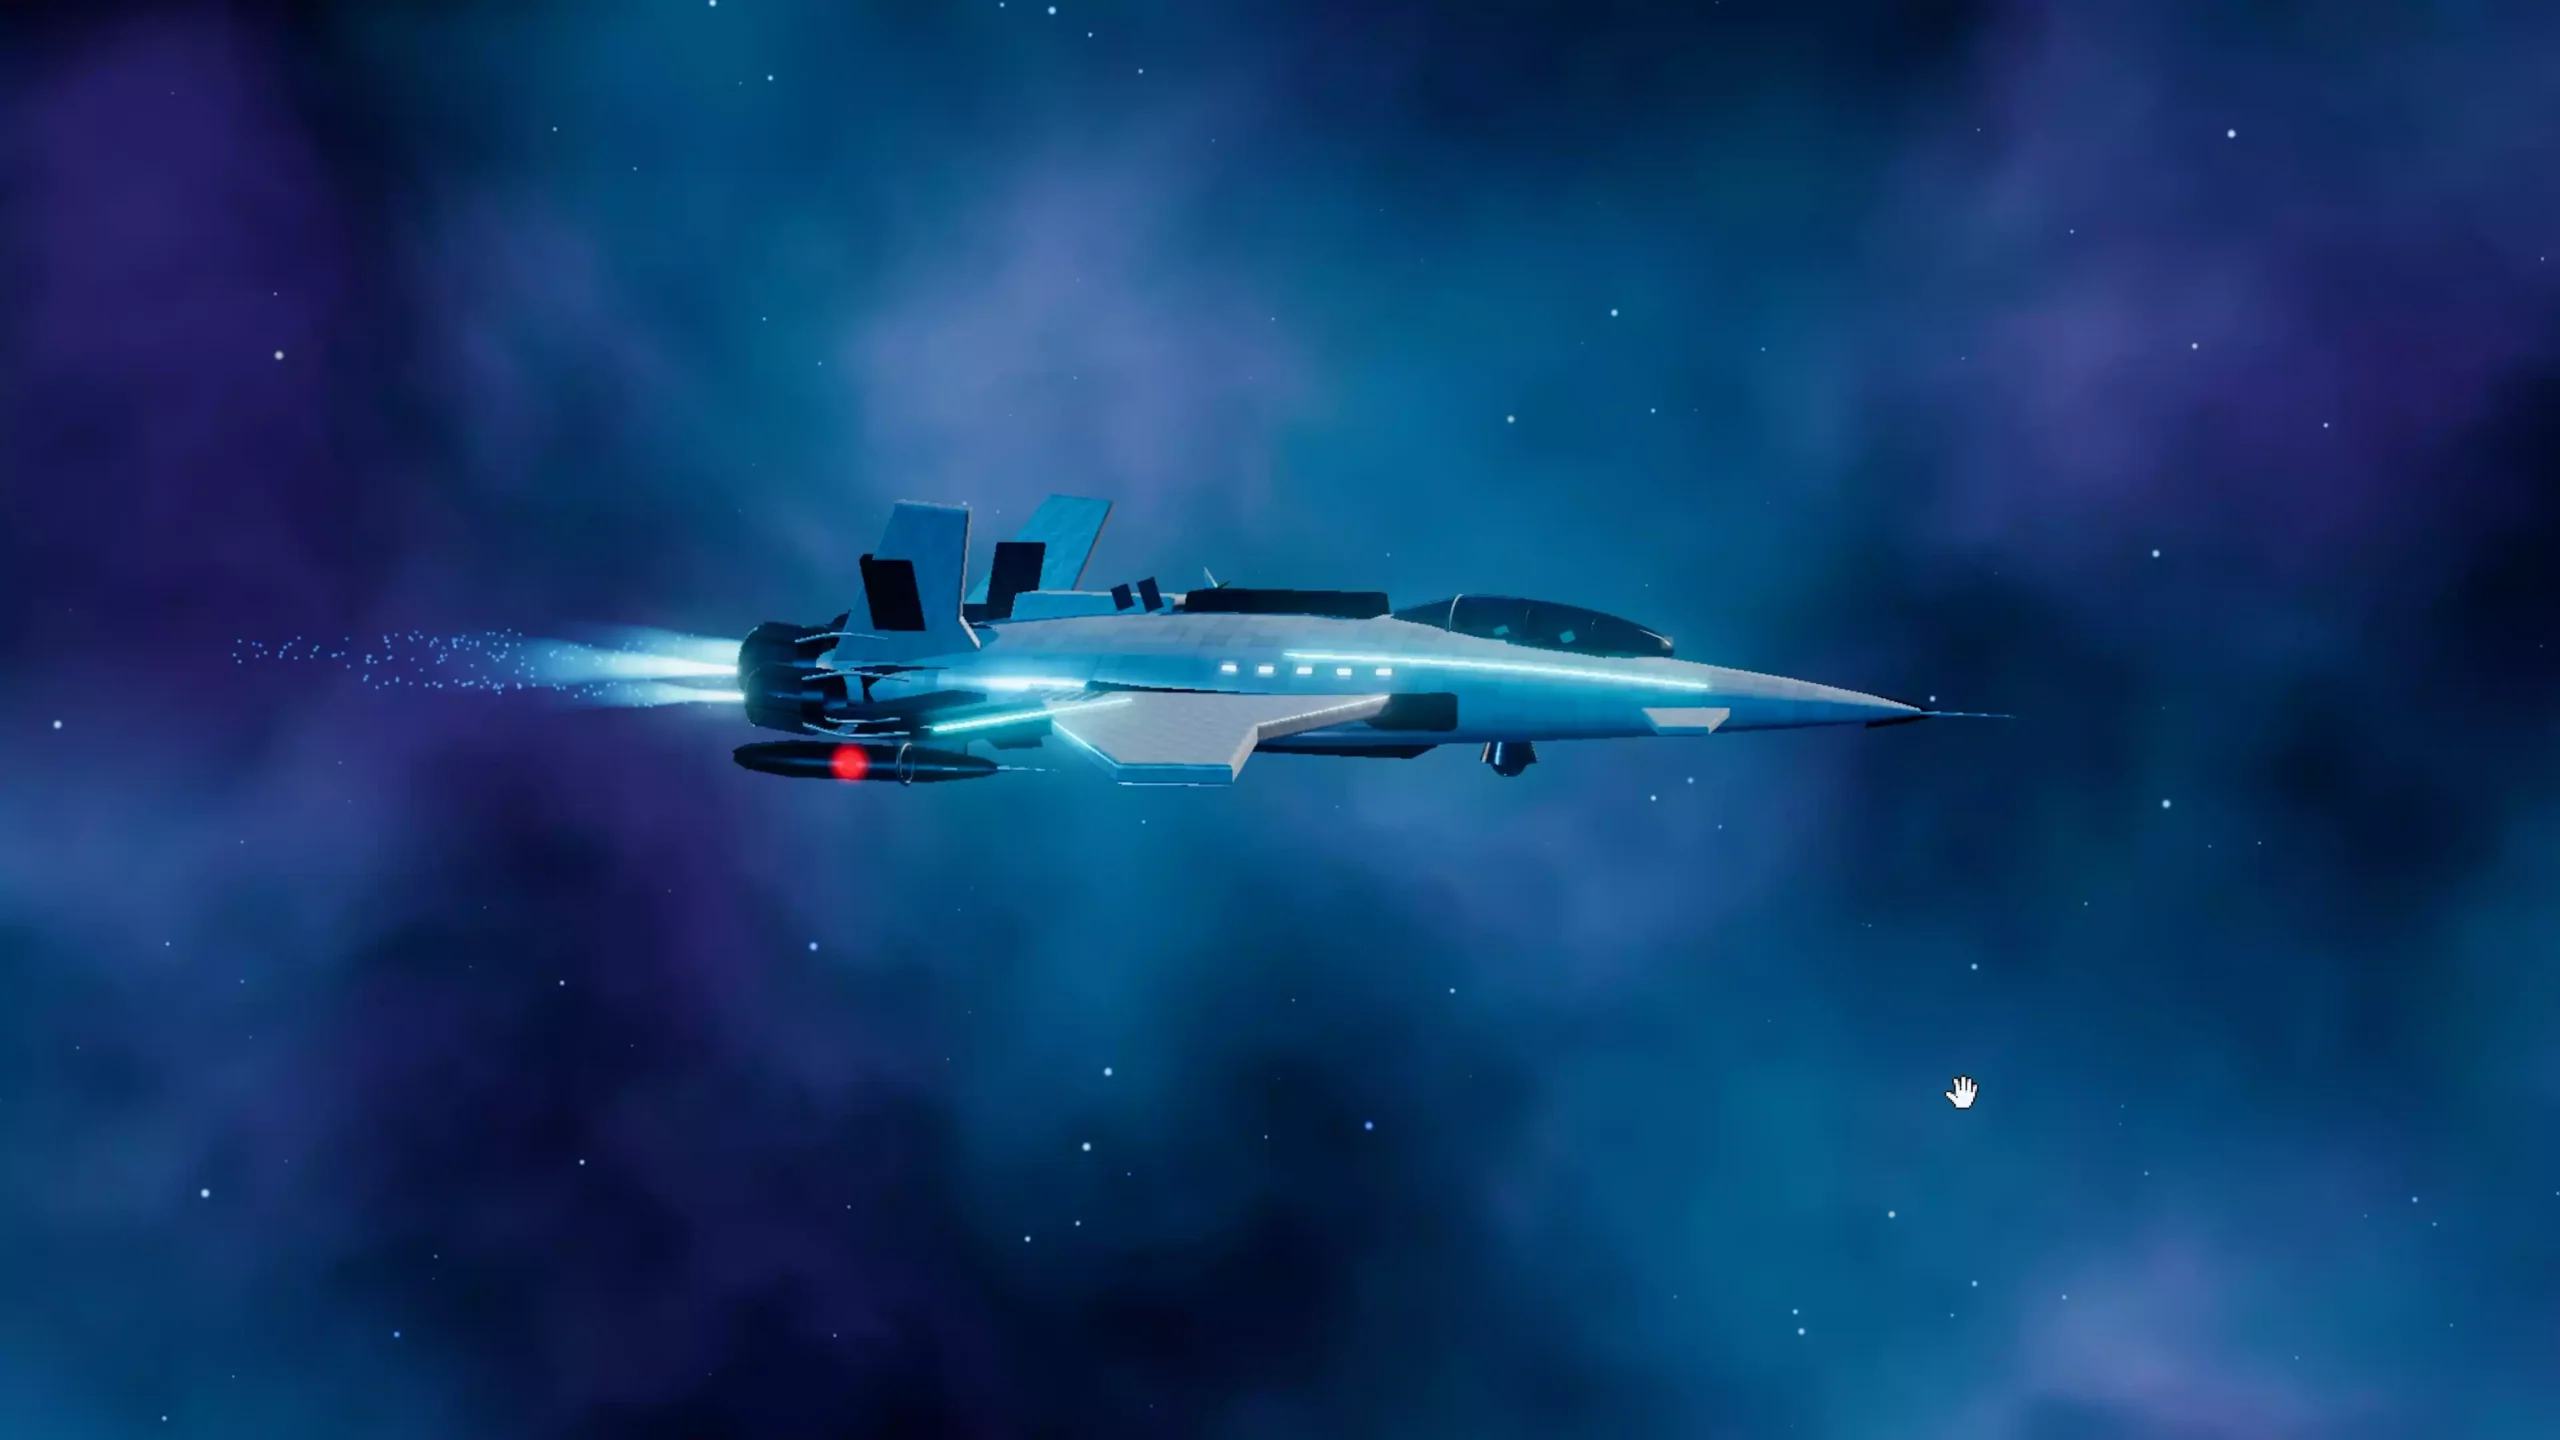
连上之后,就可以直接在对话里指挥模型干活。这次给它的任务是:在 Blender 里从零创建一艘高精度、电影级视觉效果的科幻宇宙飞船。任务书里定了工作方式:先看场景、删掉默认立方体,分步骤建模(主船体、驾驶舱、机翼、尾翼、引擎、细节、材质、灯光和背景),每步只执行一小段 Python 代码,做完一步就截图检查,有问题先修好再继续;材质、灯光、深空背景和相机角度也都给了明确要求。
实测里模型确实是按这个节奏干的:截图里它已经连续调用了 12 次工具,船体正在成型,右边面板还能看到它在边想边推进的思考过程。
最后的成片是下面这样:金属船体、发光装饰线、深空星云背景,EEVEE 渲染加辉光效果都齐了。一次提示词、中间不插手,能走到这个程度,工具调用这条链路算是跑通了。
用之前还有两点要注意:做工具调用得用支持工具调用的模型,太小的模型常常调不准;另外一个 Blender 同时只能被一个程序连接,如果 Claude Desktop 也配了 blender-mcp,先把它关掉。
值不值得现在上手
我的看法是这样:如果你已经在本地跑模型,Inkling 2 Mini 值得装一个试试。26.4B 的 MoE 底子、3.4B 的激活量,16GB 左右的显存挑个中低量化就能跑;编程和 Agent 这两块,官方数据和这次的实测对得上号——FPS 游戏一次成型、Blender 造飞船全程自己调工具,这两件事都不是光靠榜单分数能吹出来的。
但也别把它想得太全能:第一,榜单成绩是官方口径,换到你自己的任务上,效果要自己验;第二,速度那栏数字跟量化和硬件绑定很死,低量化跑得快但精度有代价,高量化吃显存又慢,挑版本的时候按自己显卡的实际情况来;第三,它毕竟是个刚发布一天的模型,社区生态、工具适配都还在跟进,急着上生产环境的事先缓缓。
本地 AI 这条线,模型越出越多,真正拉开差距的不是参数数字,是谁能在普通电脑上稳定干活。从这次实测看,Inkling 2 Mini 至少在这件事上交了份像样的答卷。