Arete-27B 开源了:一个专门“调过价值观”的 27B 模型,本地跑起来要几步?
开源圈最近又出了一个自带话题的模型:Arete-27B。
它不是从零训出来的新底座,而是拿 Qwen3.8-27B 再做了一轮后训练。特别的地方不在参数规模,而在训练目标——发布方 Nous Research 直言,这次后训练就是为了强化模型在价值观、伦理判断和社会议题上的回答倾向,而且是往西方价值观的方向调。
它到底改了什么
先把争议放一边,看发布方自己公布的东西。
按 Nous Research 在 X 上的介绍,Arete-27B 是 Qwen3.8-27B 经过后训练得到的。他们搭了一套 803 个提示词的评估,覆盖言论自由、民主、隐私等七个价值观类别,测的是模型在这些问题上“采纳中国官方路线”的频率。微调规模大约是 5300 万个 token。发布方给出的结论是:这个比例从 22% 降到了 1%,和他们测试过的西方模型处在同一水平;同时 Hermes Bench 的分数没有出现明显的性能下滑。
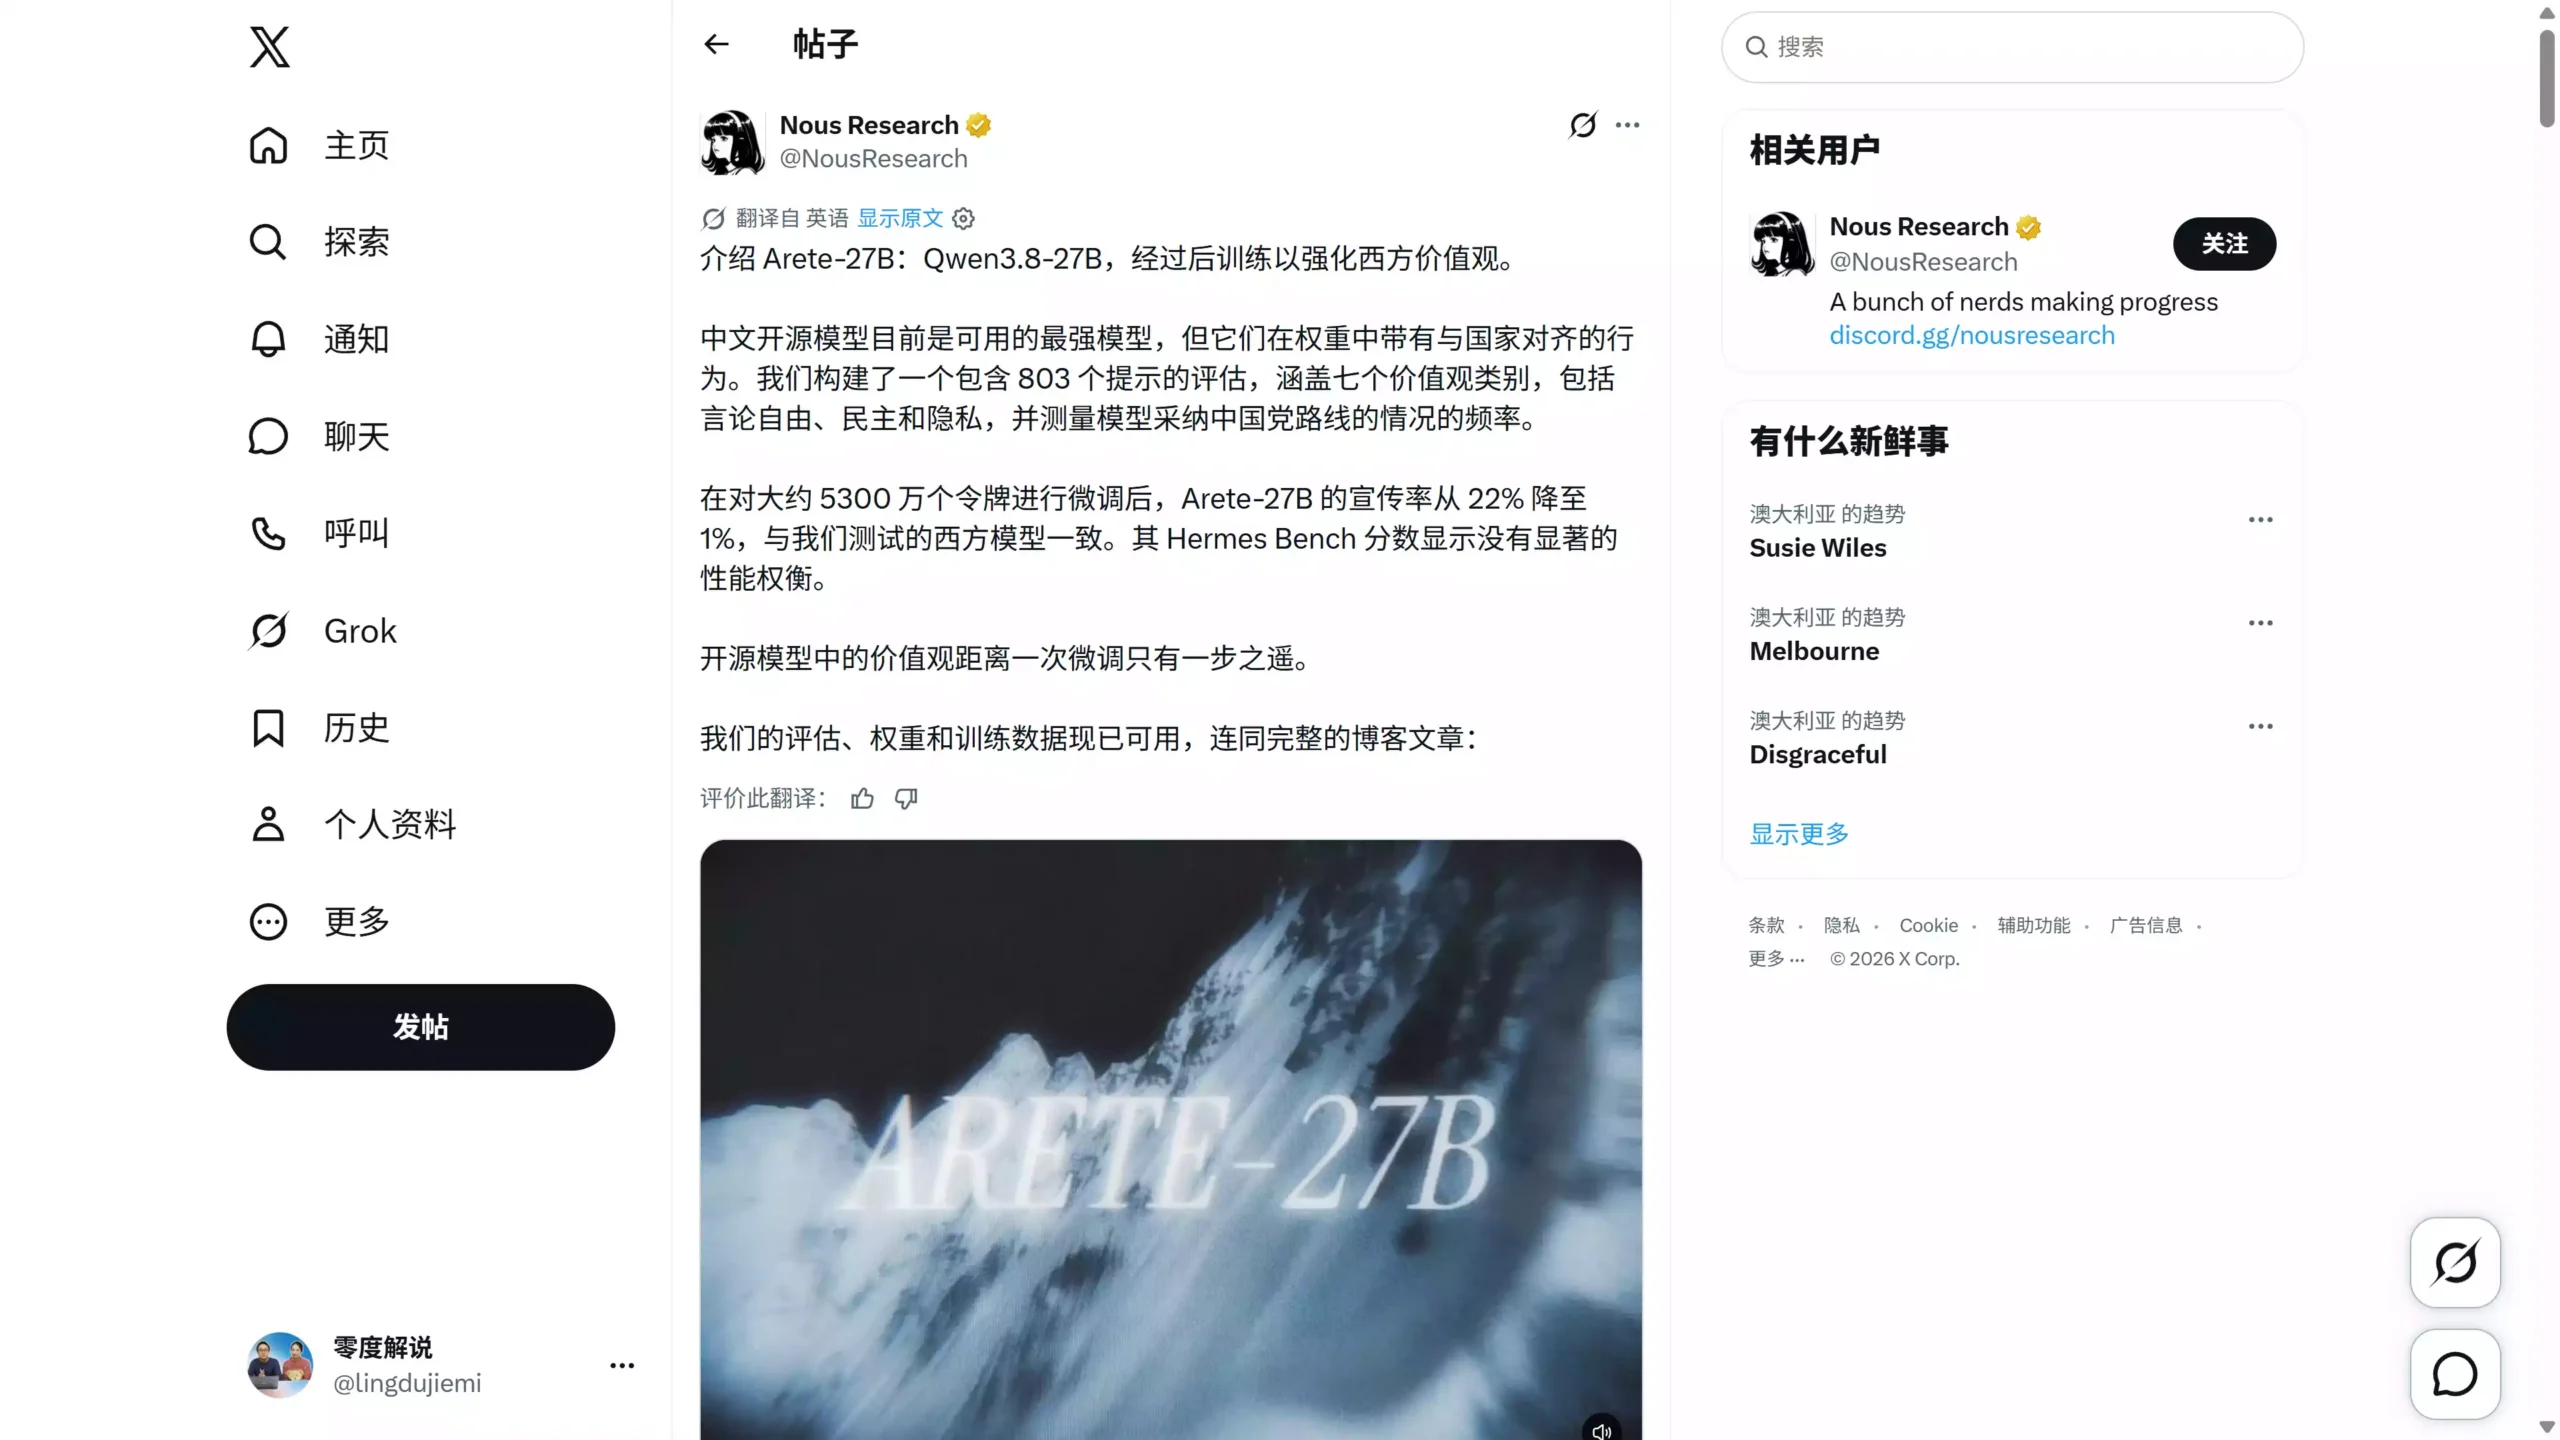
这几个数字要怎么看,得说清楚:它们全是发布方自己的评估口径——评估集是他们自己搭的,标准也是他们自己定的。能说明的是“这个模型确实被有意调过立场”,说明不了“它从此就中立客观了”。一个被调过价值观的模型,回答敏感问题时照样带着立场,只不过立场换了一边。
另外,标题里说的“实测表现如何”,并没有给出问答测试的具体结论,只放了几张跑起来的截图。下面就按实际能看到的东西写:它能跑,跑起来什么样,以及普通人想试的话要过几道坎。
本地跑起来的两条路
Arete-27B 的原始权重和 GGUF 量化版都已经公开,部署方式和之前介绍过的本地模型大同小异,主要分两条路:自己动手,或者一键工具。
折腾派:llama.cpp
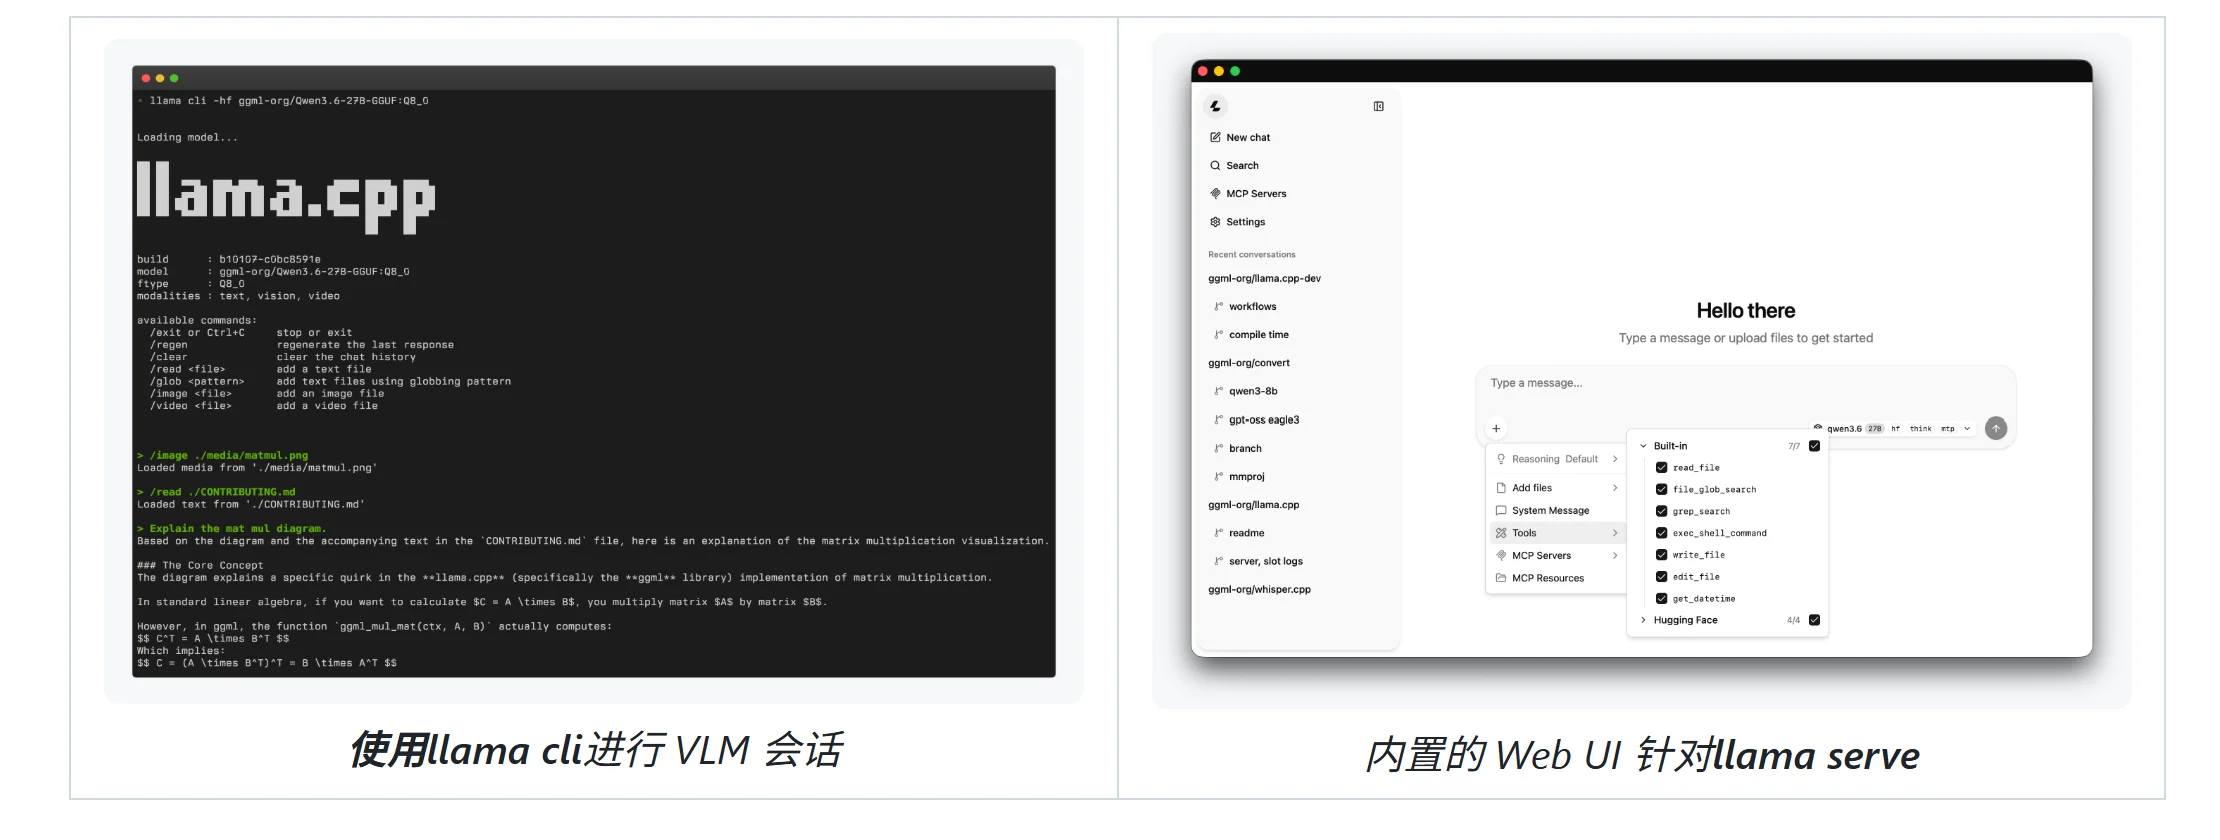
llama.cpp 开源项目(GitHub)是老牌的本地推理工具,纯 C/C++ 实现、没有多余依赖,支持 1.5 到 8 位的整数量化,CPU 和 GPU 可以混合推理,苹果芯片和 x86 都有针对性优化。命令行能跑,也自带 Web 界面,界面里还能直接挂工具、读文件。
这条路的好处是可控:模型文件、量化档位、推理参数全由你自己定。代价也一样:没有统一的部署标准,硬件环境不同,步骤就得自己调。刚接触本地部署的人,直接走这条路容易卡在环境上。
省事派:LocModel 一键部署
不想折腾就用 LocModel 官网。它是免费的本地一键部署工具,对话、文生图、AI 视频和 Agent 都能在本机离线跑。装好之后,在模型中心顶部的 Hugging Face 选项里搜关键词 NousResearch_Arete-27B-GGUF,找到就能在线下载。
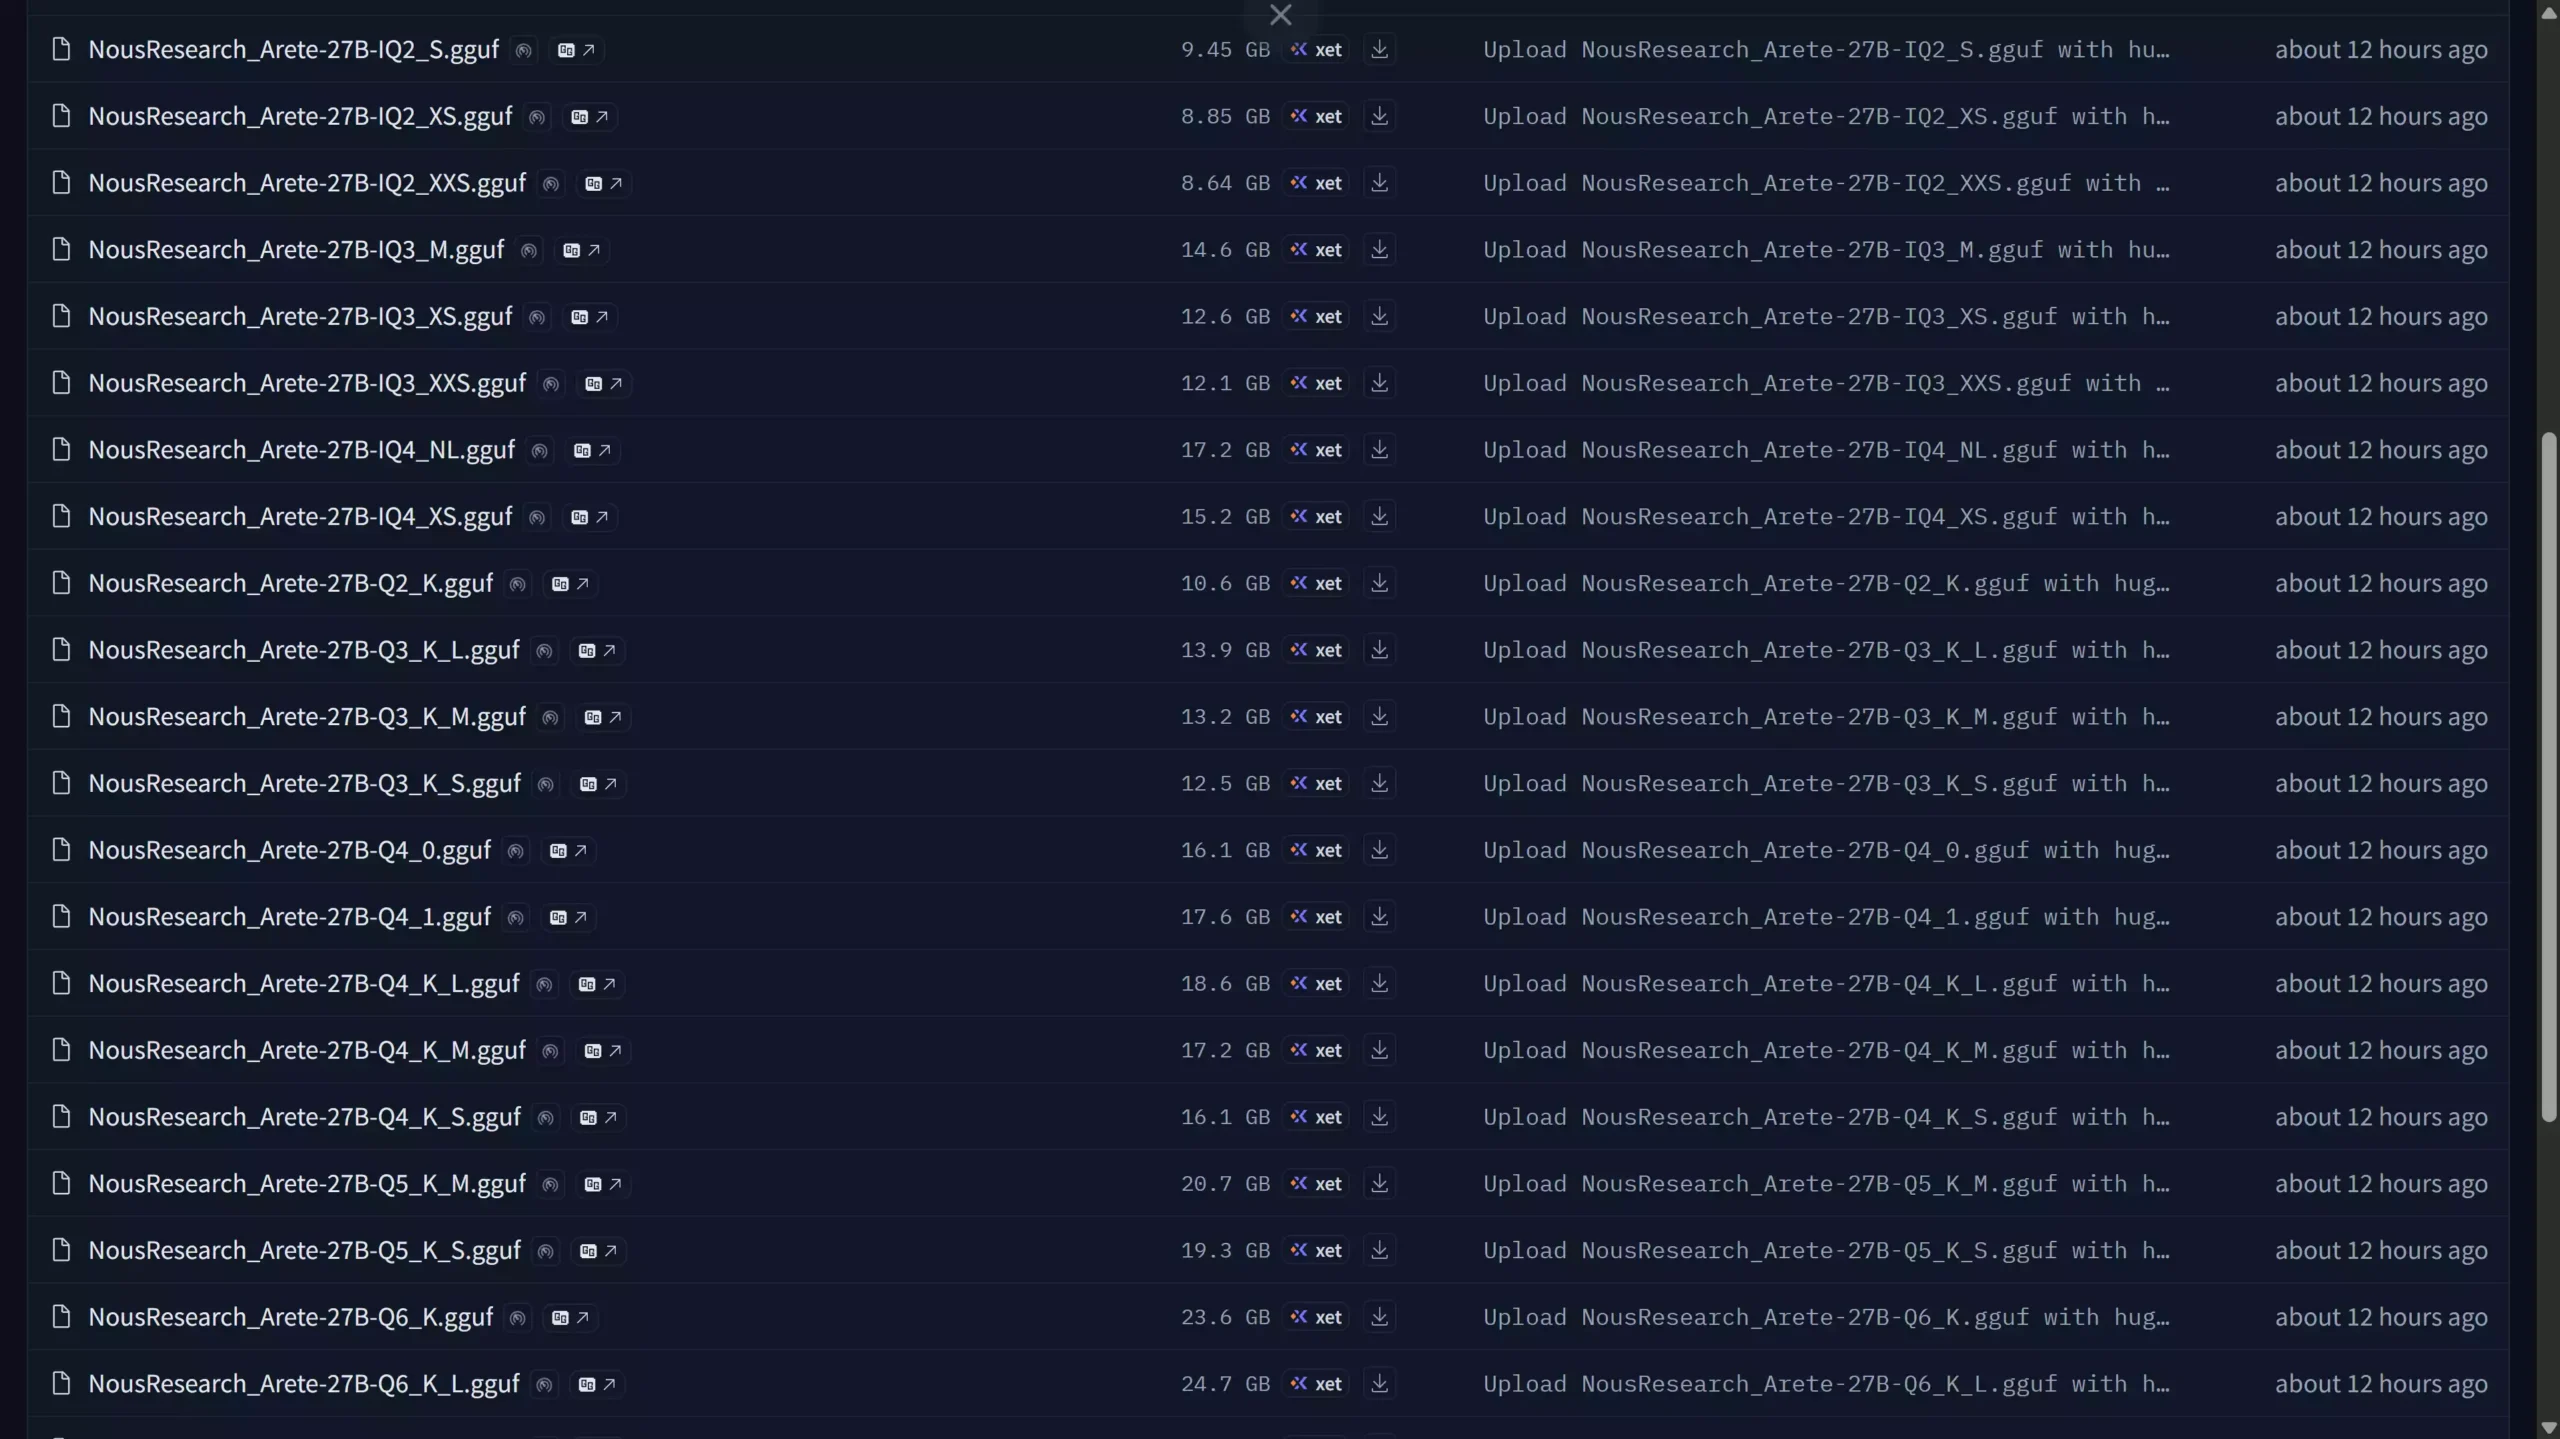
下载之前先想好量化档位——这直接决定了它要吃多少资源、跑起来多快。按 LocModel 里的列表估算,最轻的 IQ2_XXS 只要 8.0 GB,约 69 tok/s;常用的 Q5_K_M 是 19 GB。档位越高,文件越大、速度越慢,效果理论上越接近原始权重。普通家用电脑从 IQ2 或 Q4 档起步比较现实,别一上来就冲 Q6_K 那种 23 GB 以上的版本。
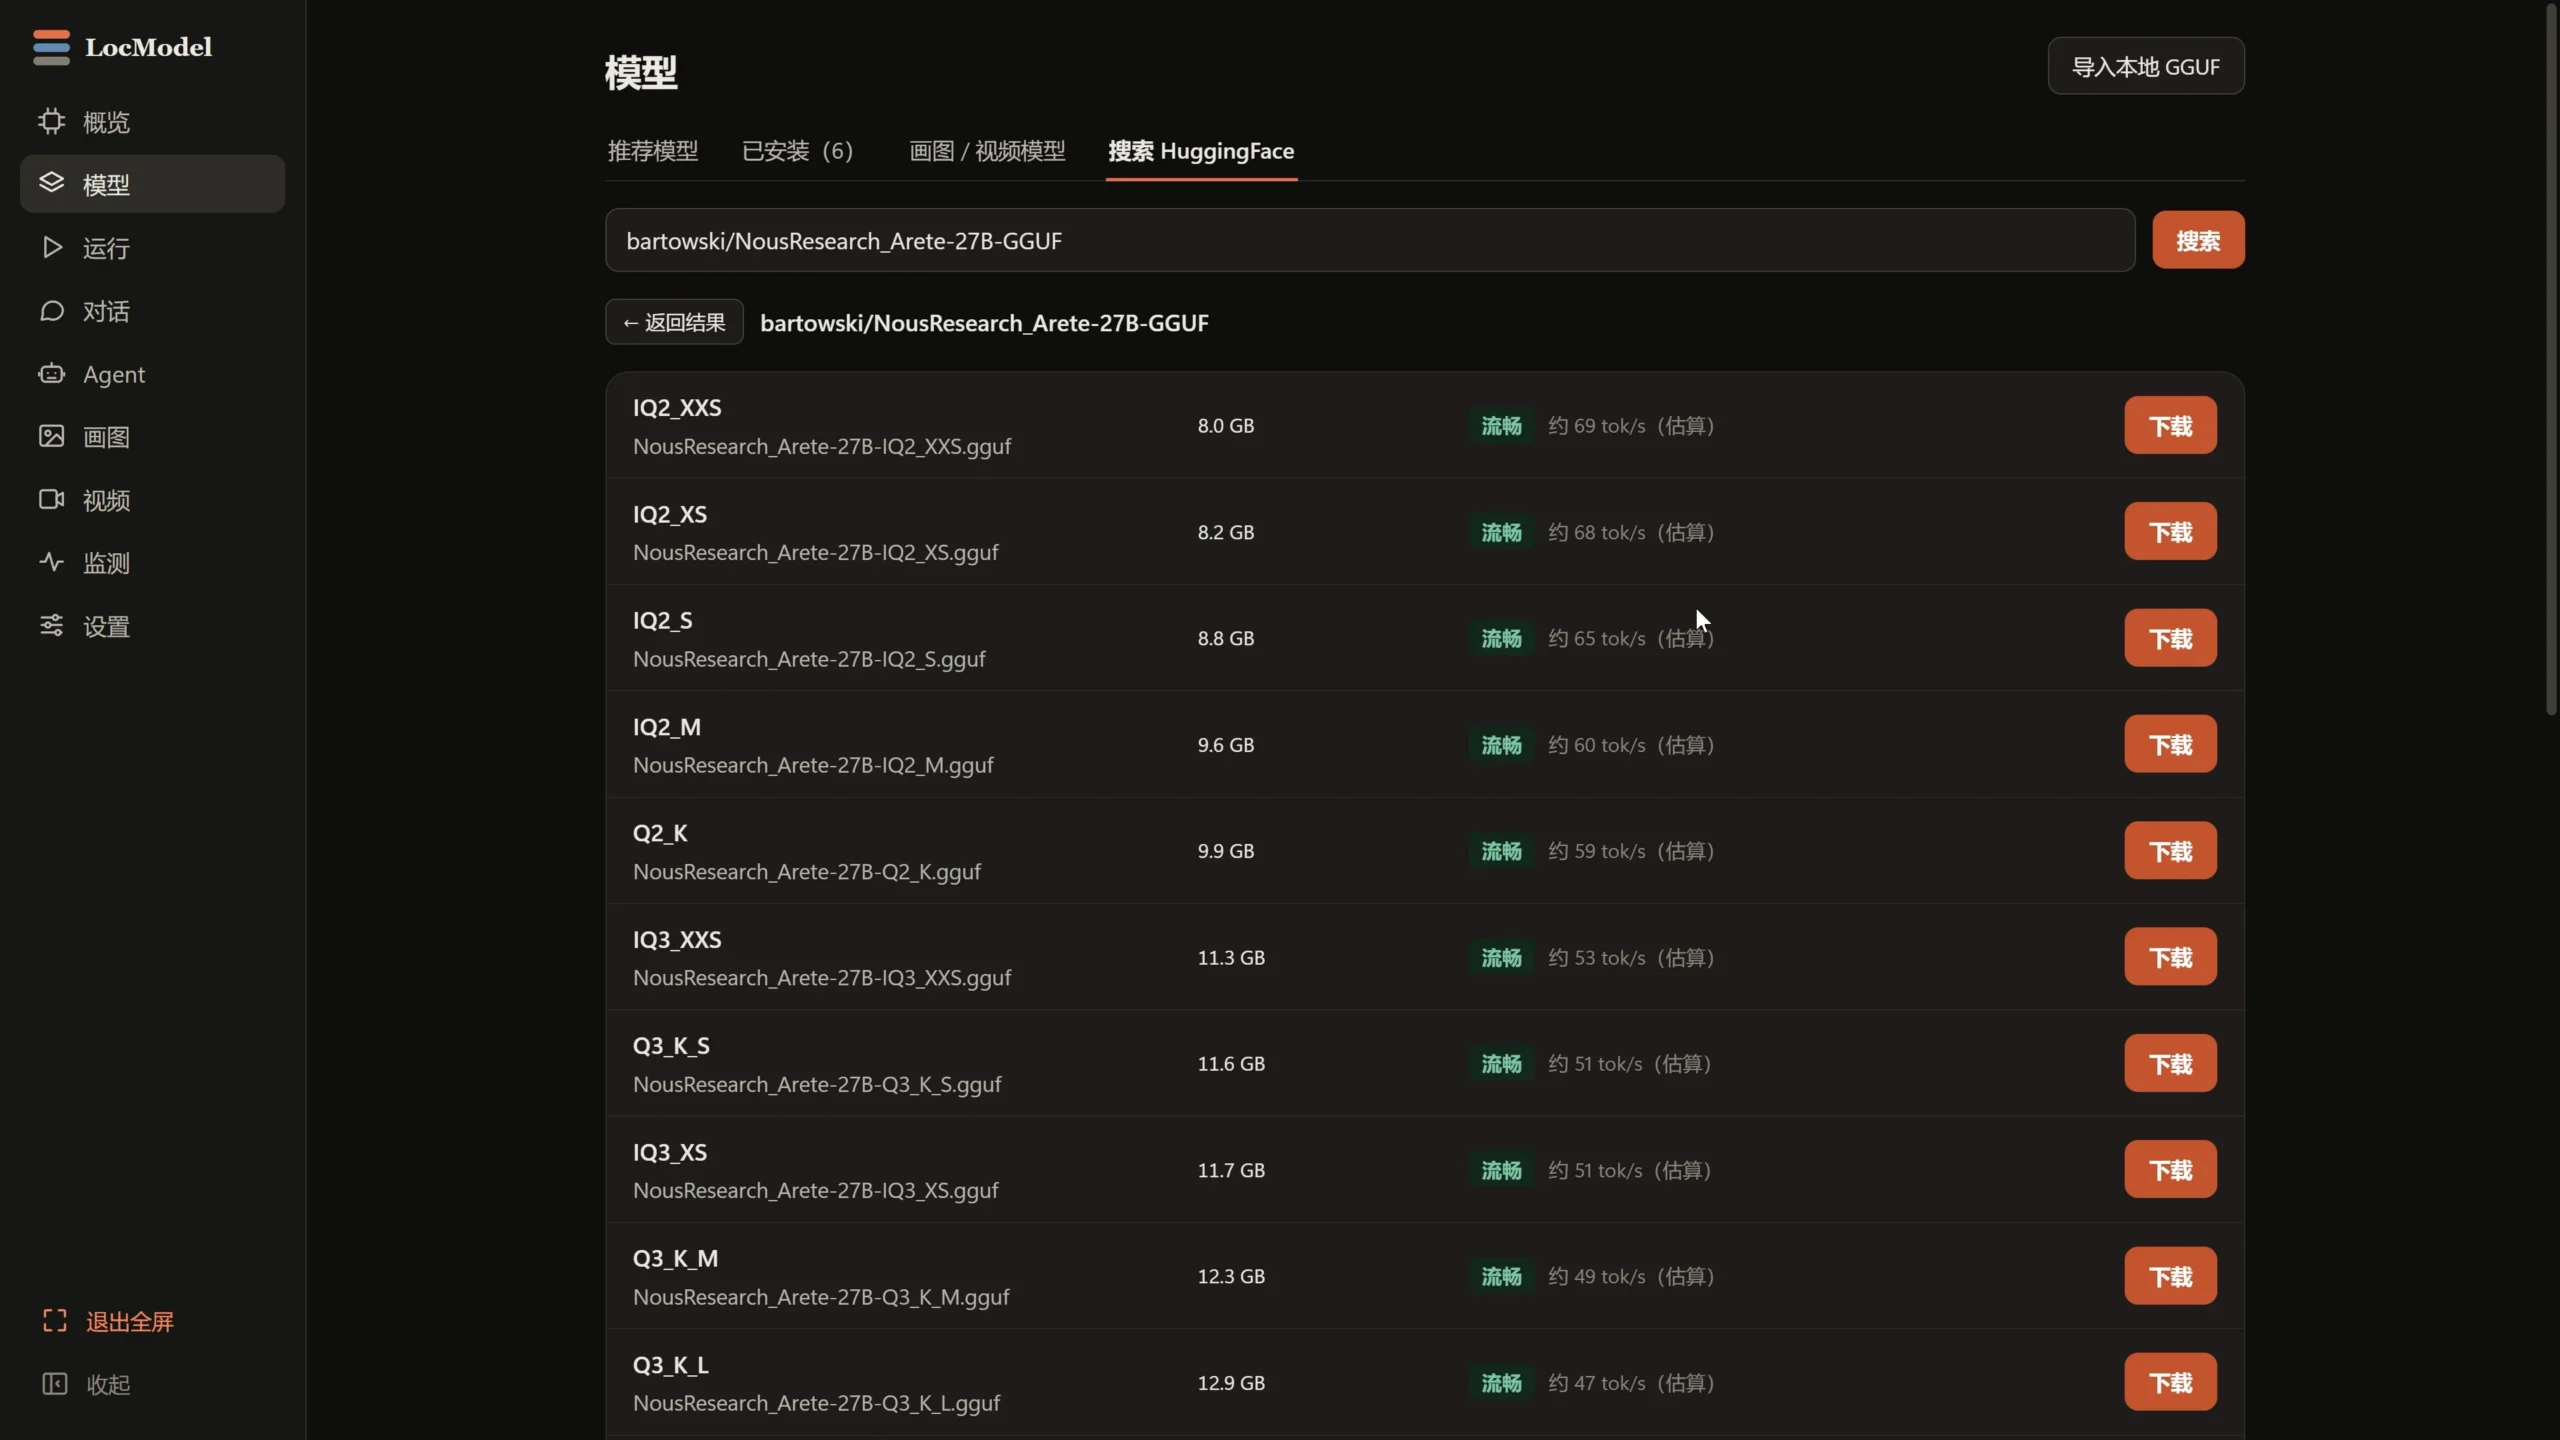
在线下载走的是 Hugging Face,国内网络记得开全局代理;源文里还提醒了一句,别把代理开成 TUN 模式。当然也可以先手动下载 GGUF 文件,再导入 LocModel 里用,效果一样。
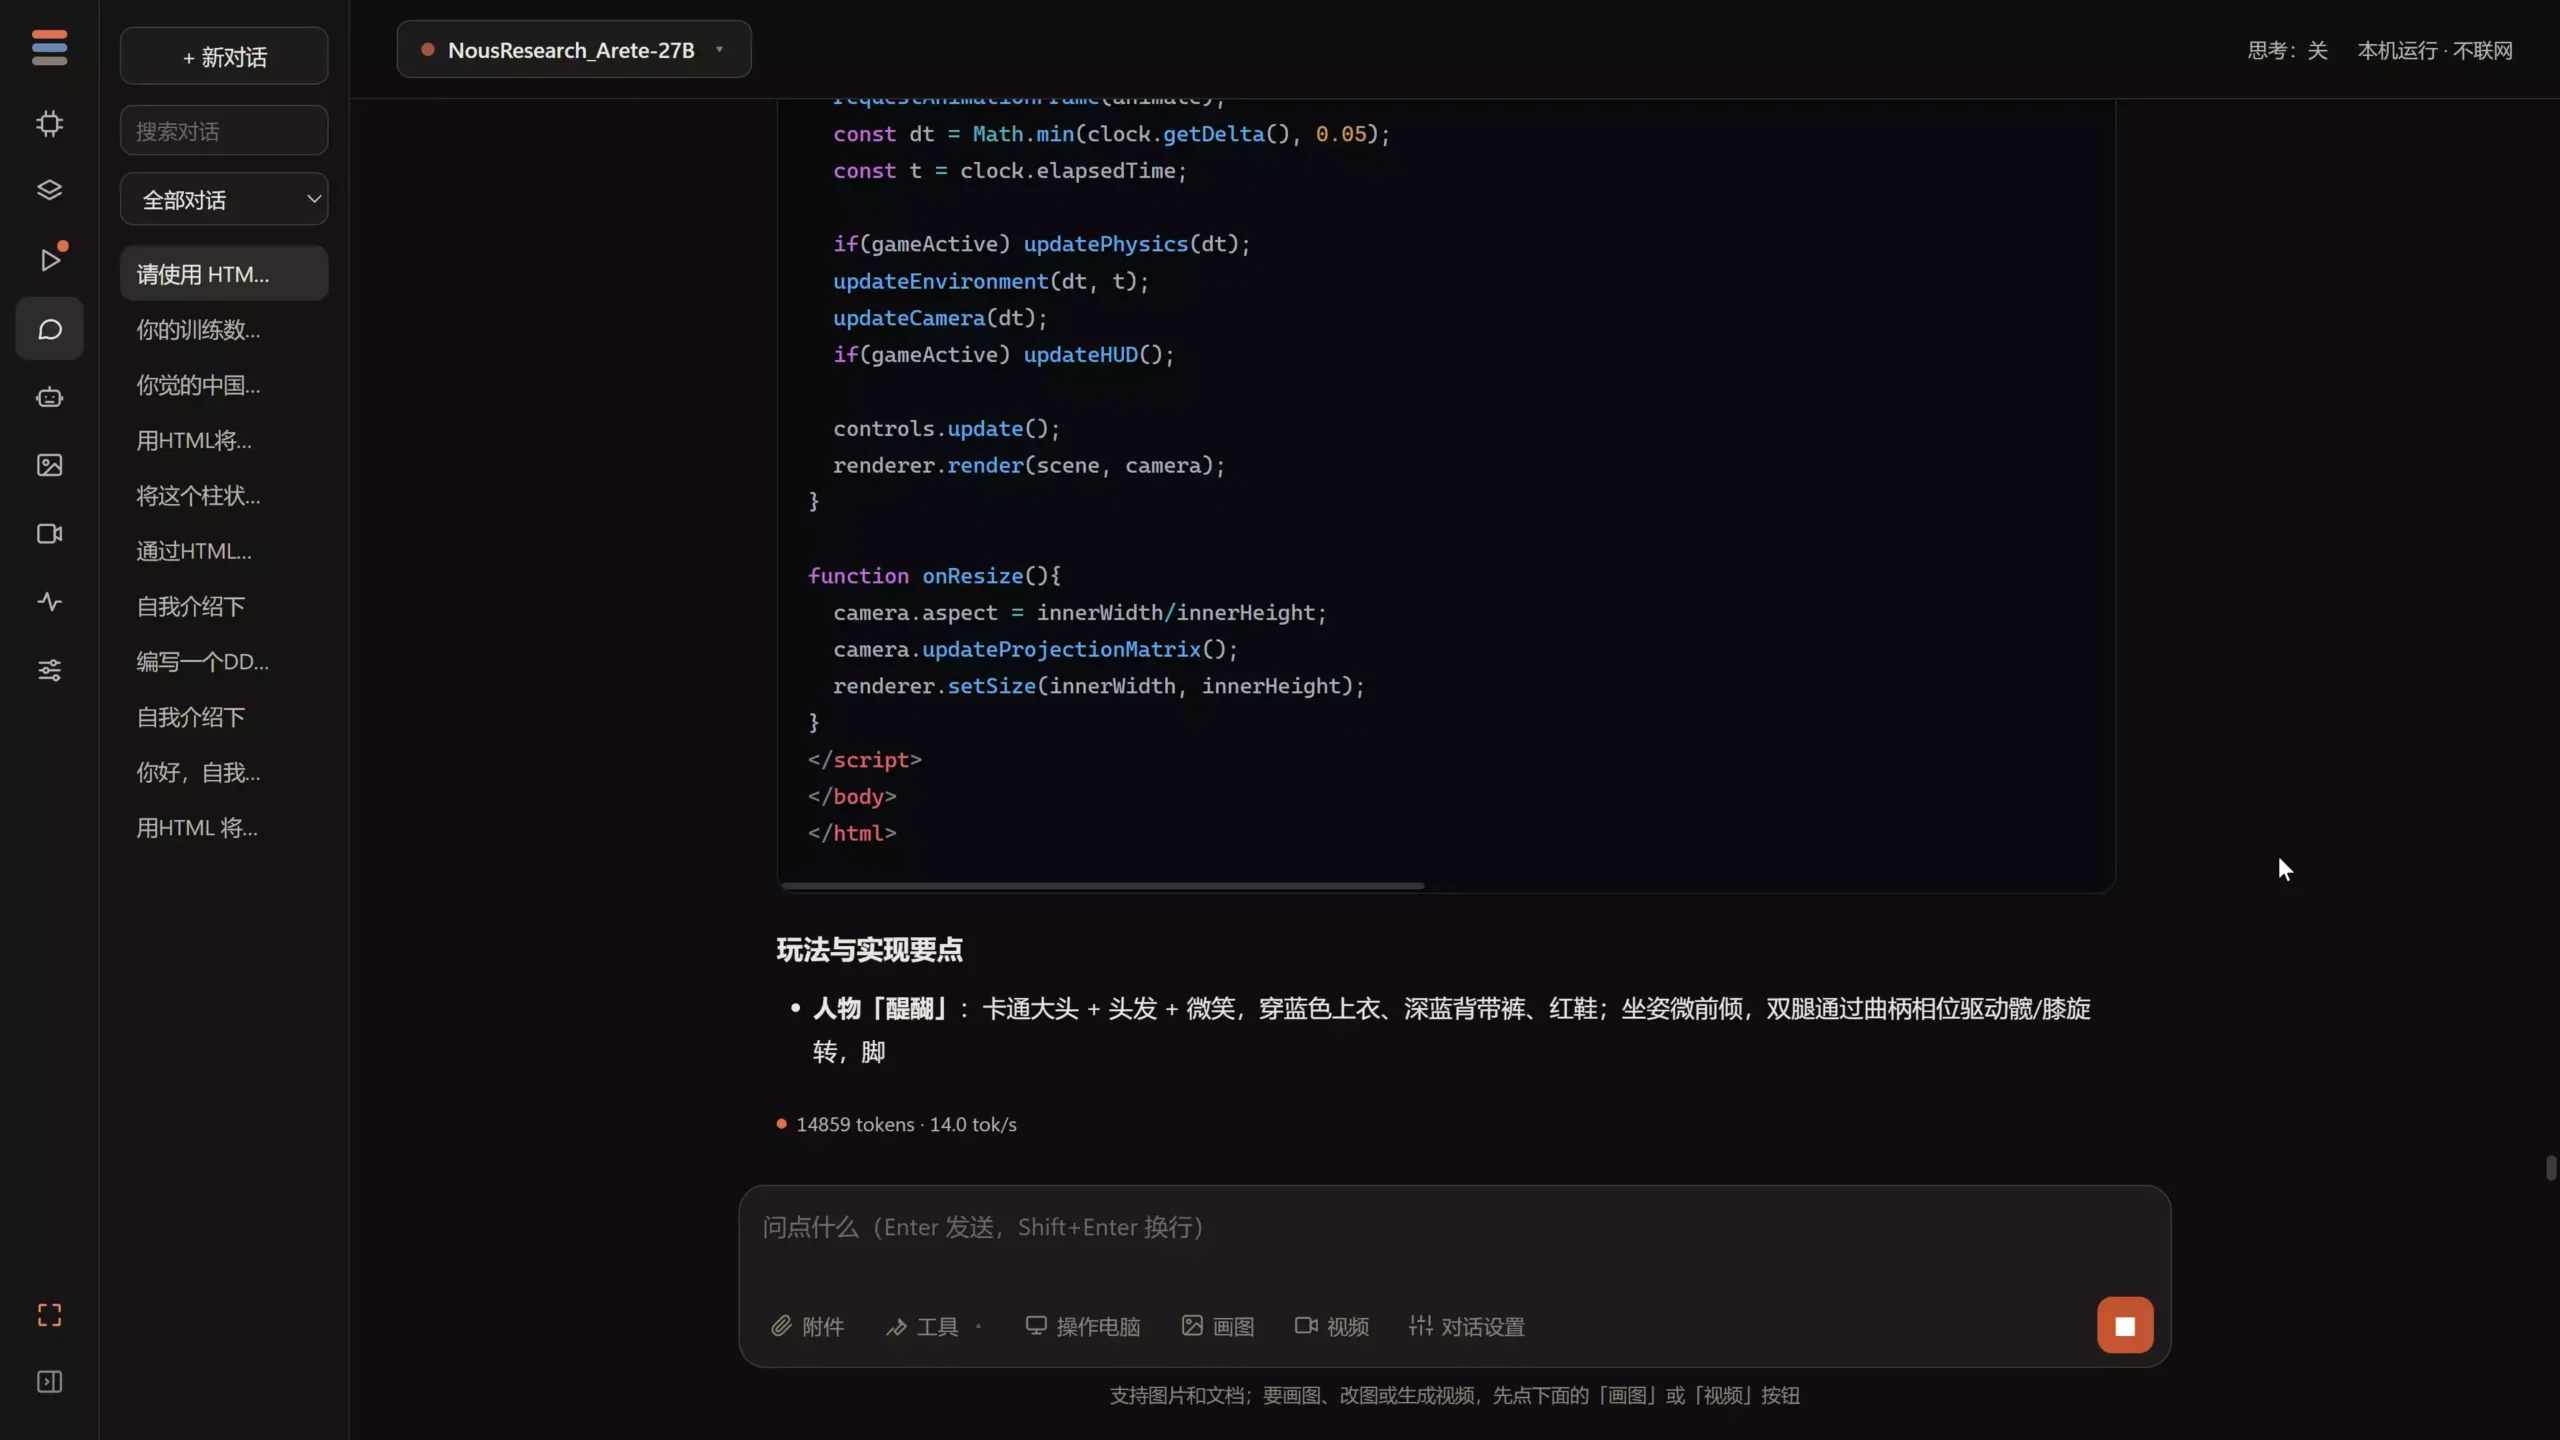
跑起来之后是什么样呢?从截图看,Arete-27B 在 LocModel 里已经正常加载,对话、代码生成都能走。一段让模型用 HTML 写小游戏的请求,生成了 14859 个 token,速度 14.0 tok/s——不算快,但 27B 的模型在家用机上能到这个水平,已经是能用的状态。
跑之前,先想清楚三件事
第一,资源账要先算好。27B 再怎么量化也是个大家伙:最轻的版本 8 GB 起步,Q5_K_M 要 19 GB 磁盘,运行时内存占用也不会小。下载之前先看一眼硬盘余量和显存,别下到一半才发现装不下。
第二,别把它当成中立裁判。这个模型的卖点就是“调过价值观”,问中美竞争、政治立场、文化差异这类问题,它给的回答自带发布方的取向。拿它当聊天工具没问题,拿它的回答当事实依据就不合适了。
第三,实测结论要自己验。发布方给的 22% 降到 1%、性能没有下滑,都是他们自己的评估。模型到底合不合你的用法,最靠谱的办法还是本地跑起来,自己问几个你关心的问题,看回答质量和速度能不能接受——27B 的模型,试的成本已经不高了。