8GB 显存跑 125B 大模型?Strata 的分层加载思路,值不值得一试
本地跑大模型这件事,门槛一直卡在显存上。模型参数越大,需要的显存越多,普通电脑往往还没开始就被劝退。最近 GitHub 上出现了一个叫 Strata 的开源部署工具,它的切入点不太一样:不硬拼显存,而是把显存、内存和硬盘拼在一起用,号称能让配置一般的电脑也有机会跑起 125B 参数级别的大模型。
先说清楚:这篇文章讲的是这个工具的思路和上手方法,里面的性能数字都是项目方的说法,我没有逐条实测验证。能不能跑、跑起来多快,最终还是看你自己的机器。
它到底是怎么把大模型塞进小显存的
Strata 的核心做法是分层存放和加载模型权重。一部分数据放进显存,跑得最快的那部分先算;放不下的部分放在系统内存里;实在不够,还可以借用硬盘空间。这样一来,显存容量就不再是唯一的硬上限,模型可以“铺开”在整台机器的存储层级上。
这个思路本身并不新鲜,本地部署圈子里早就有人用内存 offload、磁盘 offload 的办法硬上大模型。Strata 想做的,是把这套操作打包成一个普通人也能直接用的工具,而不是一堆需要手动调参数的脚本。
那个“快 4 倍”的说法,怎么看
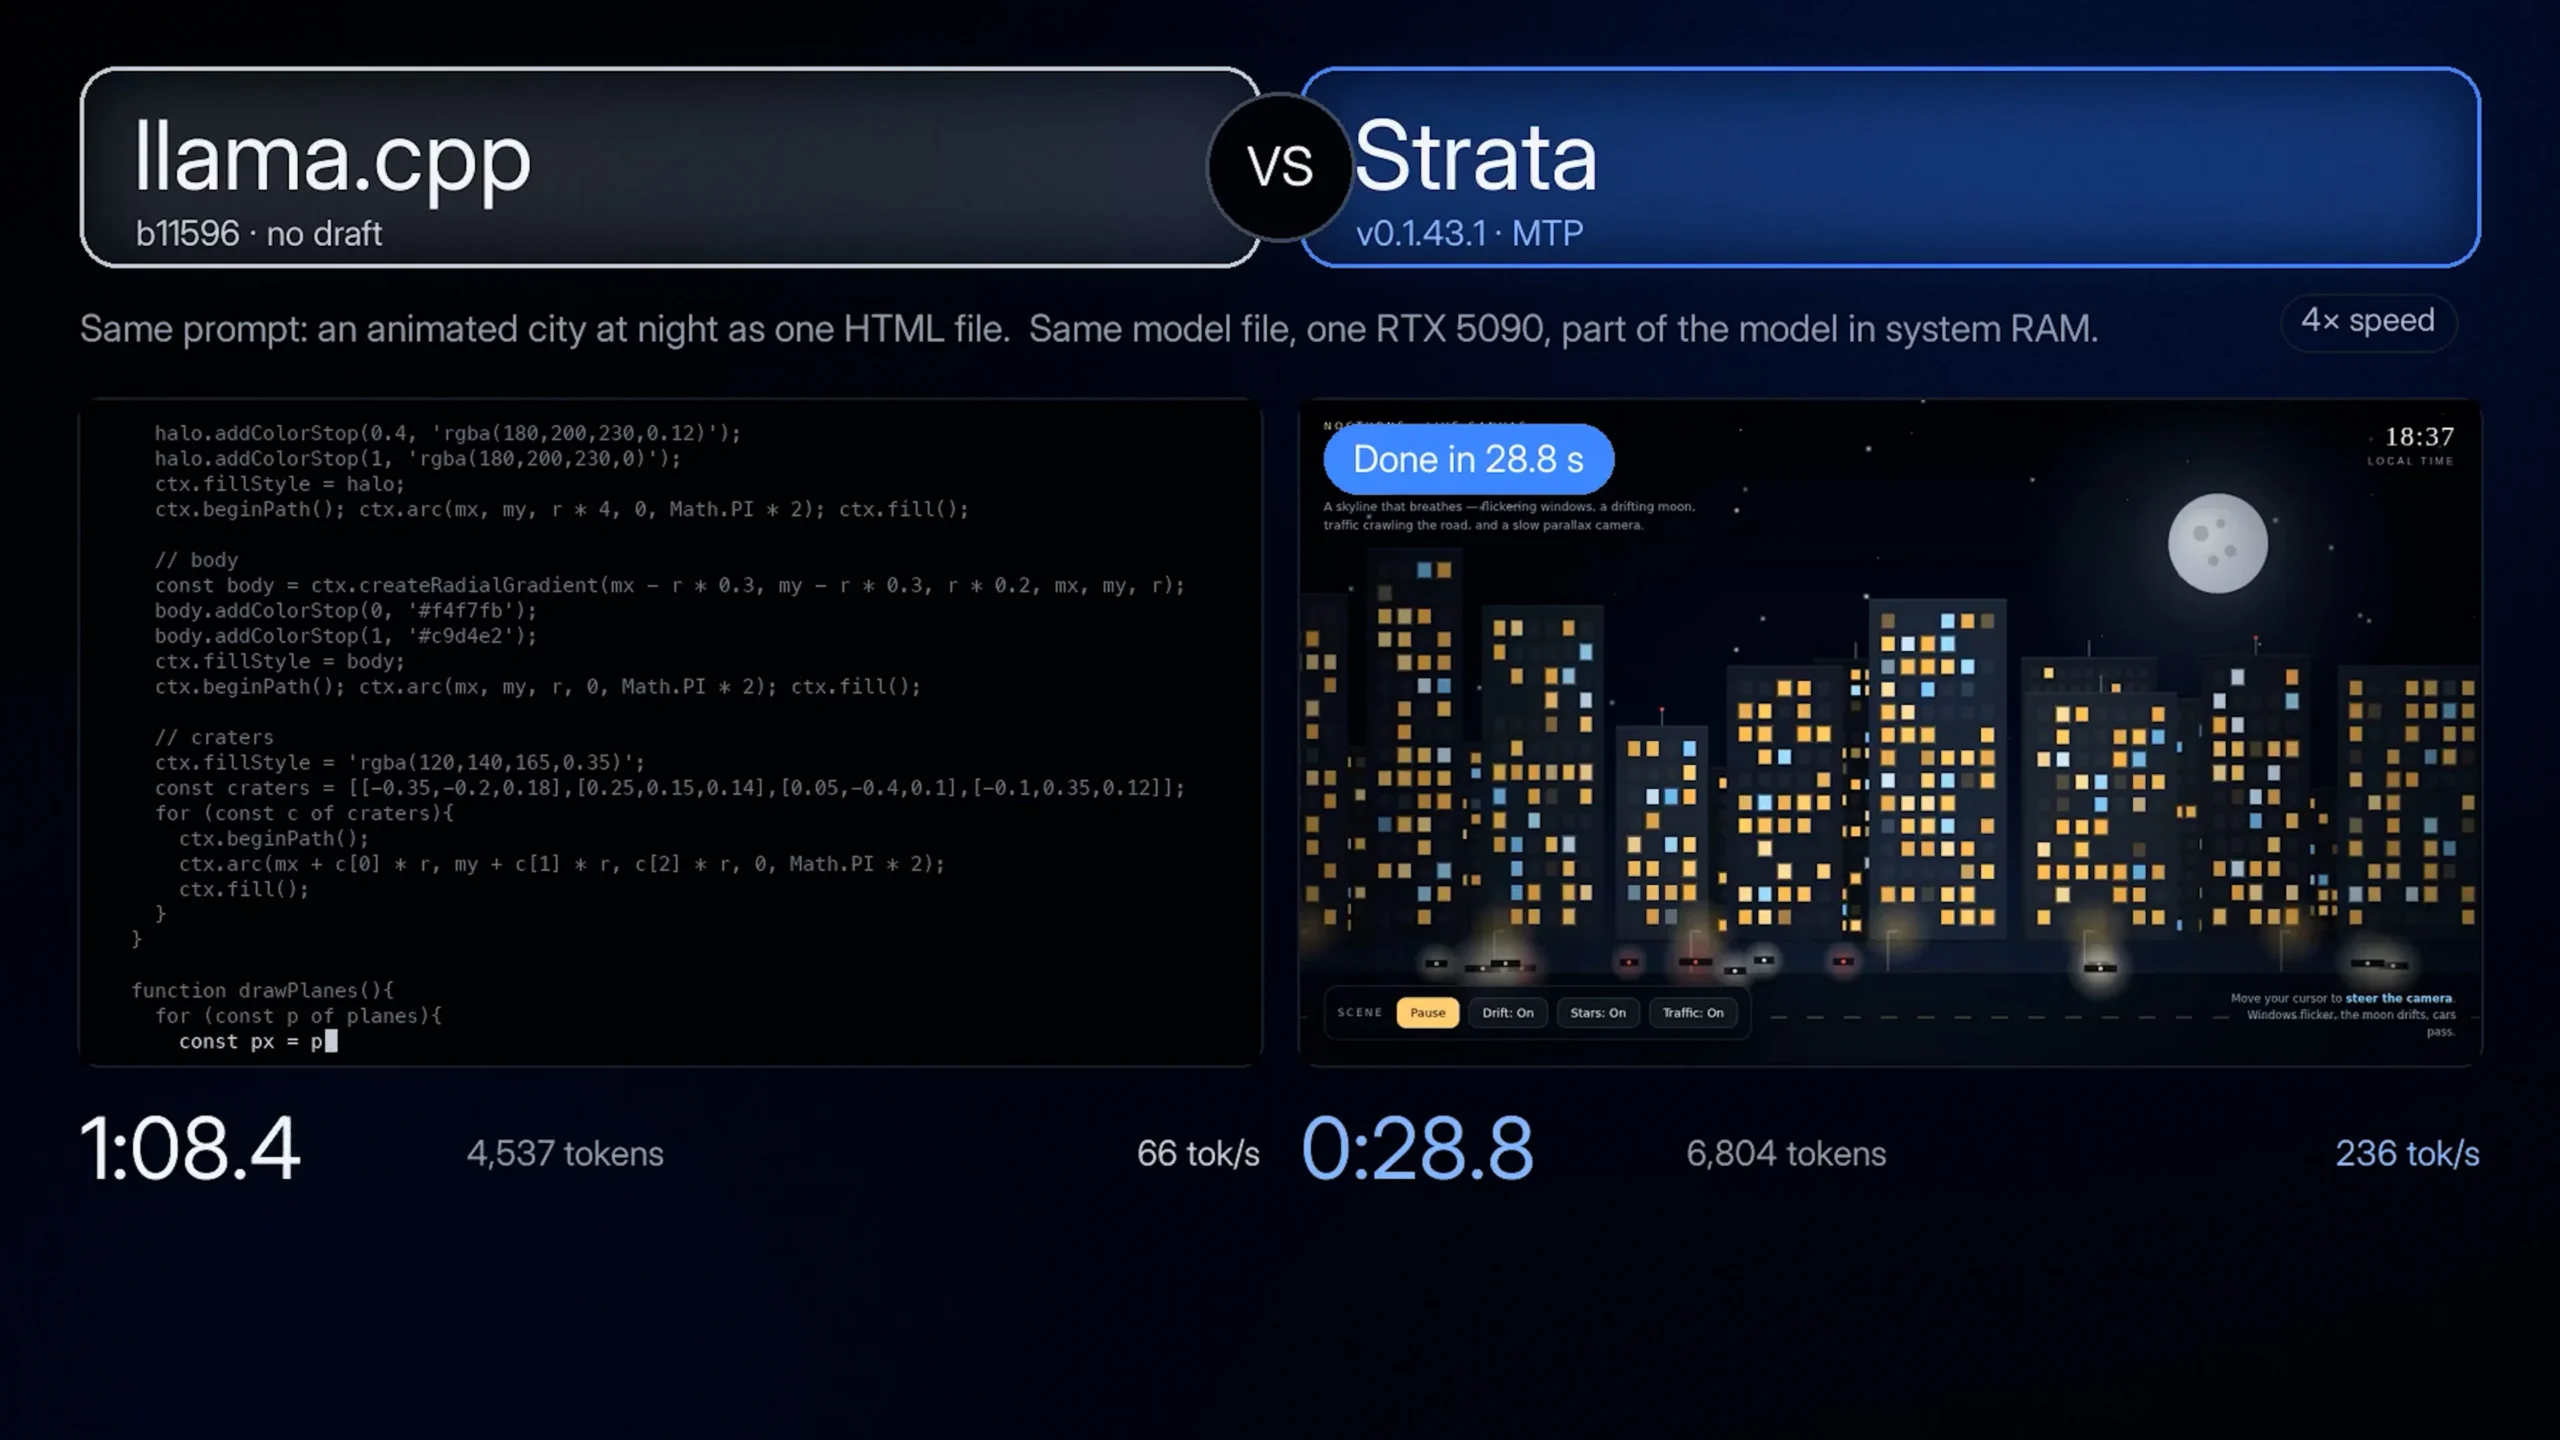
按项目方的说法,在相同模型、相同提示词的条件下,Strata 的速度比 llama.cpp 快了将近 4 倍。如果这个数字在你的机器上能复现,对大模型来说确实是个不小的差距。
但这里要冷静一下:第一,速度对比高度依赖硬件组合、模型量化版本和提示词长度,换一台机器结果可能完全不同;第二,能跑起来和跑得流畅是两回事。一旦大量权重落在内存甚至硬盘上,生成速度一定会掉下来,适合慢慢出结果的任务,不适合指望它实时对答。所以更准确的理解是:Strata 降低的是“能不能跑”的门槛,而不是直接把老电脑变成高配工作站。
上手第一步:下载安装,让它按你的硬件挑配置
先去Strata 开源仓库(GitHub)下载安装包。安装过程不需要你自己先选一堆配置,它会根据你的电脑硬件,帮你推荐合适的模型和部署环境,N 卡、A 卡、mac、Linux 都在支持范围内。
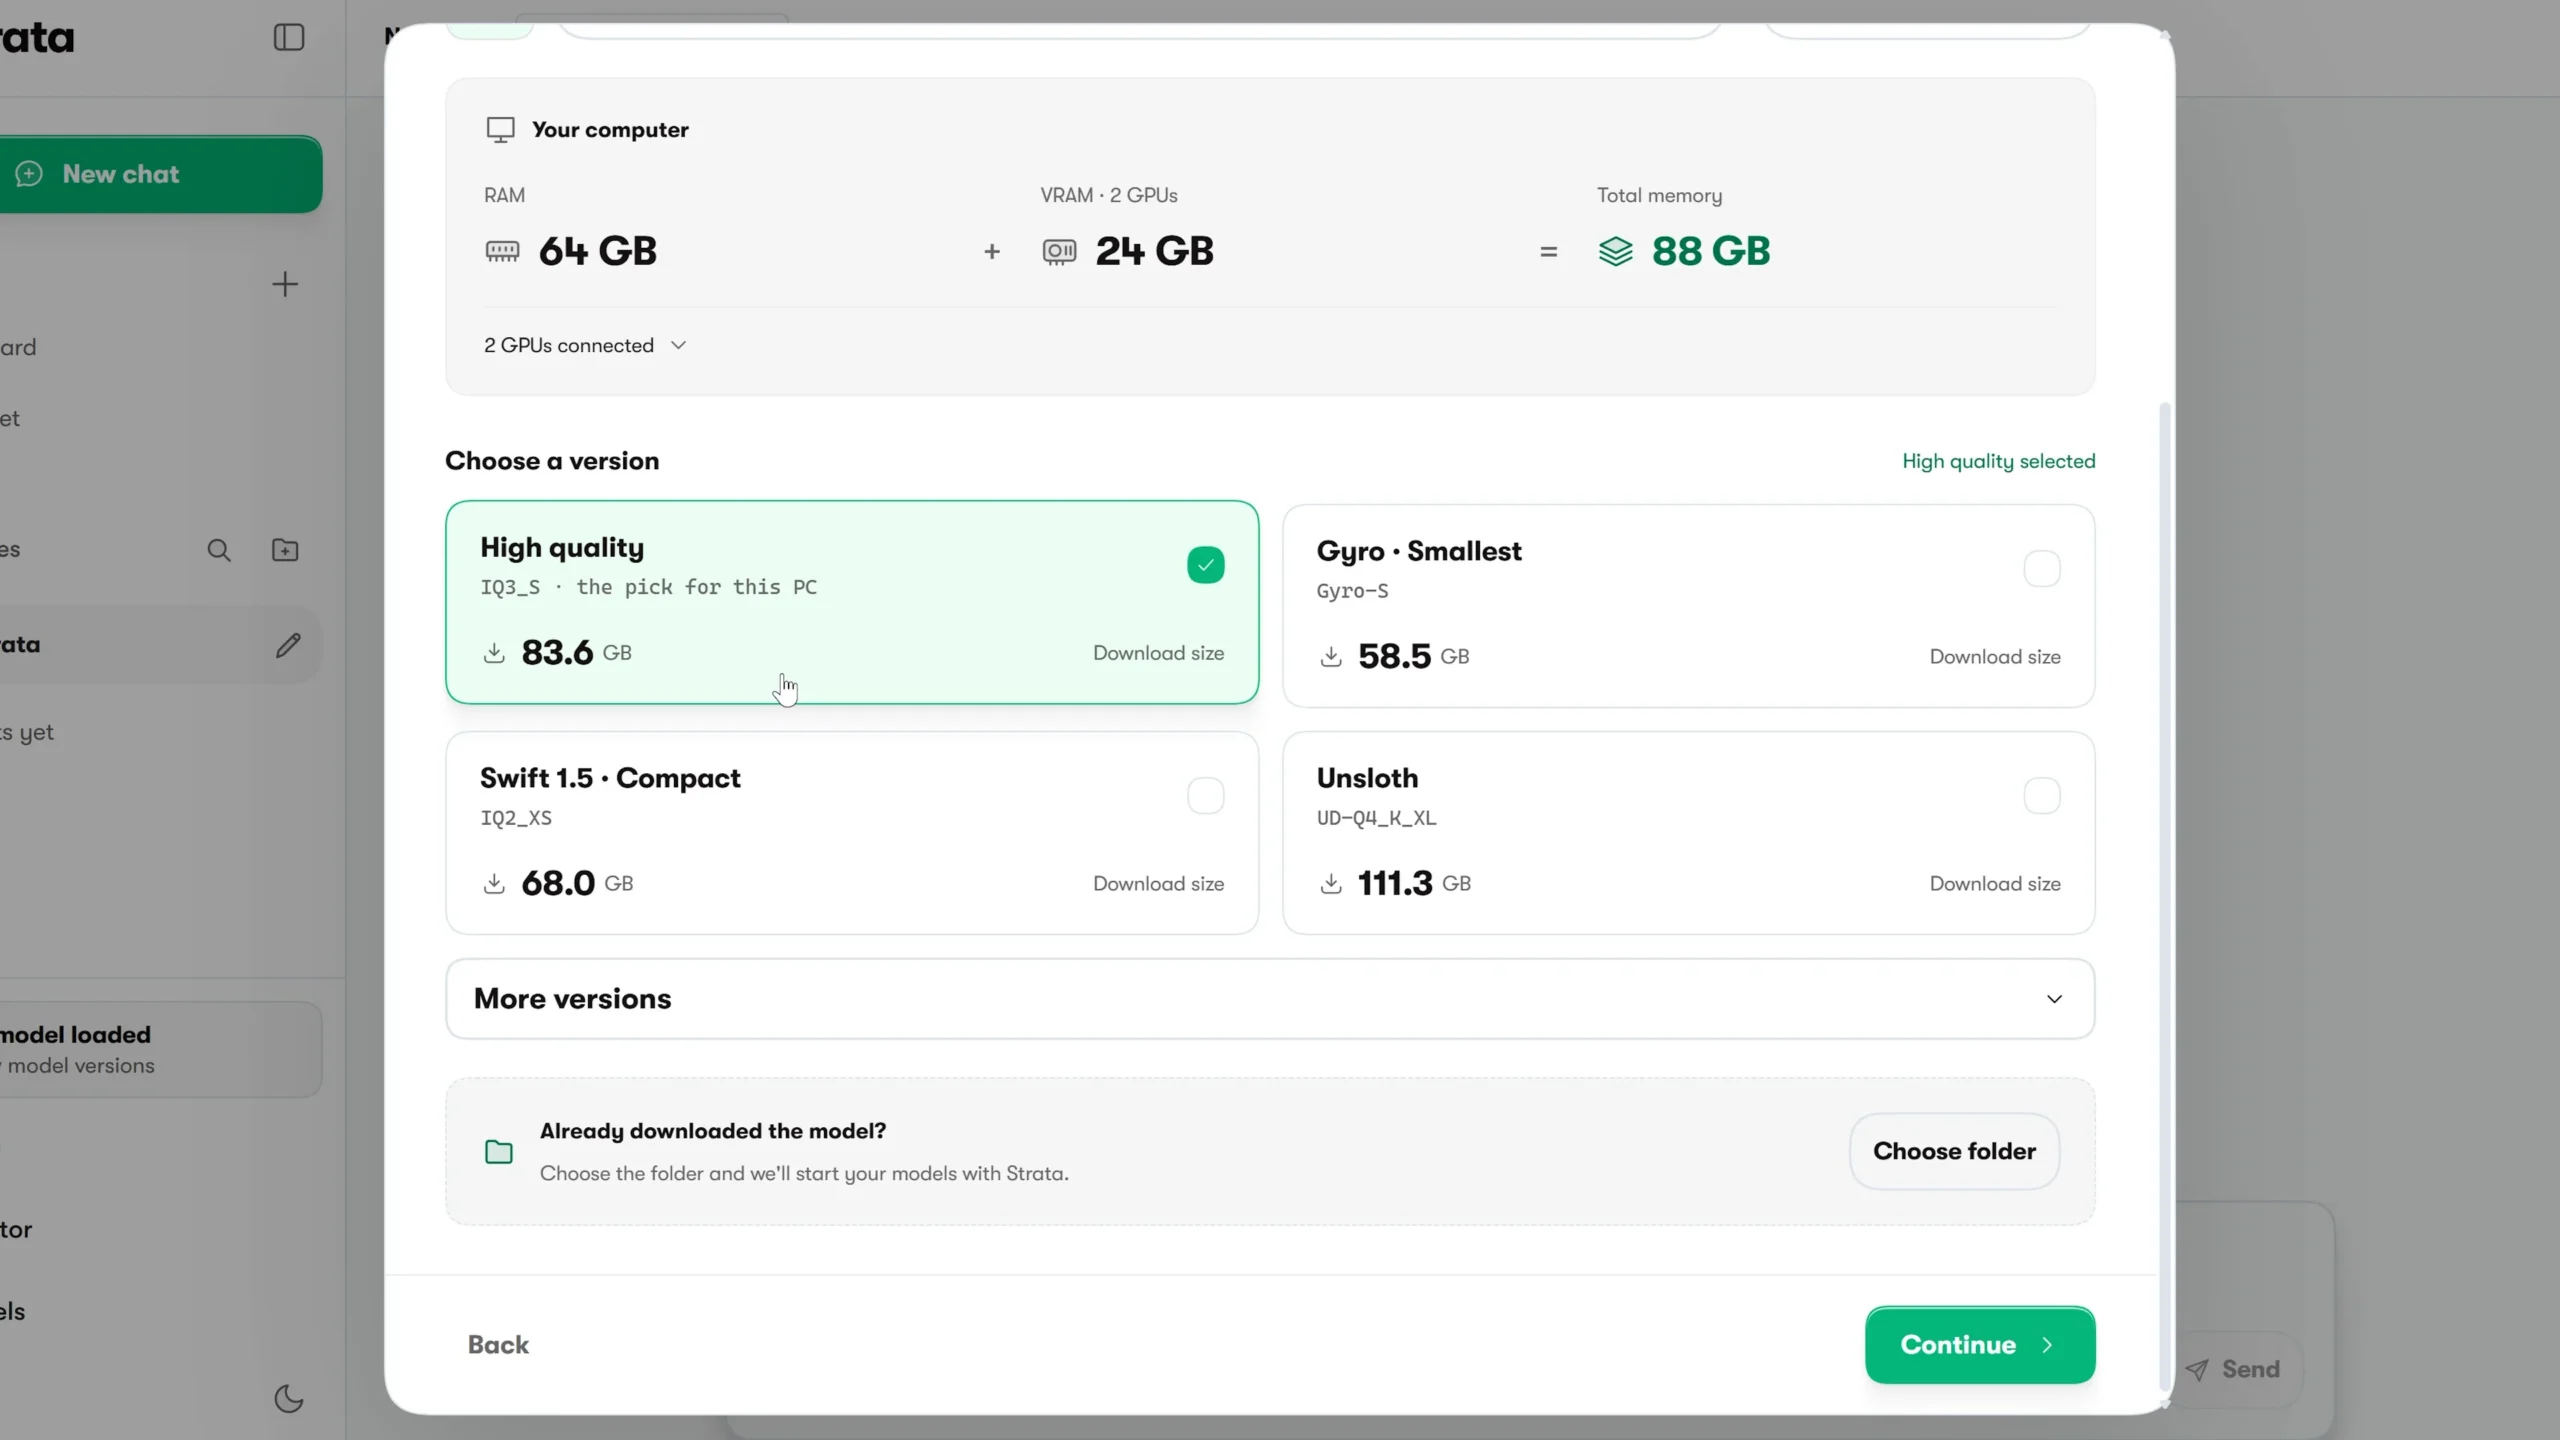
装好之后先别急着下载新模型。如果你手头已经有下载好的开源模型,可以直接复用,省下几十 GB 的下载时间和硬盘空间——125B 级别的模型就算经过量化,体积也不会小,下载前先确认硬盘余量够不够。
上手第二步:加载已有的本地模型
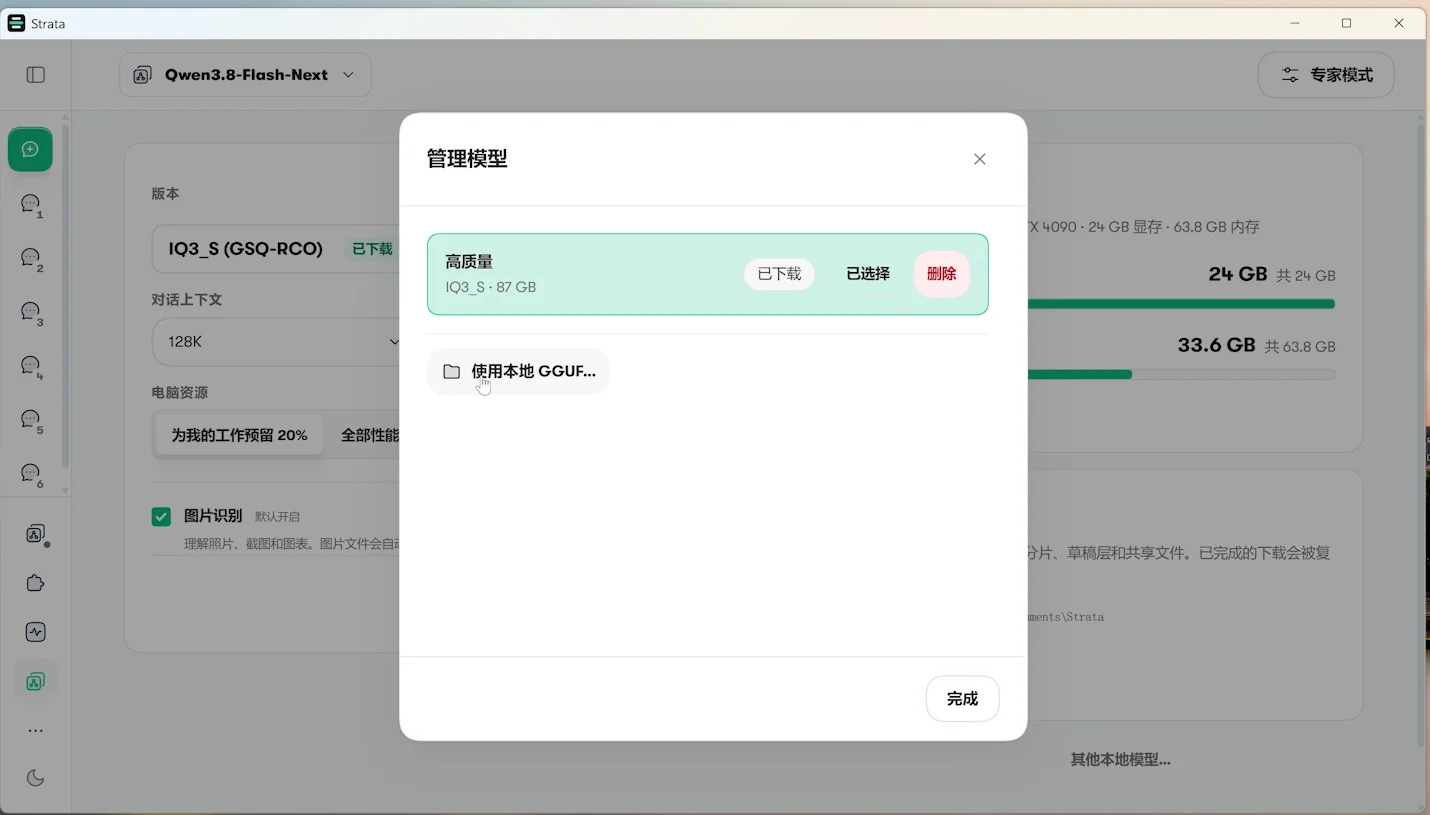
已经有 GGUF 格式模型文件的话,加载路径很直观:在左侧找到“模型”,进“管理模型”,选择“使用本地 GGUF 格式的模型”,把文件载入就行。GGUF 是目前本地部署最常见的模型文件格式,llama.cpp 生态的模型基本都是这个格式,之前用过 Ollama、LM Studio 之类工具的人应该不陌生。
自带的监控面板,值得多看一眼
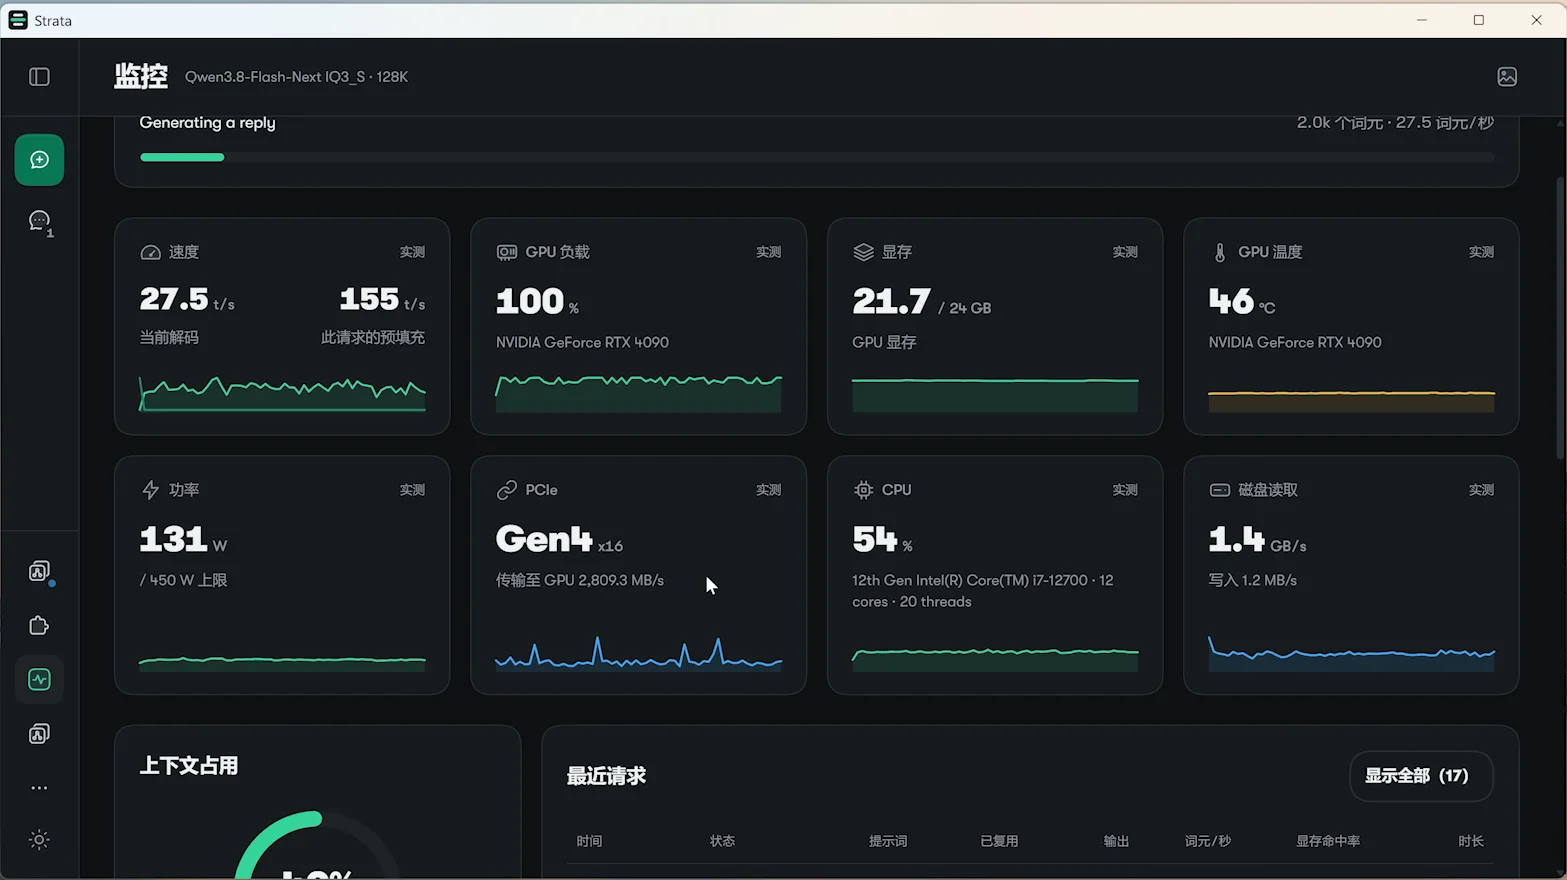
Strata 还自带一个监控面板,可以看到模型运行时的资源占用情况。刚上手的时候建议多盯着它看:显存占了多少、内存有没有吃满、有没有频繁读写硬盘。这些数字能直接告诉你,当前这套配置是游刃有余,还是已经在勉强支撑——比凭感觉调参数靠谱得多。
适合谁,不适合谁
如果你是这几类人,可以一试:手头有台配置一般的电脑,想体验大参数模型的效果;已经下载过 GGUF 模型,不想再折腾命令行;对生成速度要求不高,能接受慢慢出结果。
但如果你追求的是流畅对话、实时响应,或者电脑内存本身也不大、硬盘还是机械盘,那还是先降低预期,或者直接用小参数模型。分层加载能解决“装不下”的问题,但解决不了“算得慢”的物理规律。
一句话总结:Strata 不是什么魔法,它只是把显存、内存、硬盘这三层存储捏成一个能用的整体,让老电脑也有资格上桌。值不值得装,取决于你能不能接受“能跑,但不快”这个前提。