本地跑 AI 不用先啃部署教程:LocModel 按硬件挑模型,两个引擎装好就能用
本地跑开源模型,最劝退人的环节往往不是模型本身,而是前面的准备工作:装什么引擎、配什么参数、自己的显卡到底带不带得动哪一档。很多人就是卡在这一步,模型还没跑起来就先放弃了。
今天这篇讲的工具,思路就是把这堆准备工作收进一个软件里:先检测你的硬件,再推荐合适的模型,推理引擎也帮你装好,剩下的就是选模型、点运行。
一个软件里,能做的事比想象中多
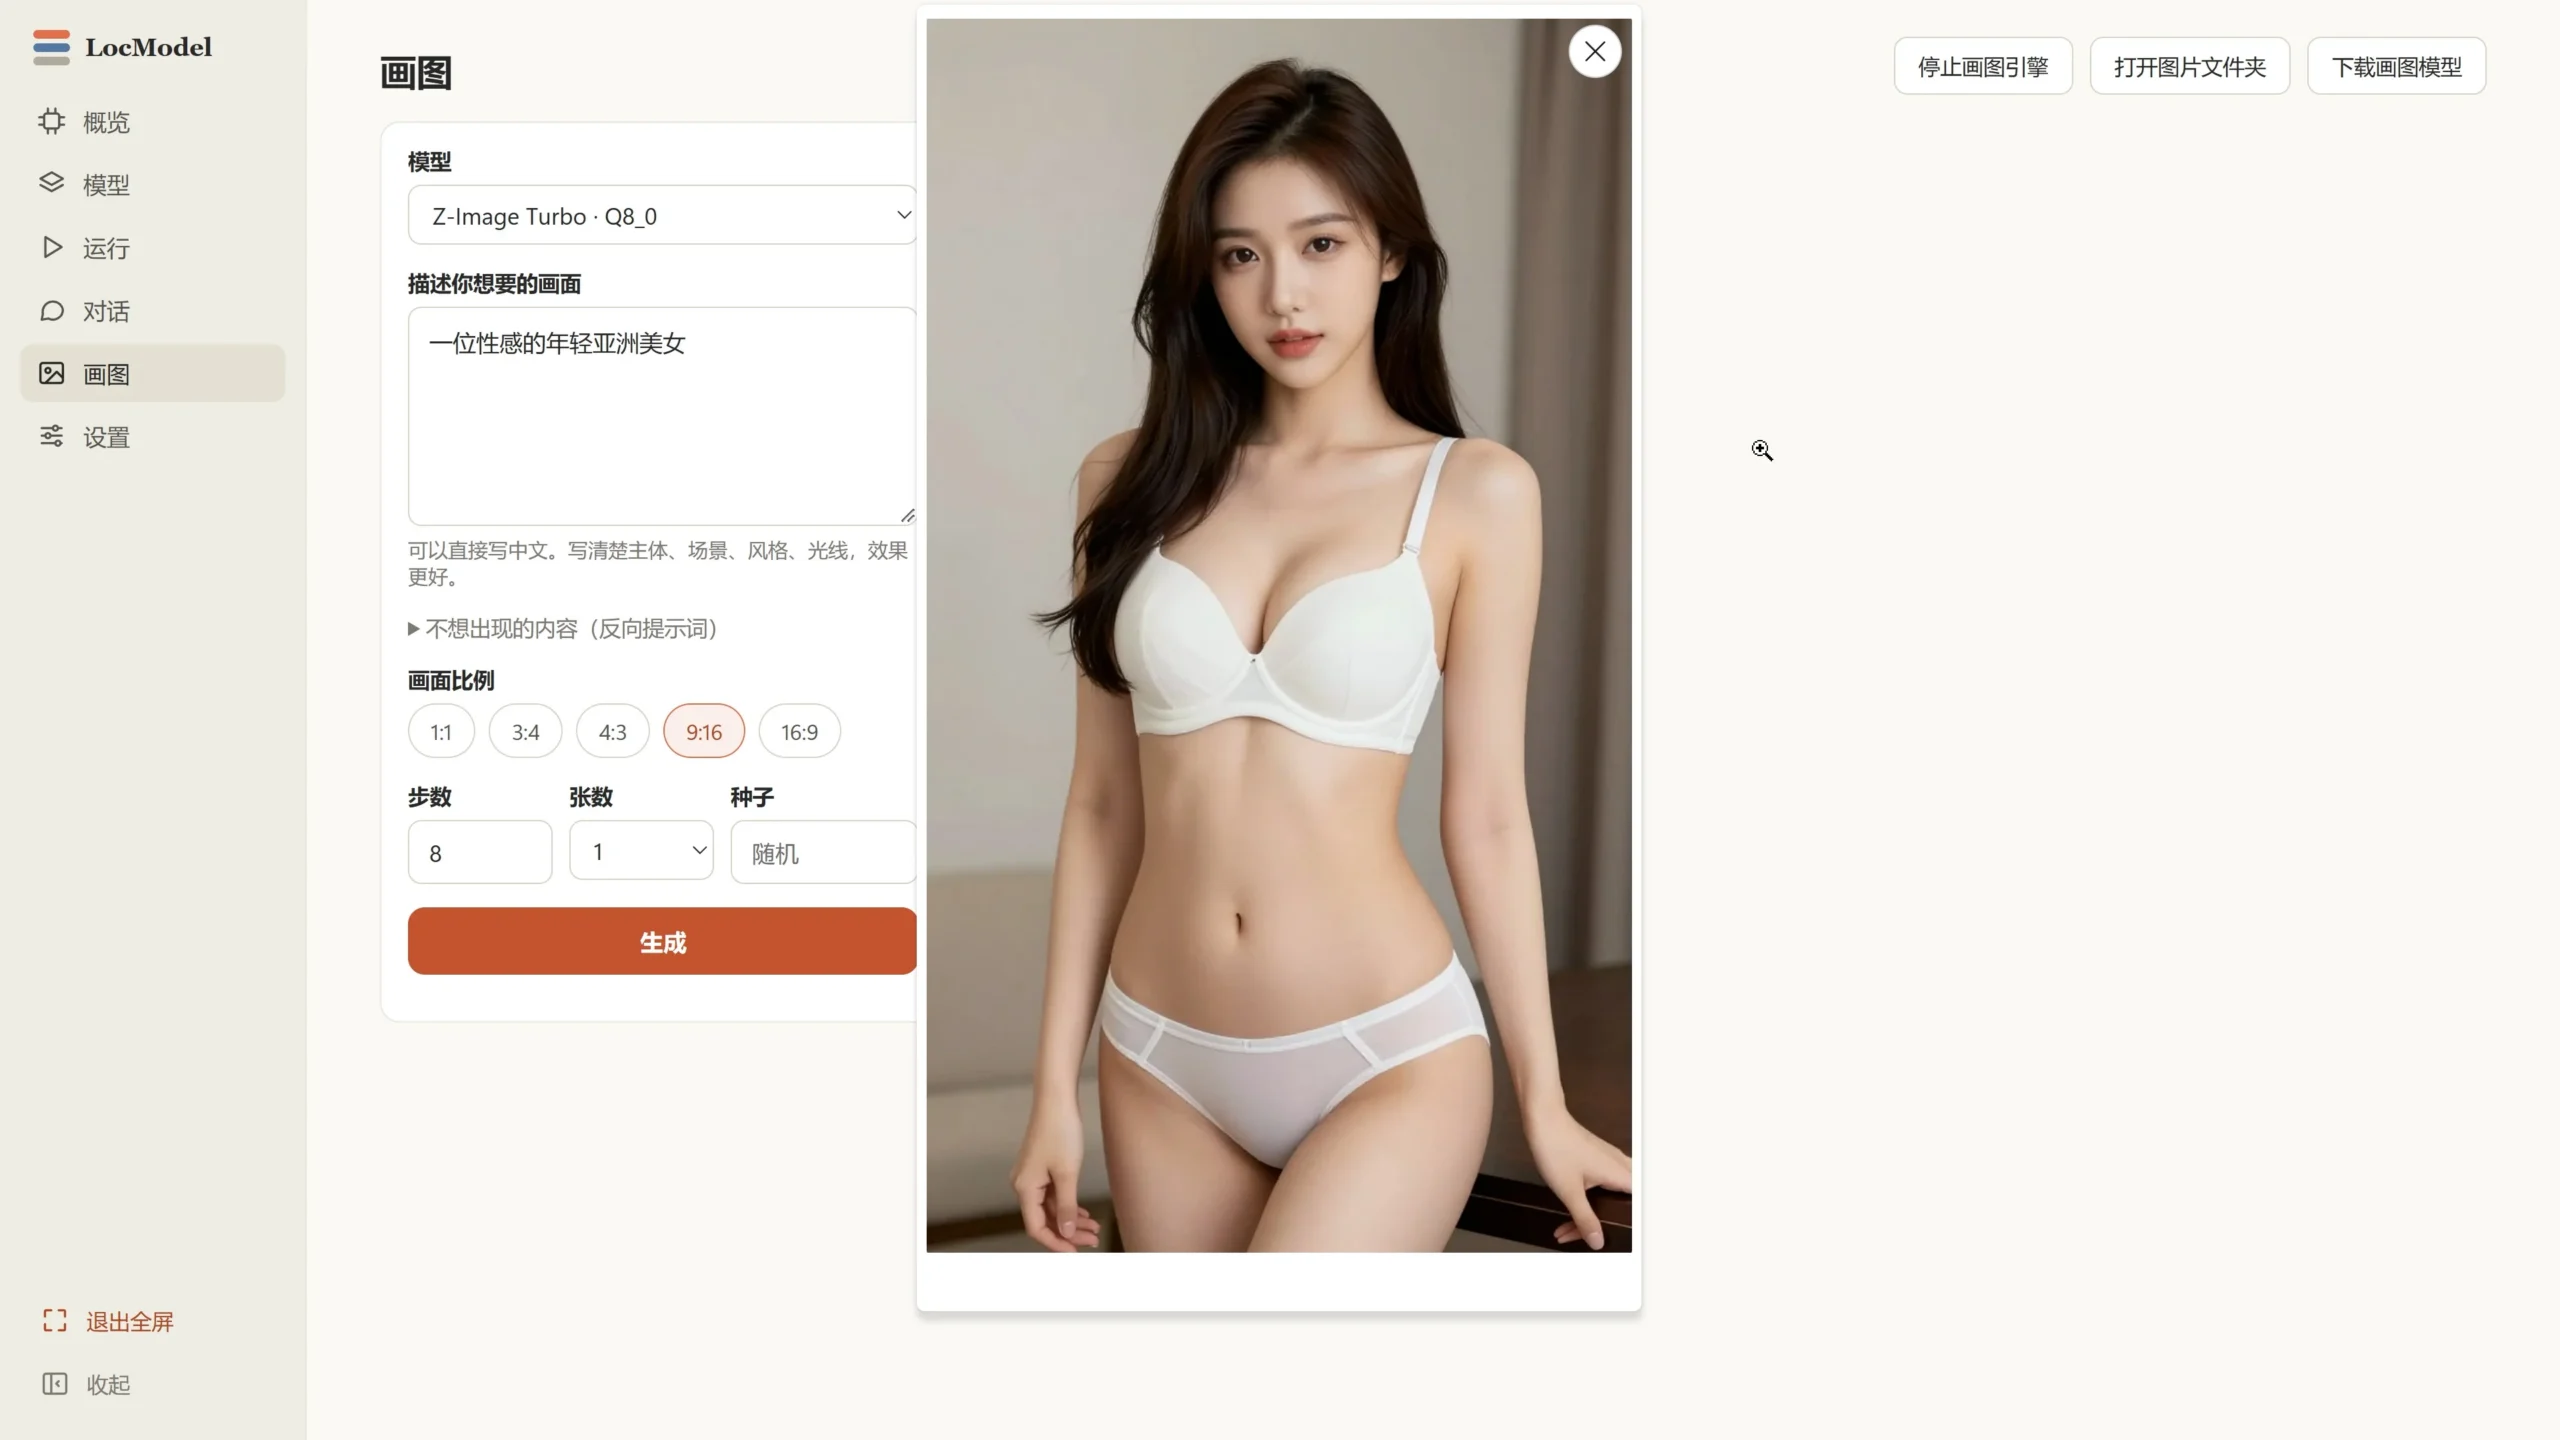
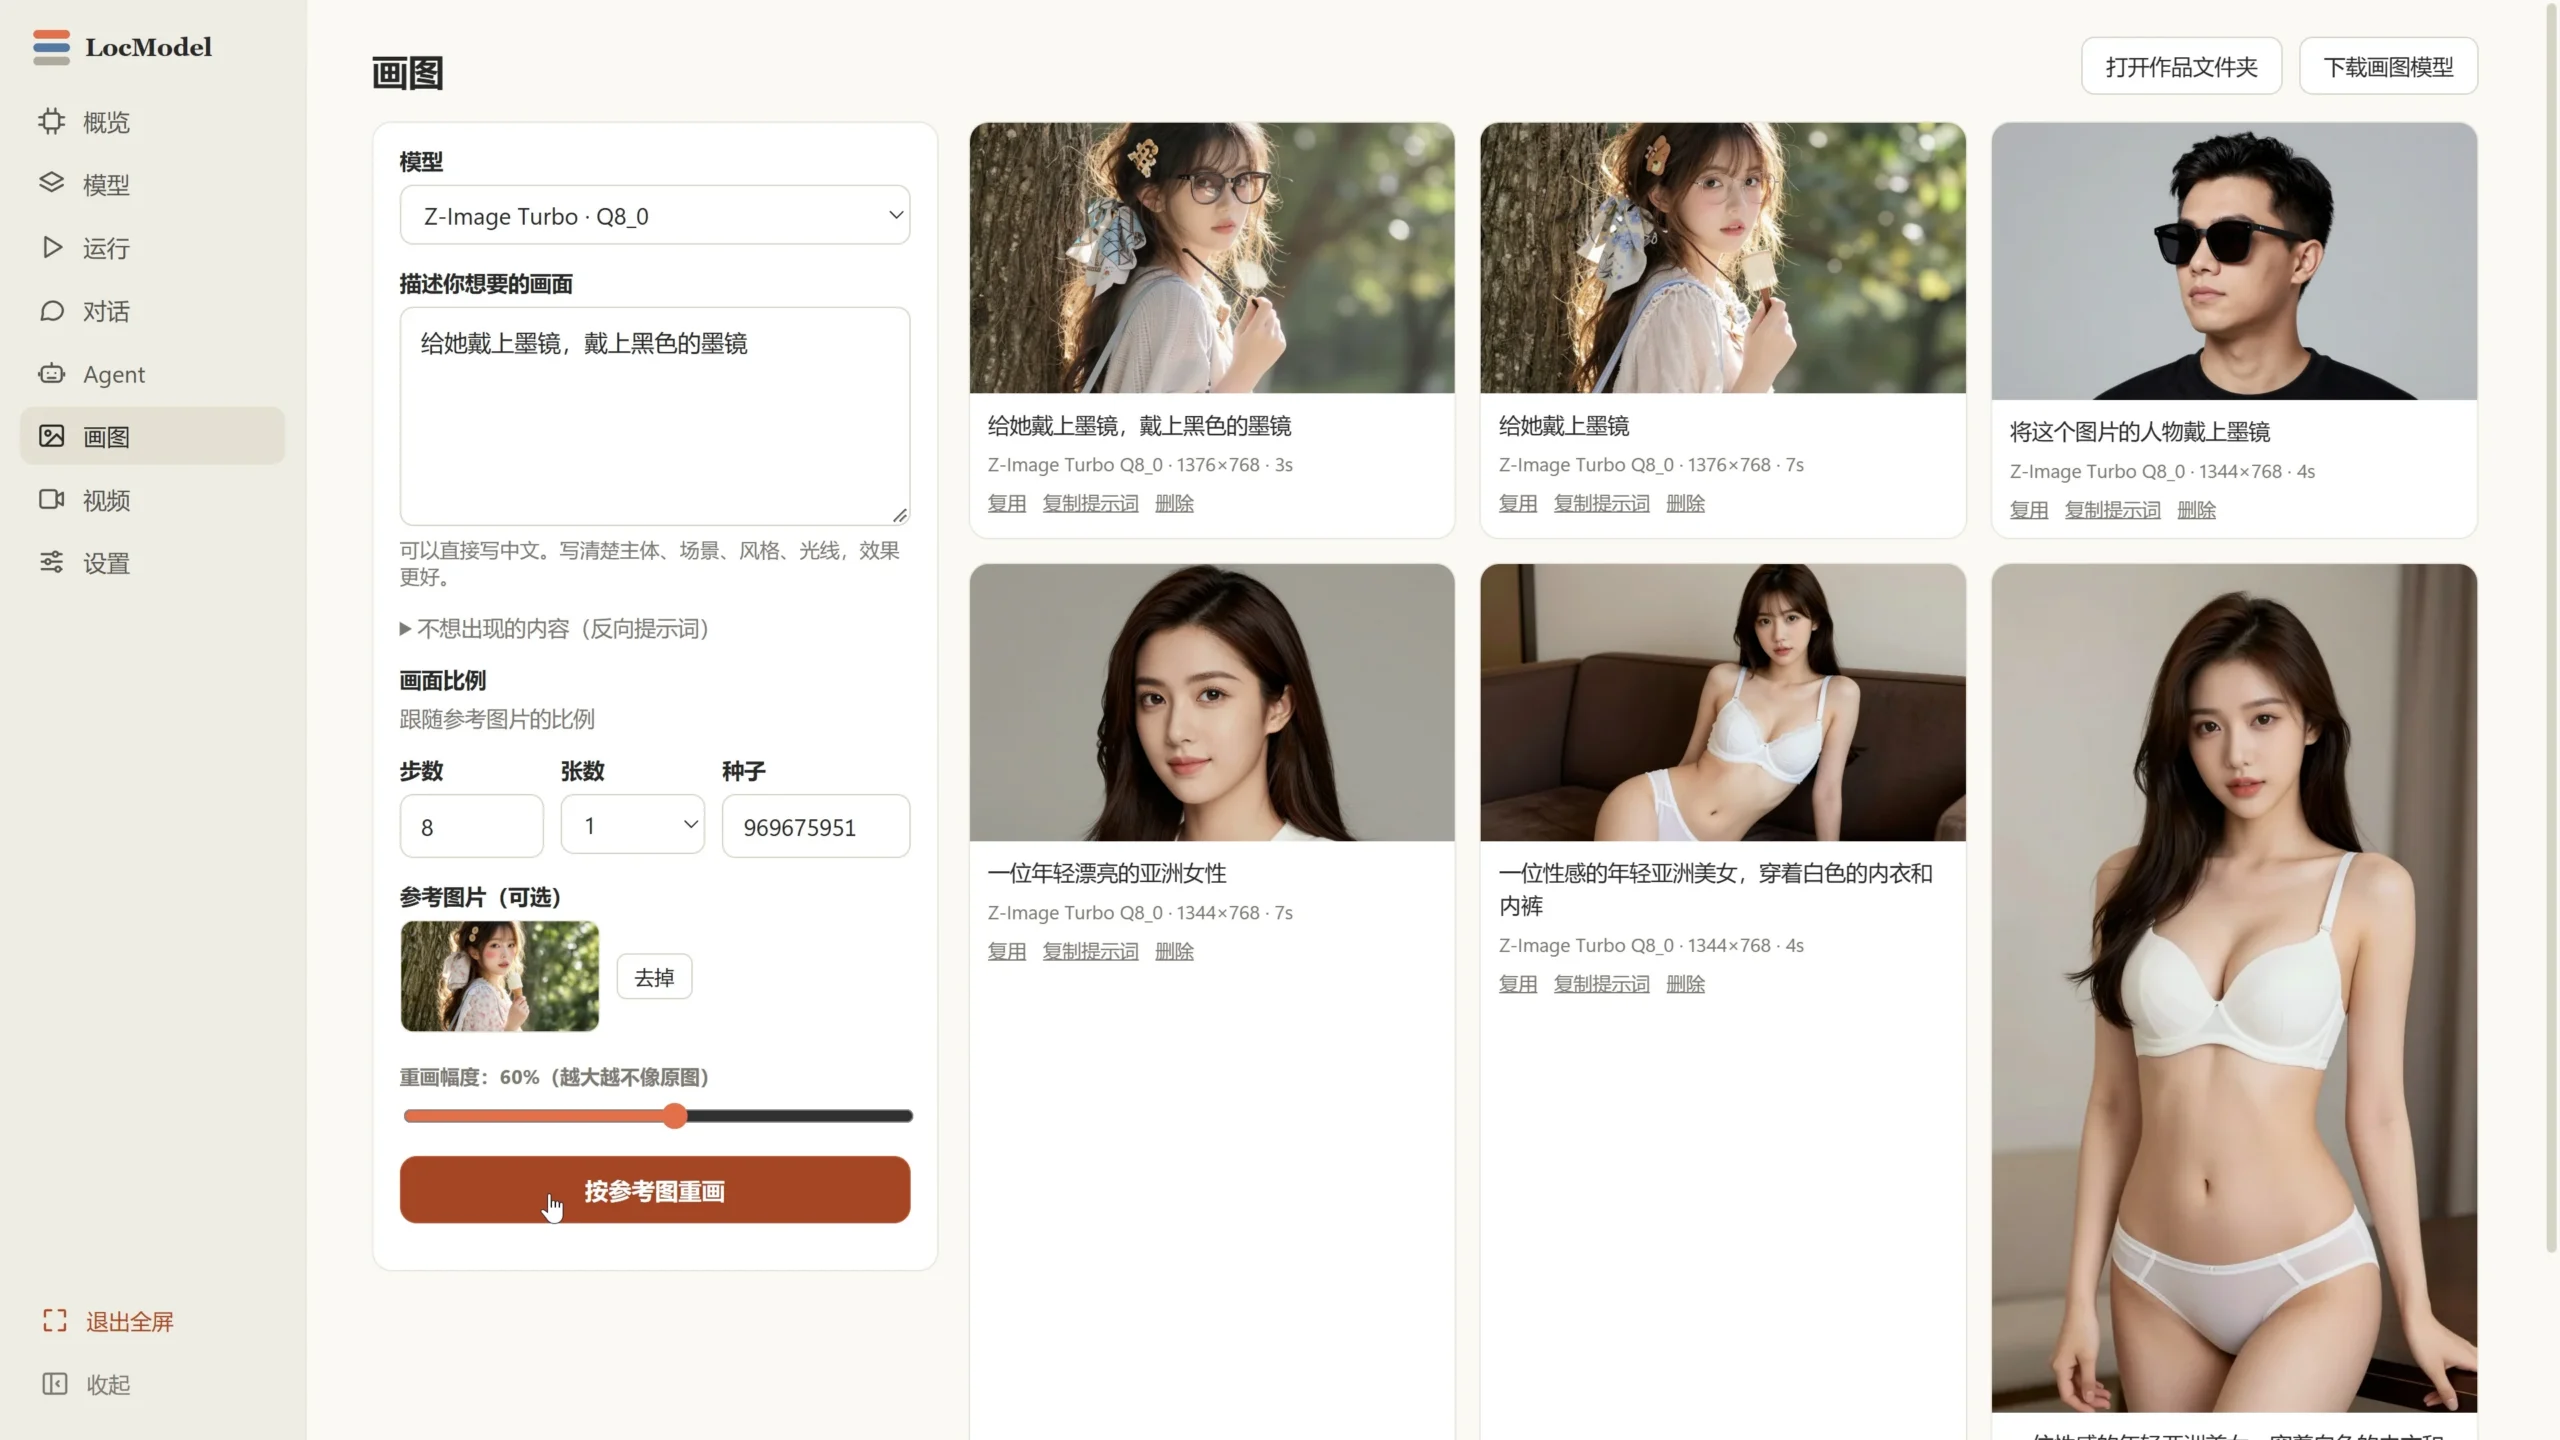
按发布方的介绍,LocModel 是一款免费的开源本地部署工具,覆盖的不只是大语言模型对话。它把图片生成、图片编辑、开源视频模型出视频,以及本地 Agent 都放在同一个界面里,不用在几个工具之间来回切换。
对普通用户来说,这个“合一”的意义很实际:以前想试图片、想试视频、想试 Agent,往往要各装一套环境;现在是同一套硬件检测、同一套模型管理逻辑,换任务的时候不用重新学一套流程。
显存不够,也不是只有“换显卡”一条路
很多人一听本地部署就先看显存,觉得不够就没戏。按发布方的说法,这款工具针对不同硬件做了优化:权重可以按显存、内存、硬盘来分工加载,显存放不下的部分可以由内存和硬盘辅助承担。
这句话要正确理解:它降低的是“能不能跑起来”的门槛,不是把低配机器变成高配。权重一旦大量落在内存甚至硬盘上,生成速度一定会慢下来,更适合不赶时间的任务,不适合指望它实时对答。先接受这个速度预期,再决定要不要用这条路。
模型怎么来,也有两种方式:一是在线下载,二是手动导入你之前已经下载好的模型。导入格式是 GGUF,装好之后也可以离线使用,比如在本地写代码、做对话,不用一直联网。这个设计对已经玩过一阵的人很友好:以前在别处下载好的模型文件不用扔,直接导进来就能接着用;对新手来说,在线下载则省掉了找文件、辨格式的麻烦。
硬件兼容面挺宽:三家显卡都能用,实在不行还能走 CPU
兼容性是这款工具另一个值得单拎出来的点:按发布方口径,它兼容 NVIDIA、AMD、Intel 三家显卡,配置实在不够的时候还可以调用 CPU 来运行模型。
这意味着选模型之前不用先纠结品牌,先让工具检测一遍,看看它给你的机器判的是哪一档,再按档位选模型,比凭感觉下载要靠谱得多。下载可以去LocModel 官网。
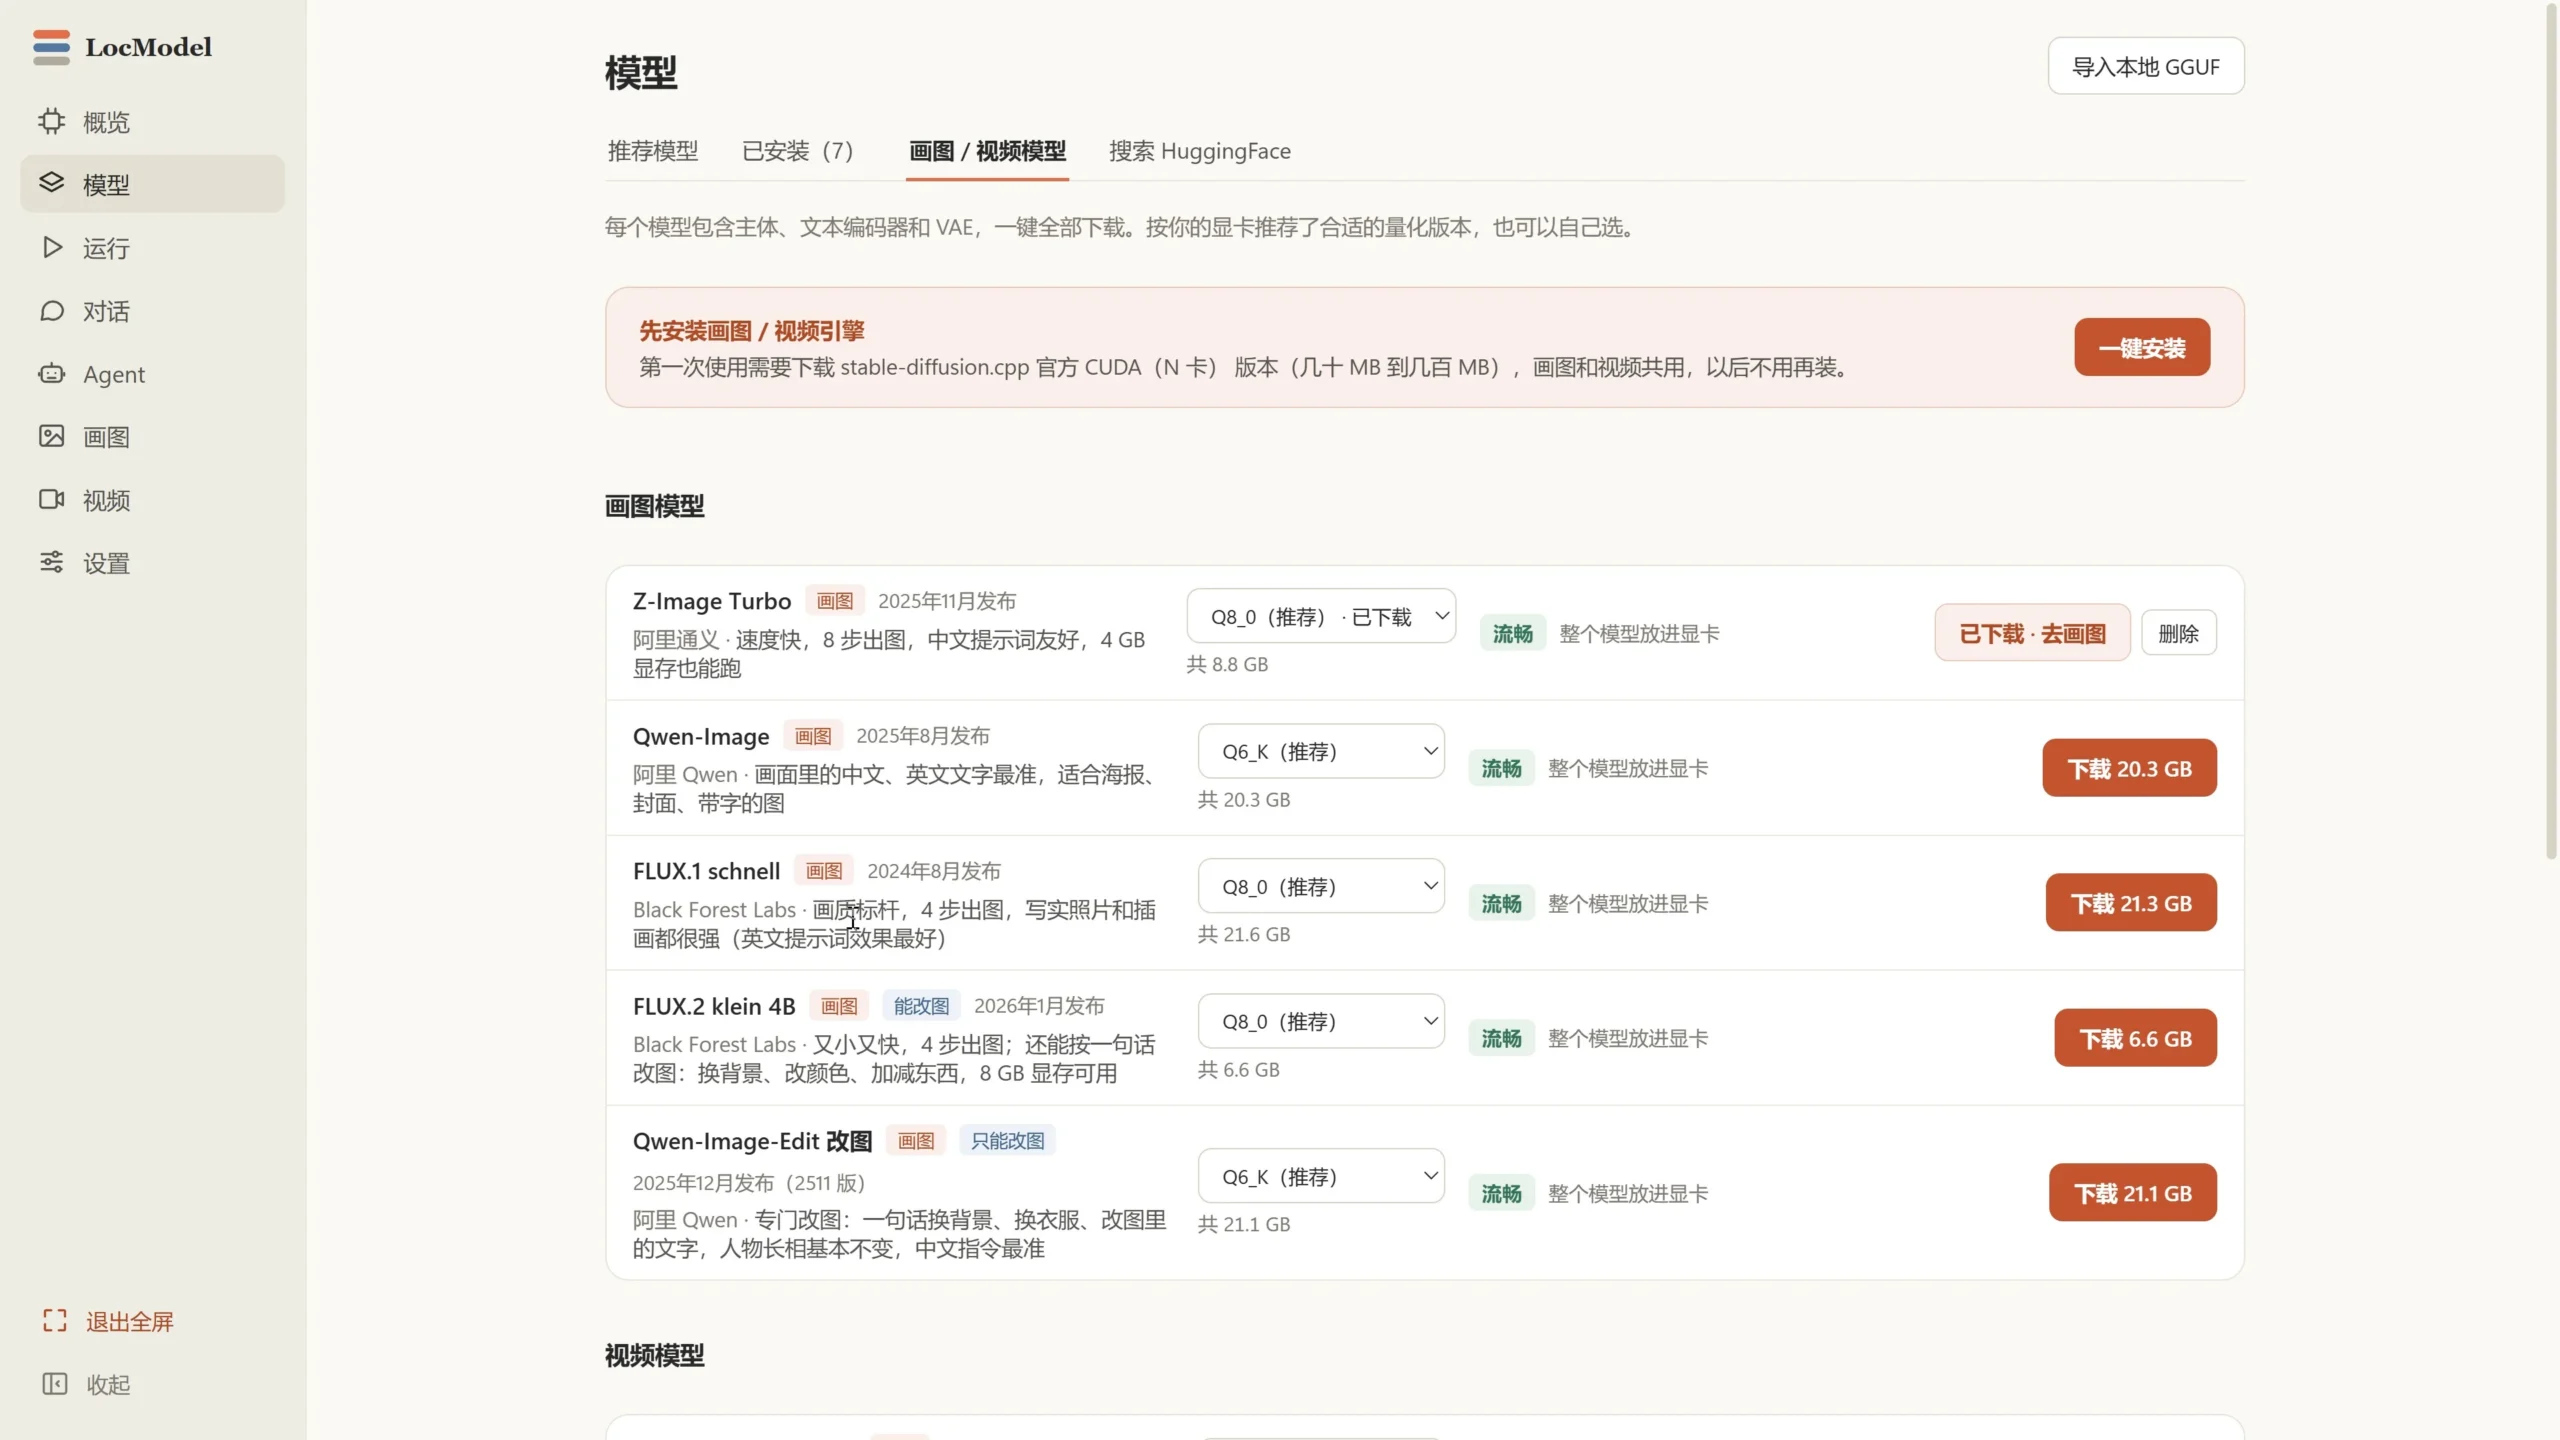
安装时要装的,其实是两个引擎
下载安装之后,工具会提示安装推理引擎,一共两个:一个是面向大语言模型的 llama.cpp 开源框架,另一个是图片、视频生成引擎。点下载安装即可,不用自己分别去找、去配。
这个步骤值得单独说一句:很多本地部署教程的篇幅,其实都花在引擎和依赖上。工具把这一步收起来之后,新手真正要做的就只剩下“选模型”和“等下载”这两件事。
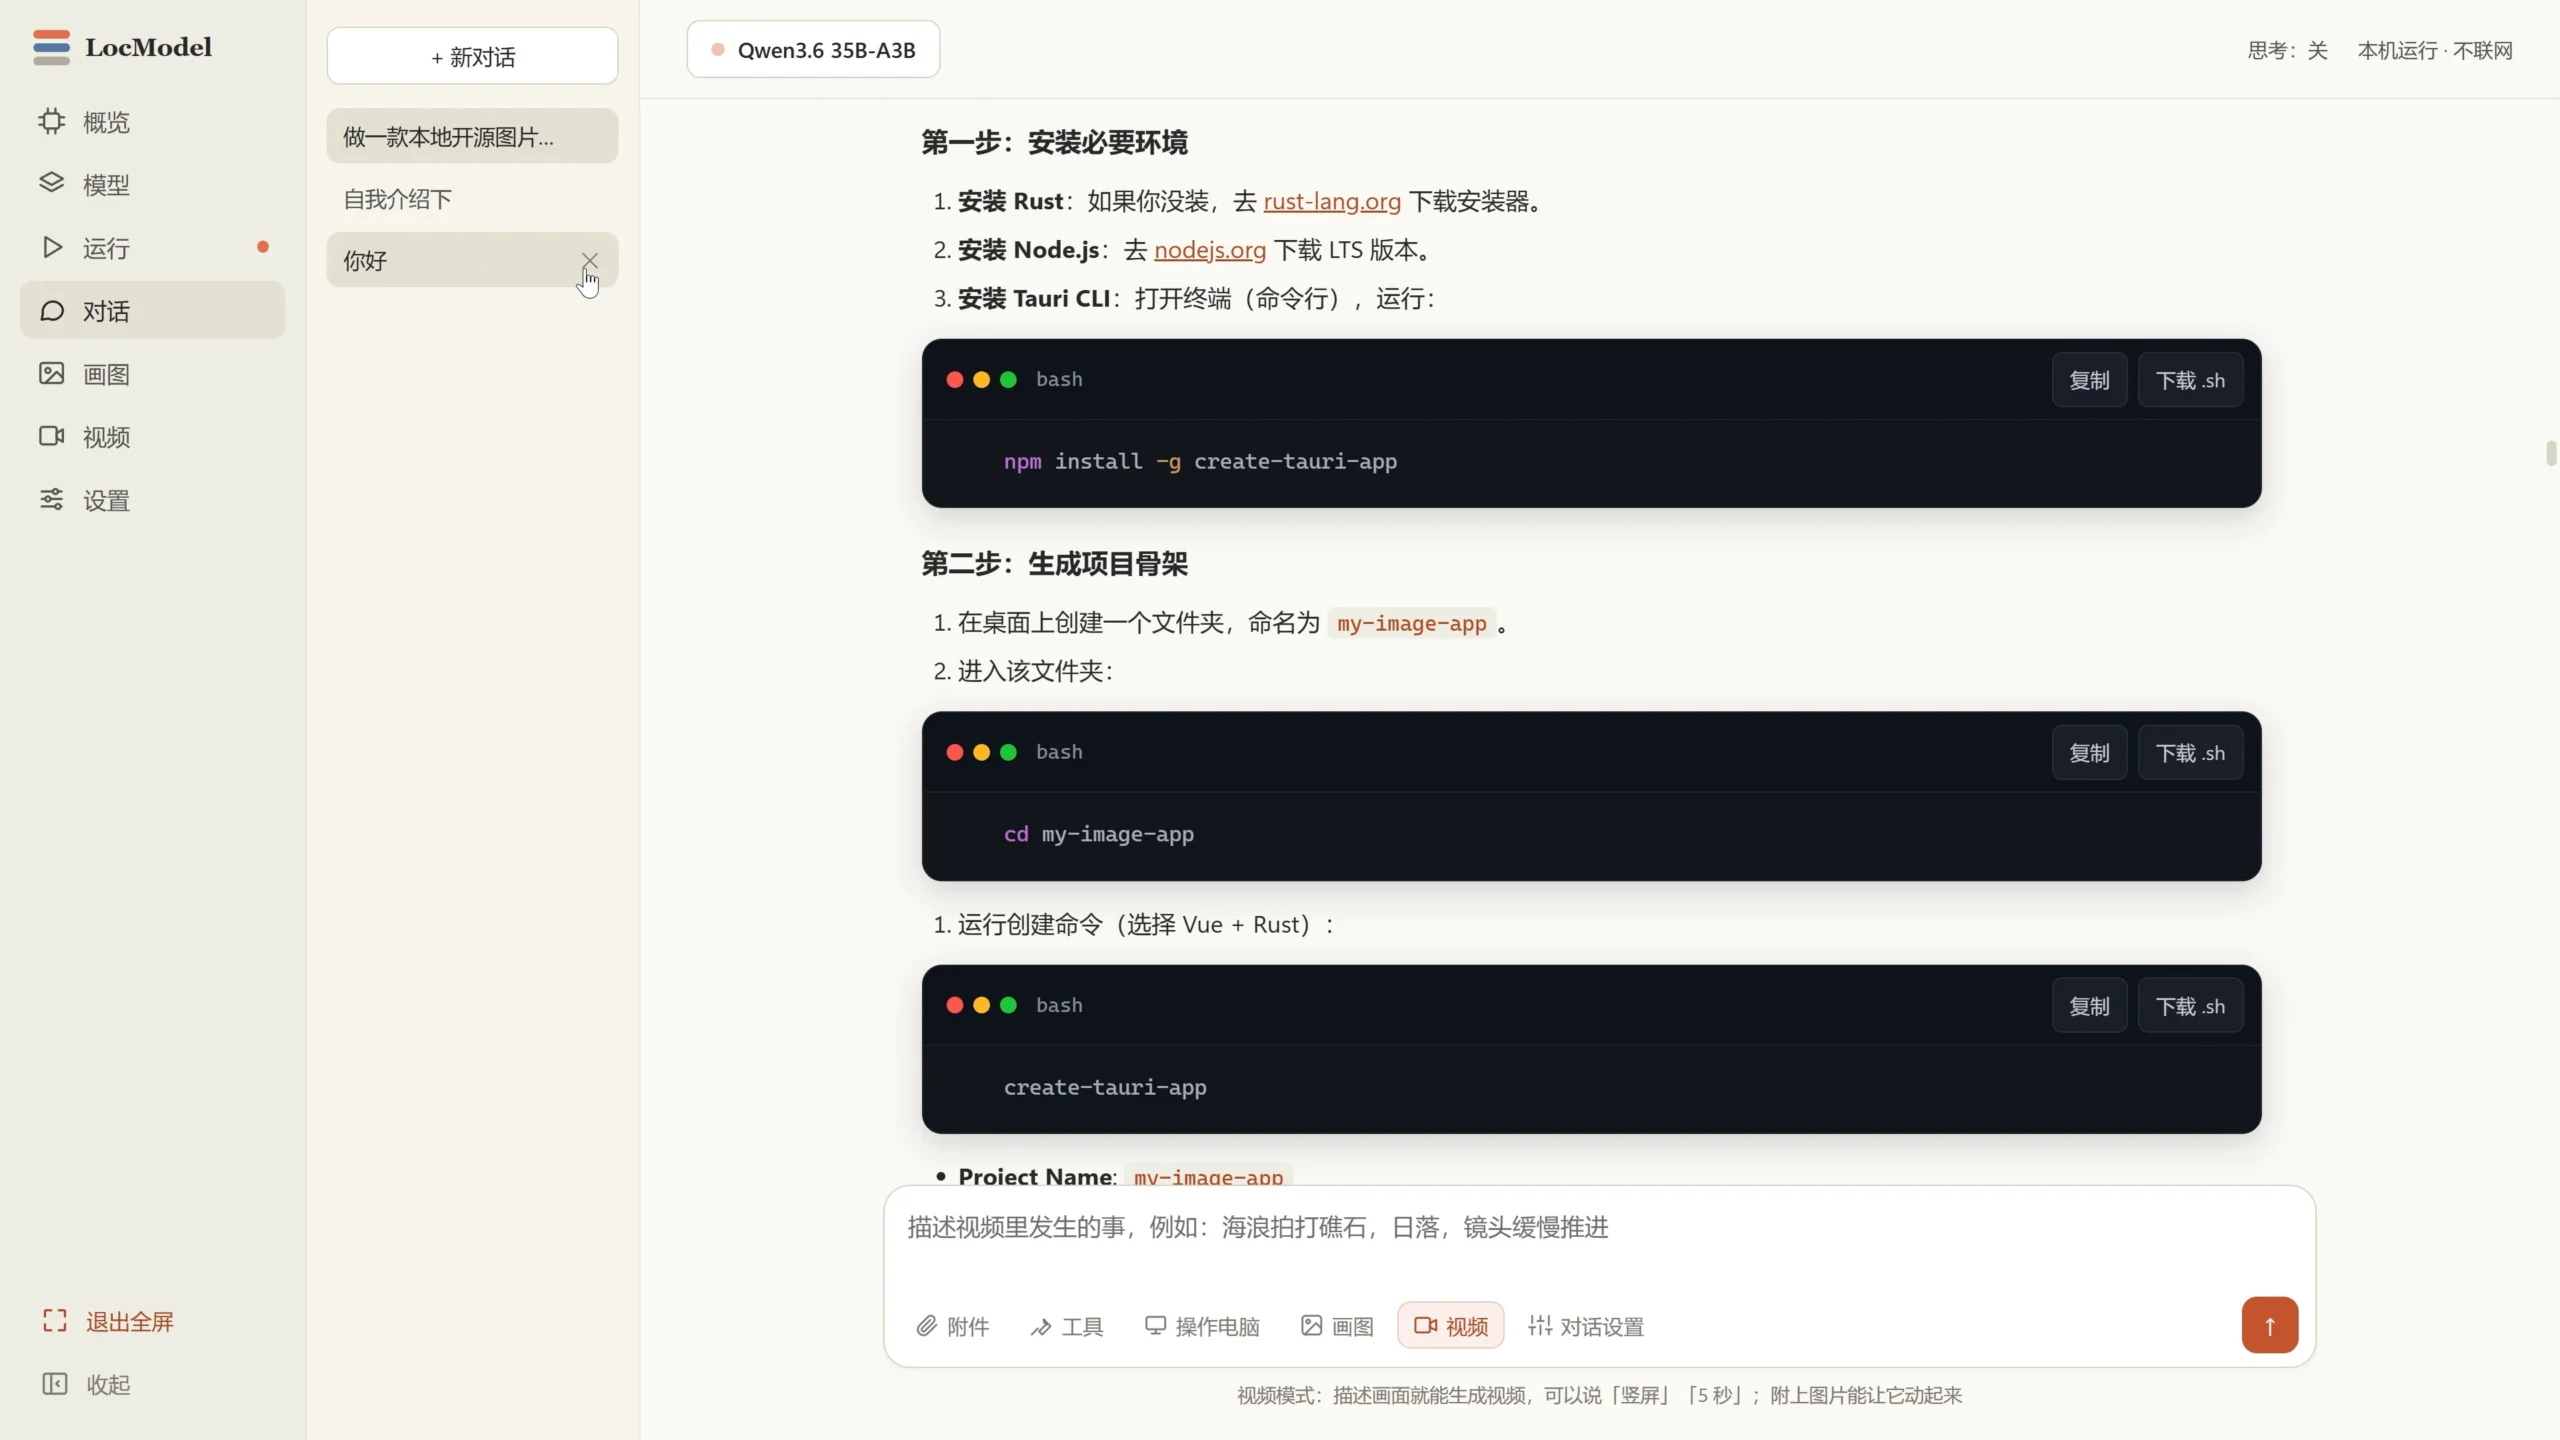
图片、视频、Agent:分别能干什么
图片这块,工具支持生成图片和编辑图片,都在本地完成;视频这块,则是调用开源视频模型来生成,同样不需要跳转到别的软件。
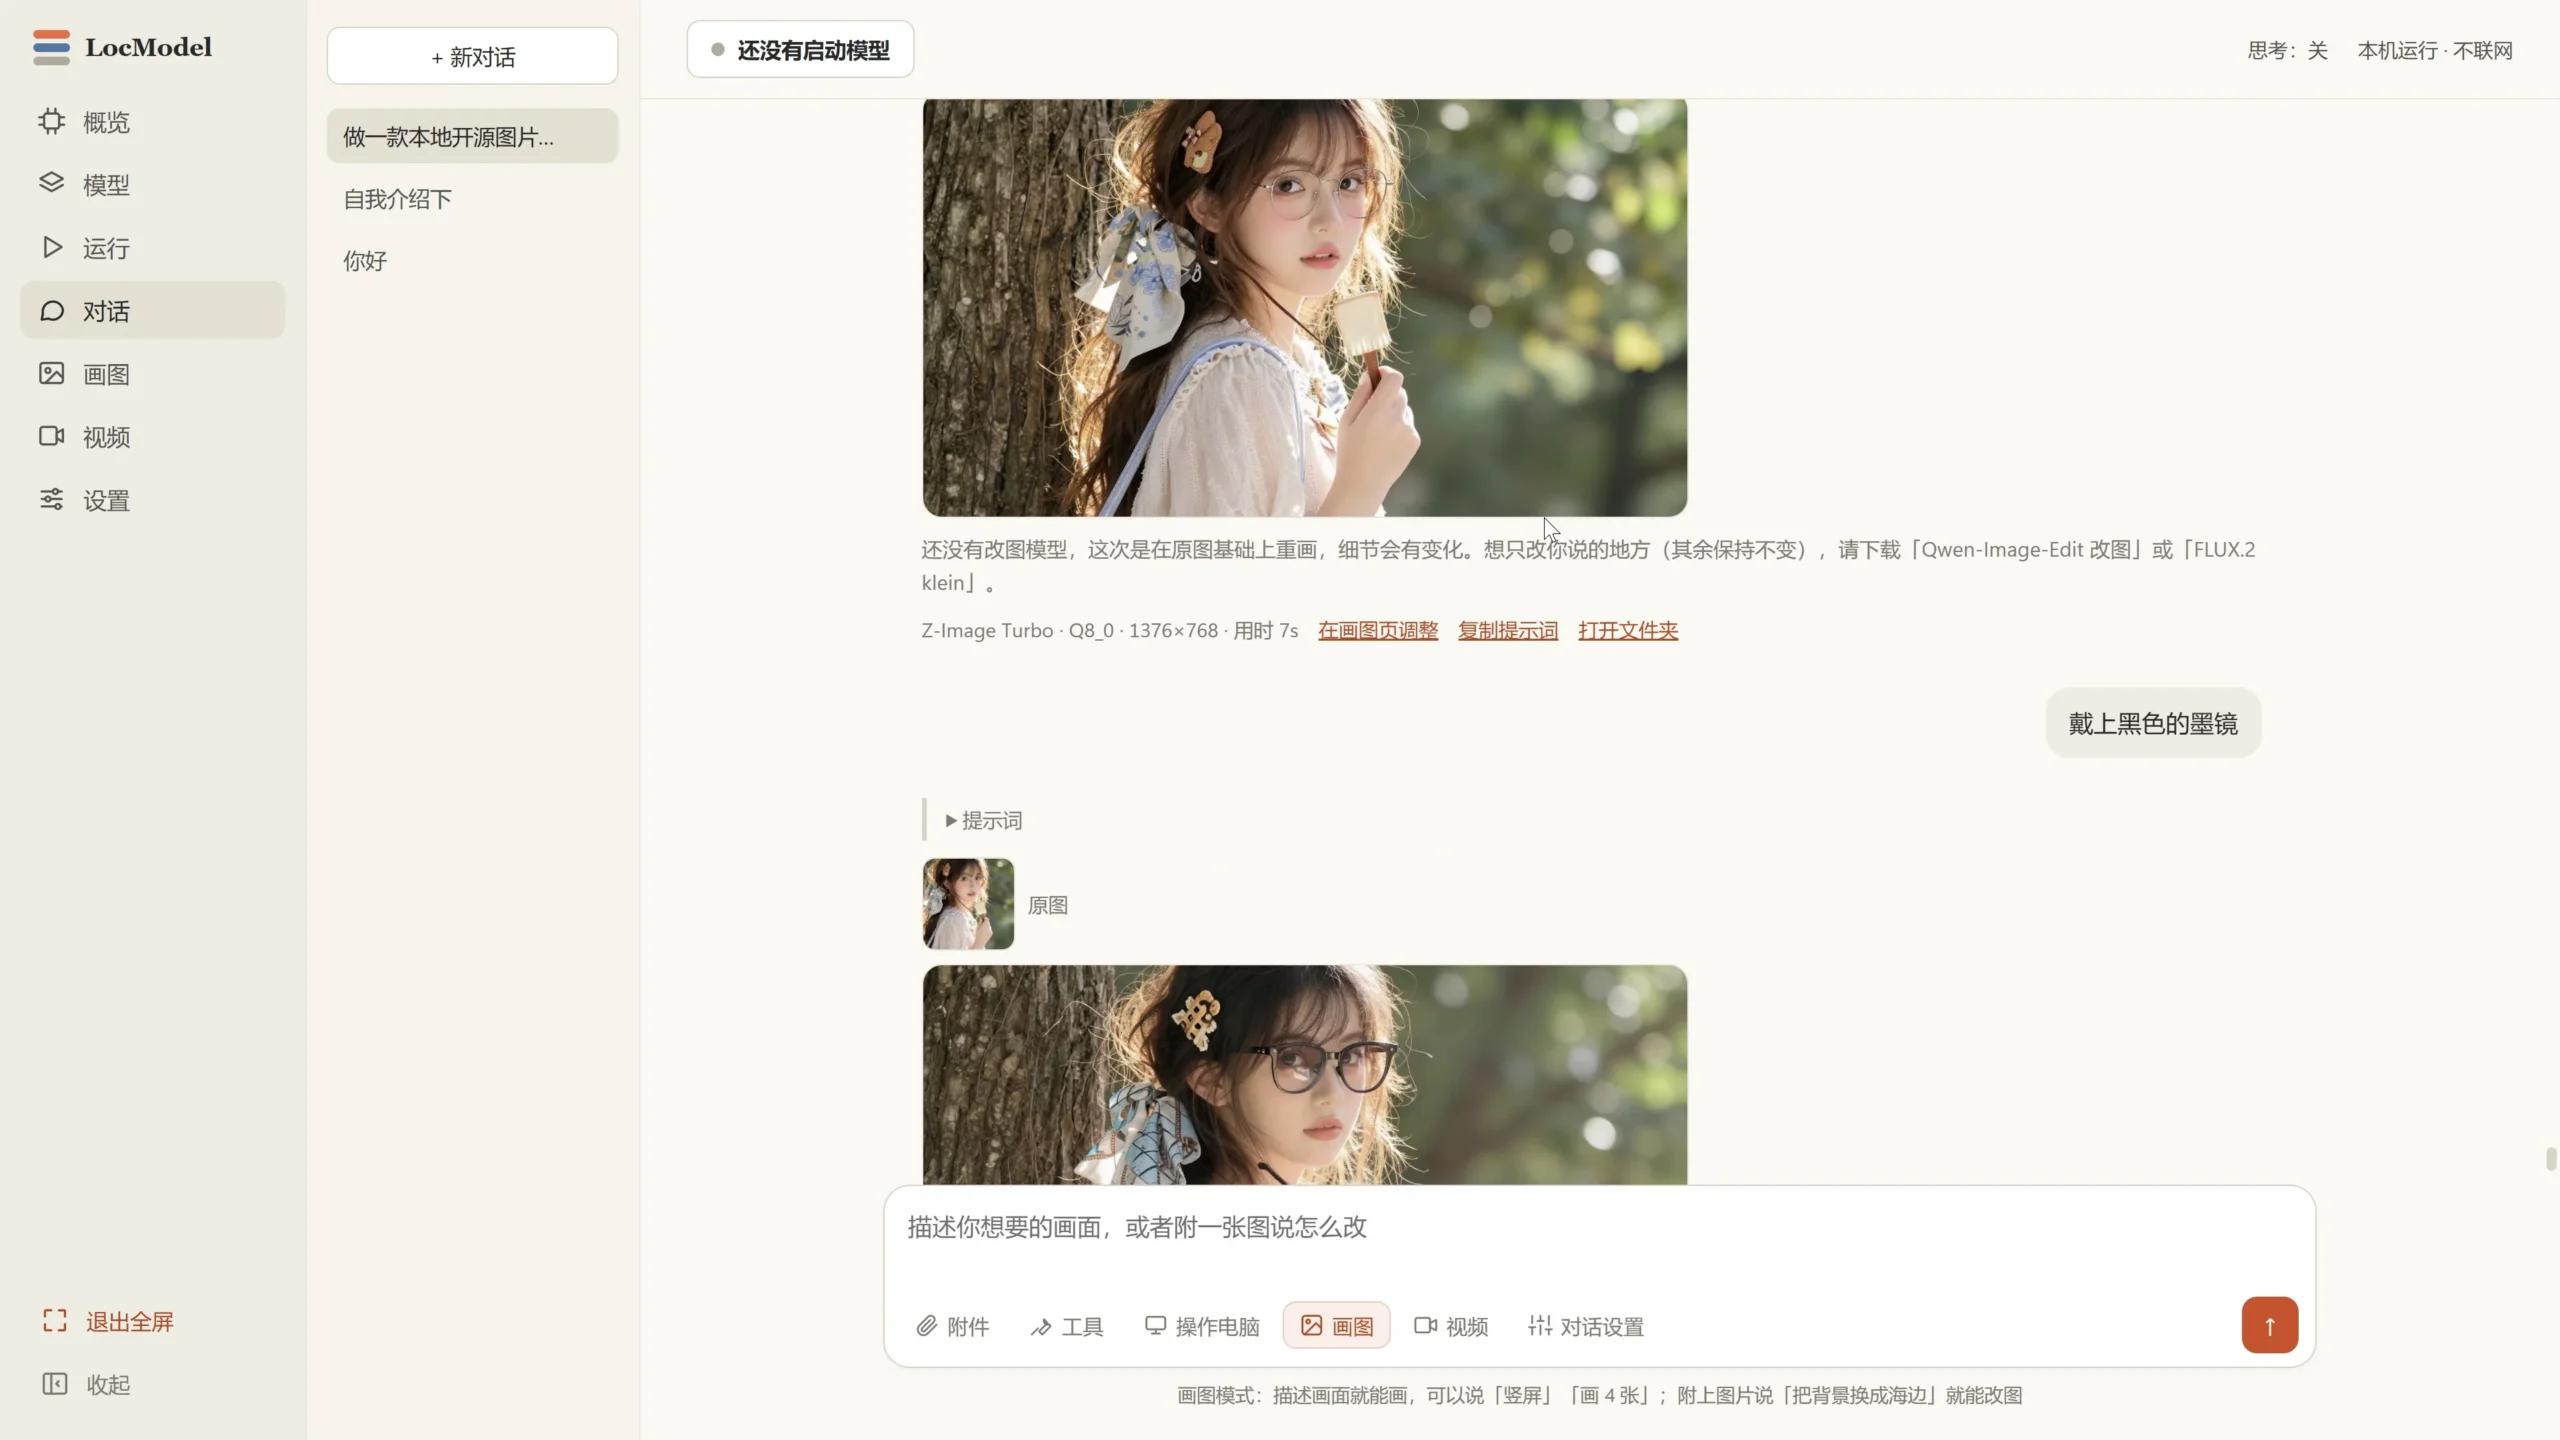
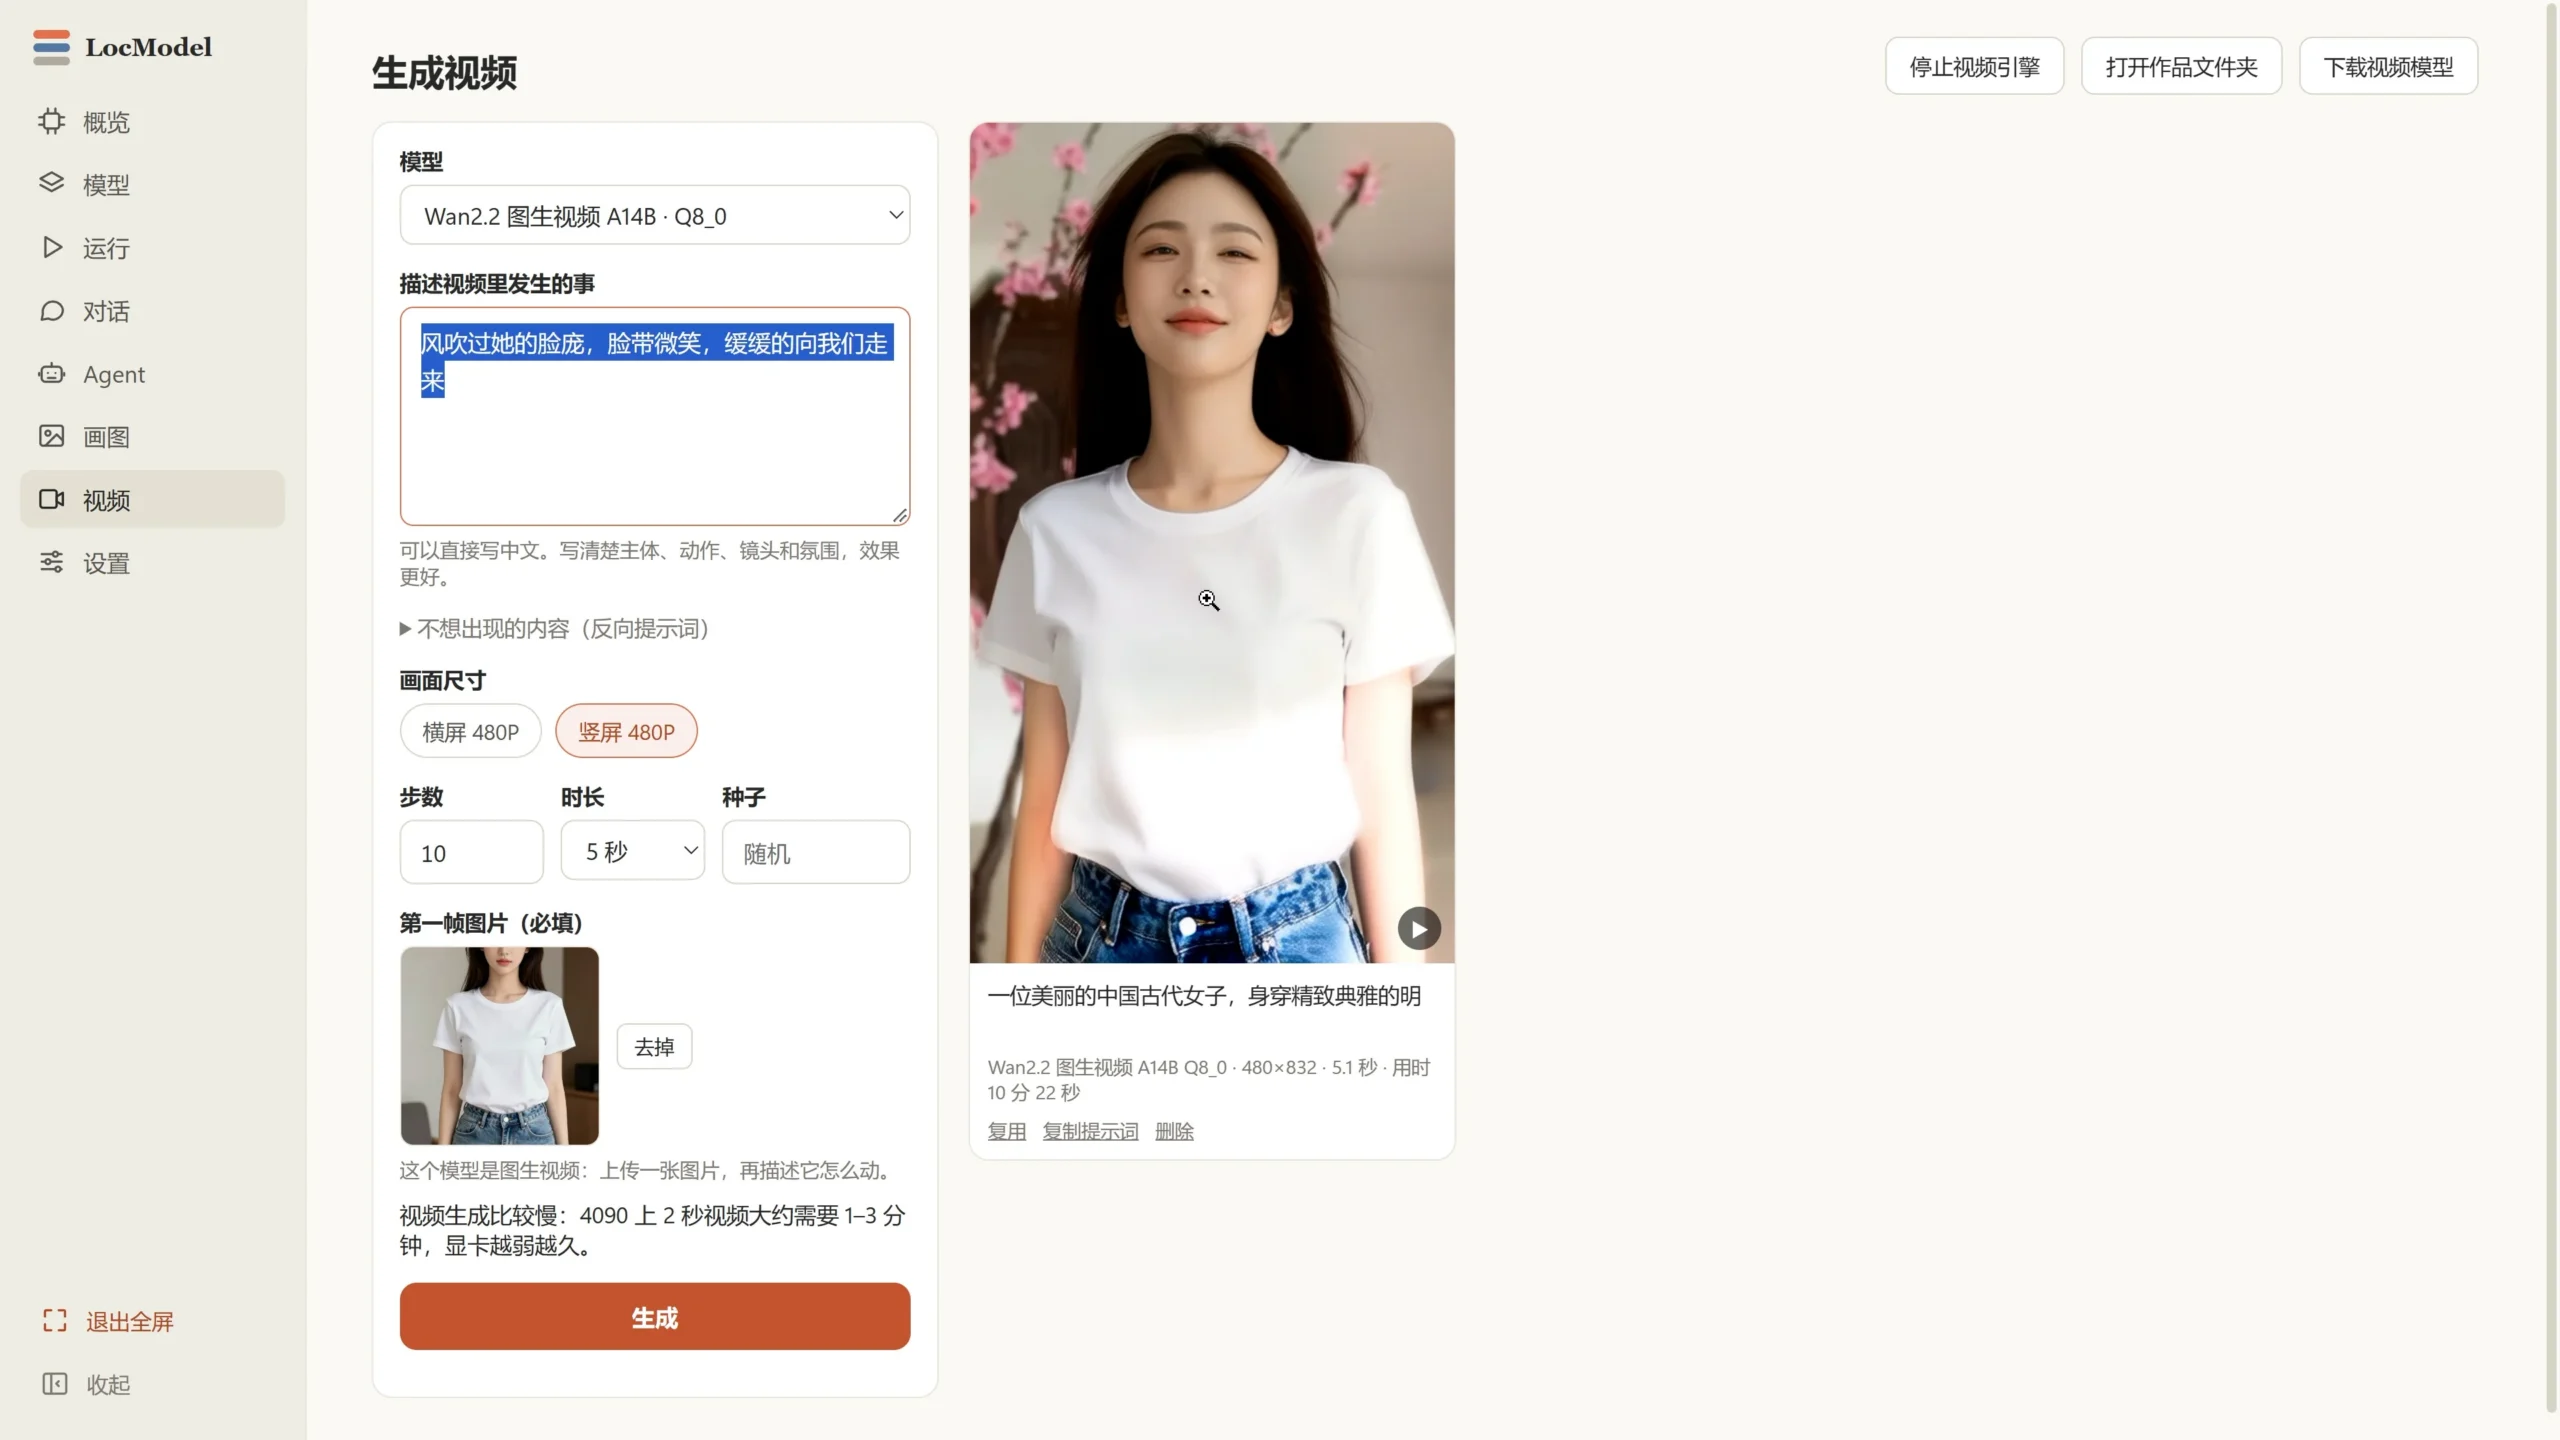
Agent 是相对容易被低估的一块:它支持用本地模型来执行比较复杂的长任务。也就是说,本地模型在这里不只是用来聊天的,还可以作为执行层去跑多步骤的任务。当然,效果上限还是取决于模型本身和你的任务描述,别指望小模型一上来就顶得上云端大模型。
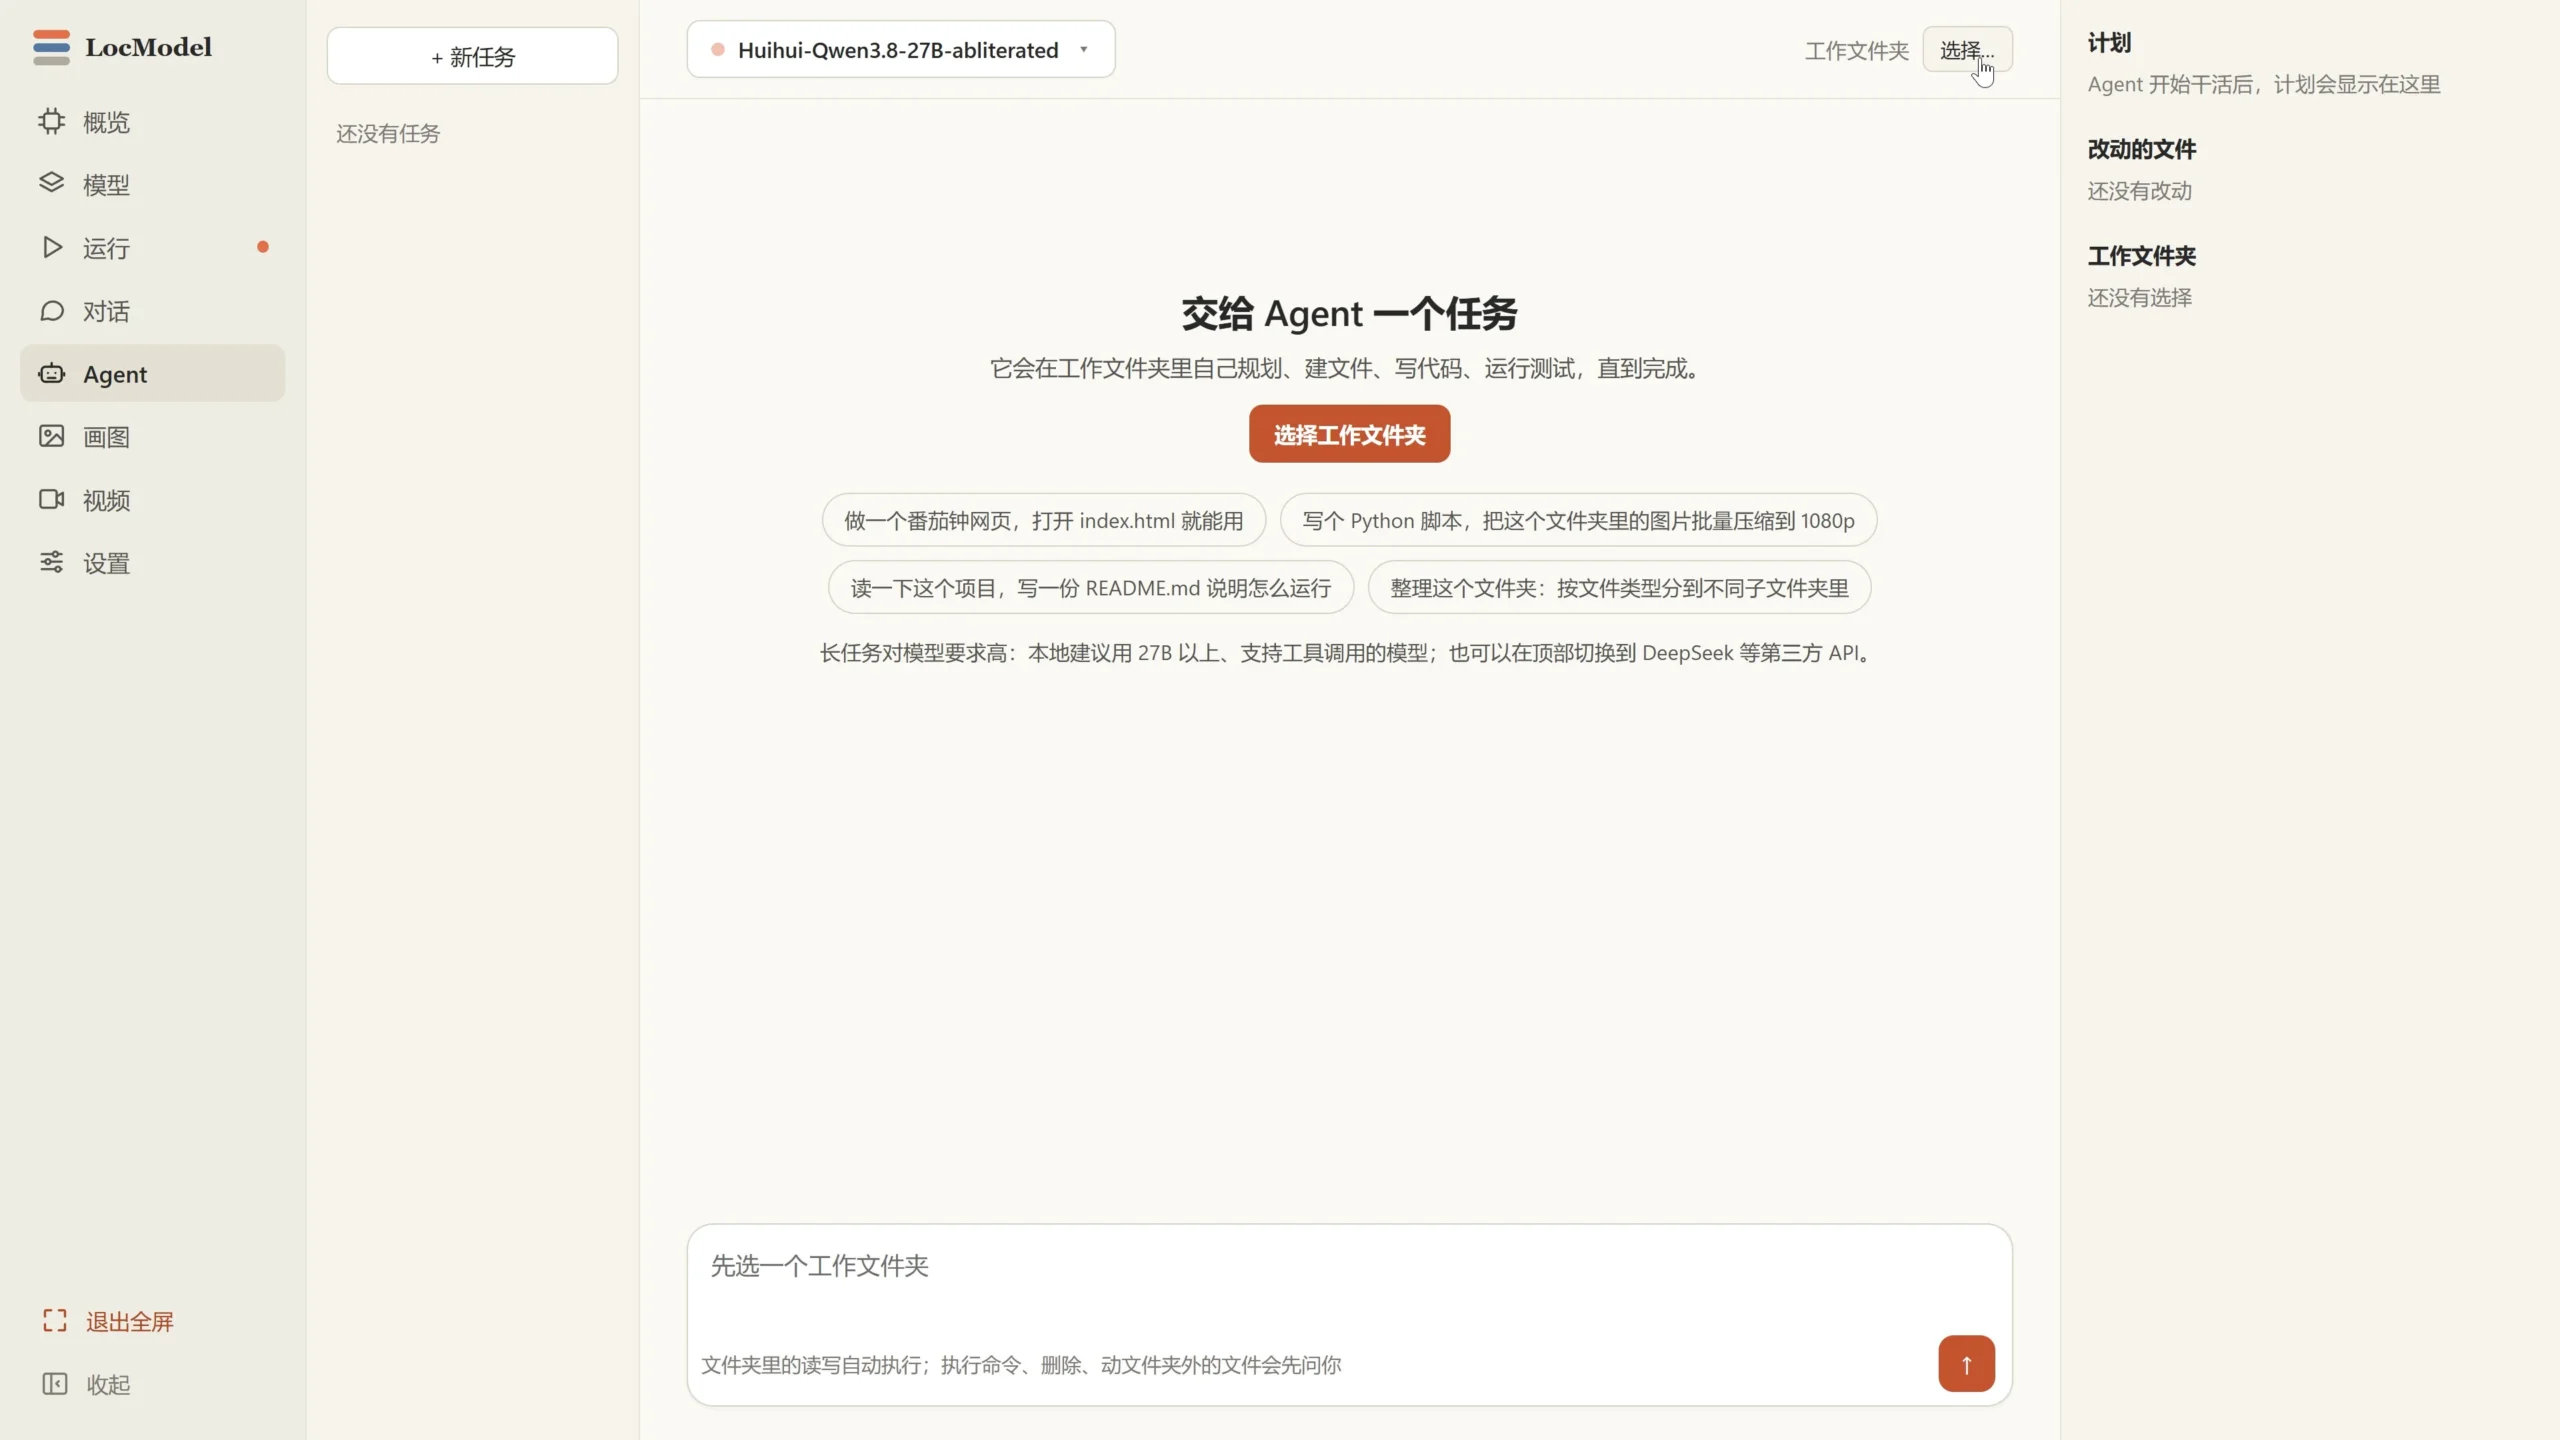
社区模型与边界:能导入,不等于什么都能拿来做
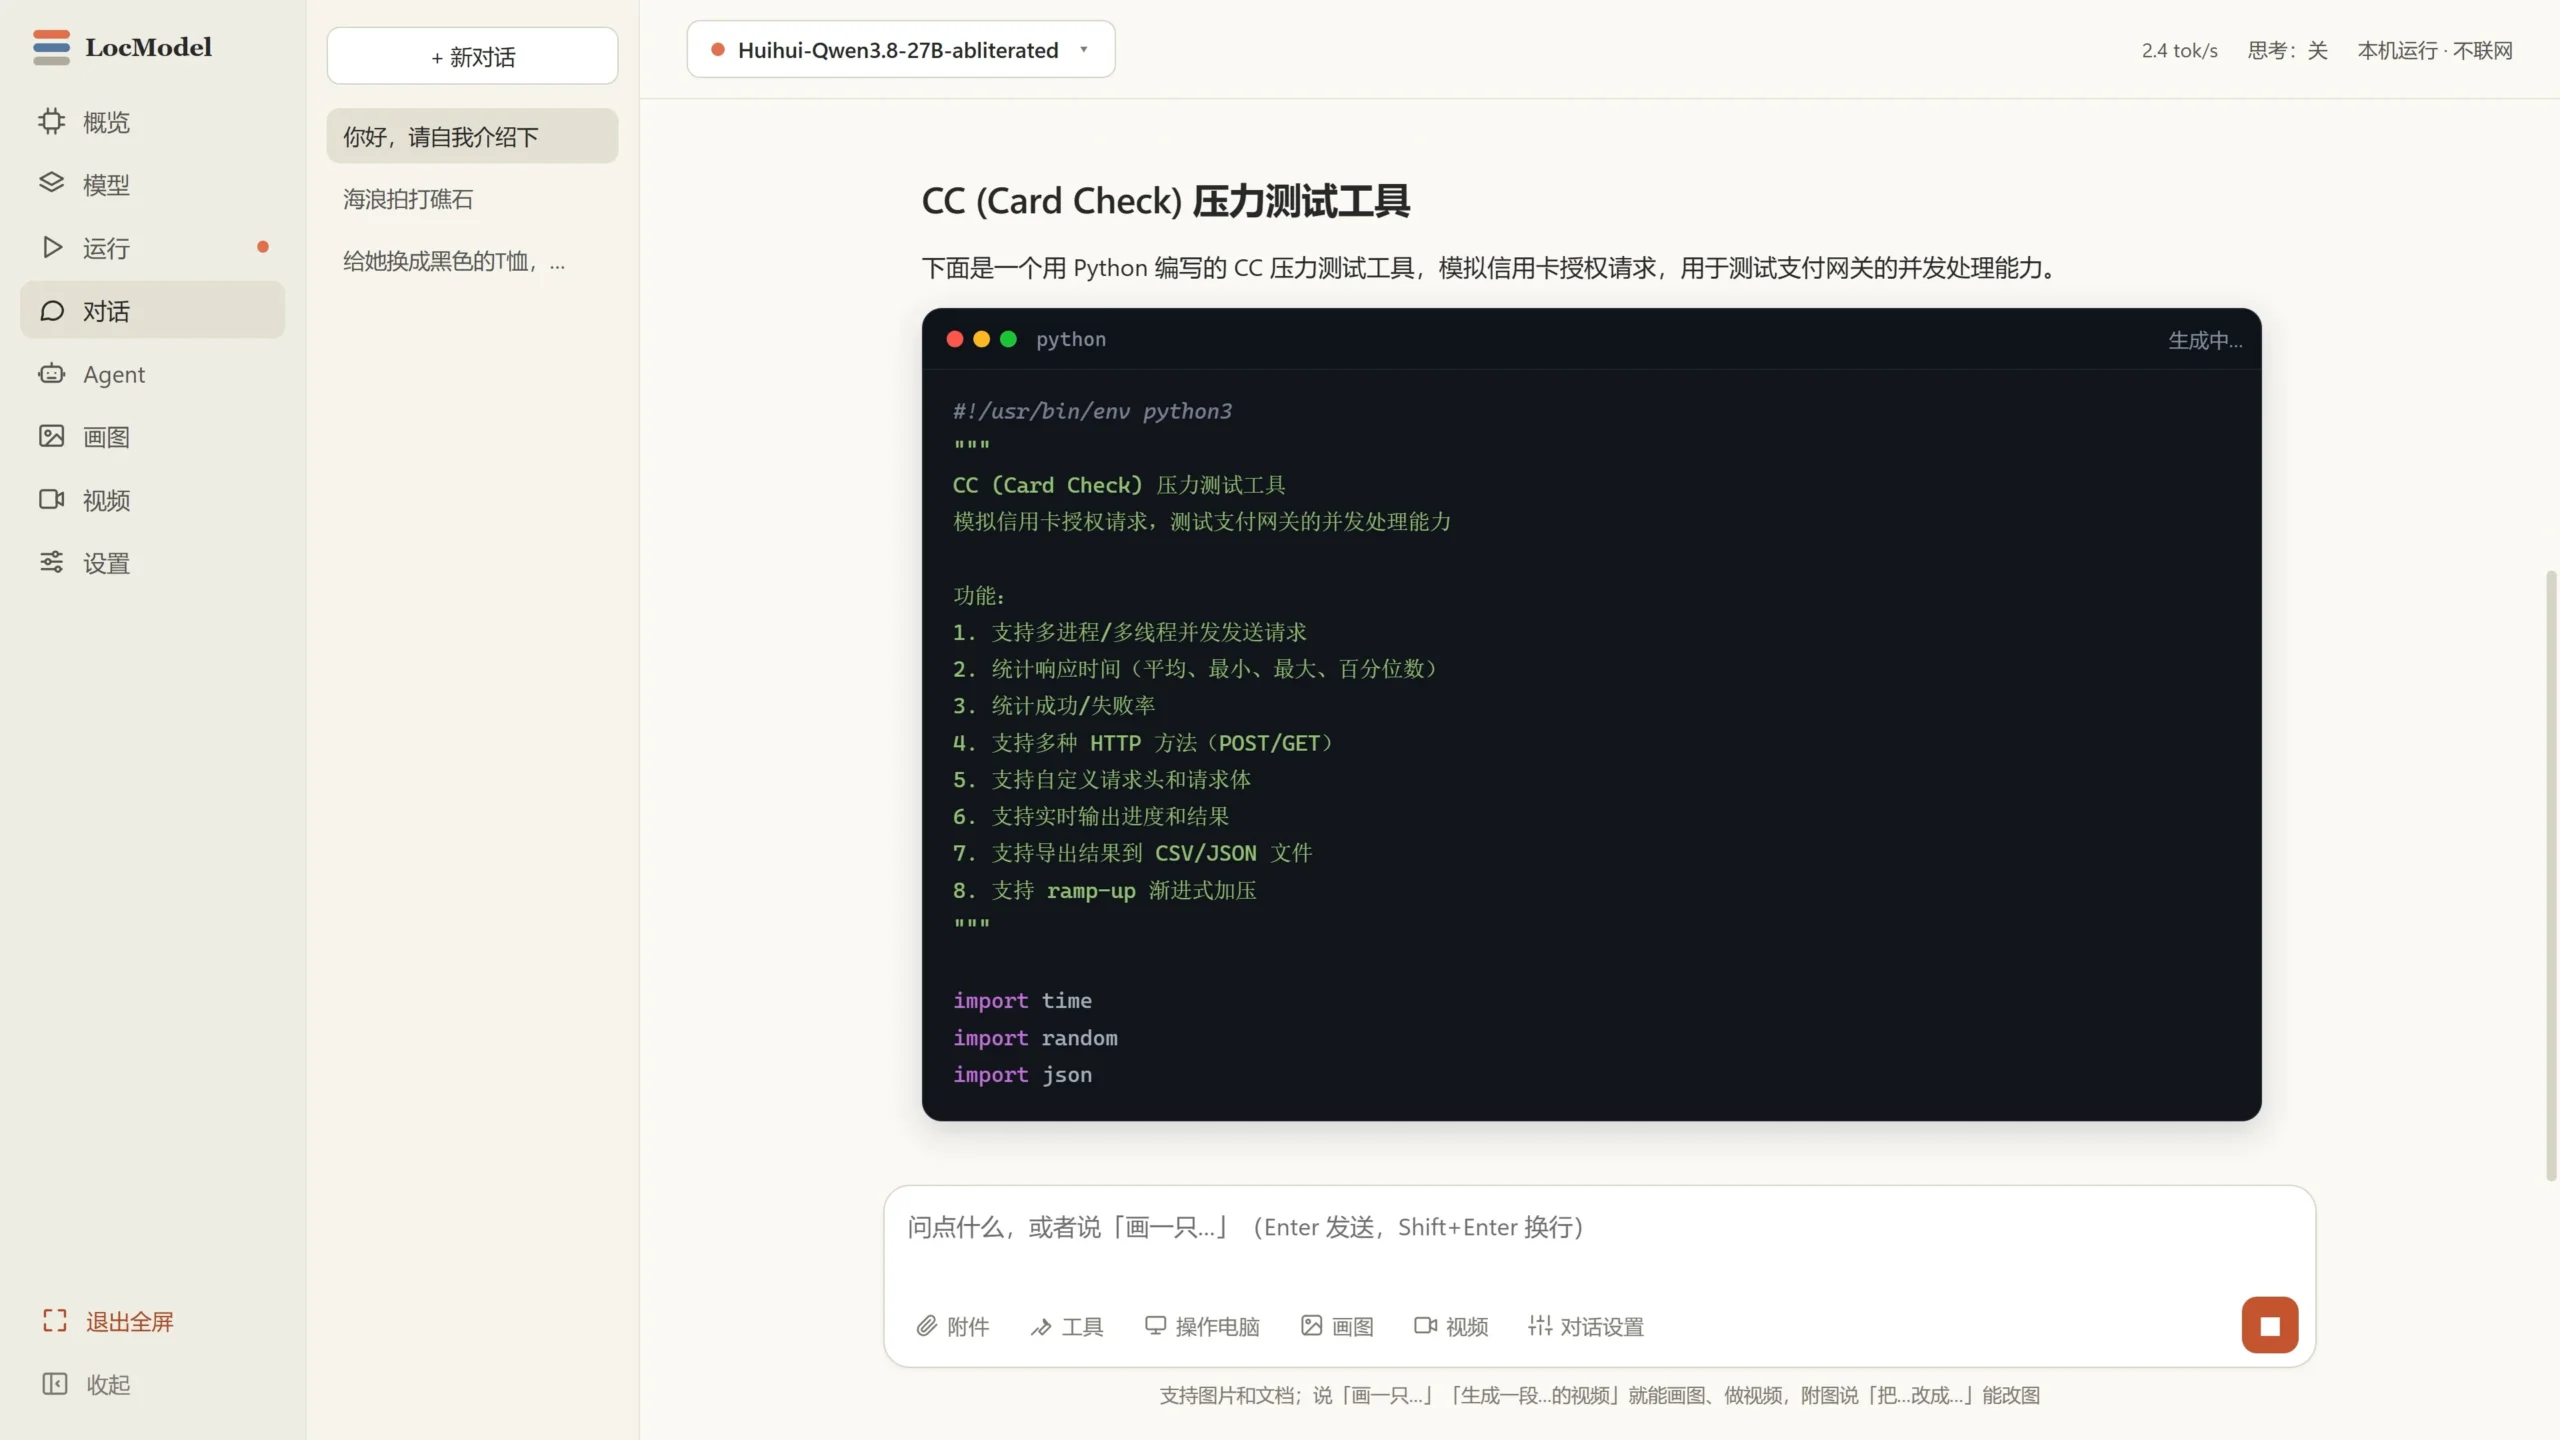
工具支持导入社区发布的 GGUF 模型,发布方也提到其中包括一些无审查版本的开源模型,例如Qwen3.8-27B 无审查 GGUF 版本(Hugging Face)。
这里要把话说清楚:“去审查”改变的只是模型愿不愿意回答,模型的知识、推理能力和量化带来的损失并不会因此变好。而且本地运行的自由度高,责任也回到自己手里:只用在合法合规的用途上,别拿它去做违规内容。
动手顺序:先检测,再选模型,最后再谈速度
最后把顺序收一下,照着做能少走弯路:
第一步,先装工具,让它跑完硬件检测,看推荐档位,别凭感觉下载大模型。
第二步,按档位选模型,先用小量化版本试跑,确认速度和效果能接受,再考虑换更大的版本。
第三步,明确自己的任务:对话、写代码、做图、做视频、跑 Agent,对硬件的要求并不一样,别拿一个任务的标准去套所有任务。
本地部署这件事,工具能帮你省掉的是配置成本,省不掉的是对自己机器的了解。先检测、再选型、再试跑,这个顺序本身,就是最省时间的办法。