本地跑大模型,先别急着换显卡:一键工具 + 3 款开源模型,8GB 显存也能起步
本地跑大模型,最劝退人的往往不是模型本身,而是前面那堆准备工作:装环境、配参数、再根据自己的显卡一台台去对型号。显卡只有 8GB 的时候,这个问题更明显——不是完全不能跑,而是不知道该选哪个版本、选多大的量化,试错成本很高。
今天这篇就换个顺序讲:先说一个能帮你省掉大部分配置工作的思路,再按显存从低到高,对照 3 款开源模型的特点,看看它们分别适合什么样的机器。文中的硬件数字和能力描述,都是发布方口径,没有逐条实测验证,落地前还是以你自己的机器实测为准。
先解决配置问题:一键工具是干什么的
这里用到的工具叫 LocModel,按发布方的介绍,它是一款免费的开源本地部署工具,核心就两件事:一是自动识别电脑硬件,二是根据显存、内存等条件推荐并适配合适的开源模型,顺带把推理引擎也装好。在线下载模型或者导入已有的 GGUF 文件,点一下就能在本地跑起来,不用自己记一堆启动参数。
这个思路对新手最友好的一点,是它把“选模型”从凭感觉变成了看推荐:工具会先检测你的显卡、内存和硬盘,再告诉你这台机器大概能流畅跑多大参数的模型、该用哪个量化版本。像下面这张界面里,工具就直接给出了“流畅运行 32B 以内模型”的判断,并把显卡、内存、硬盘的分工画了出来。
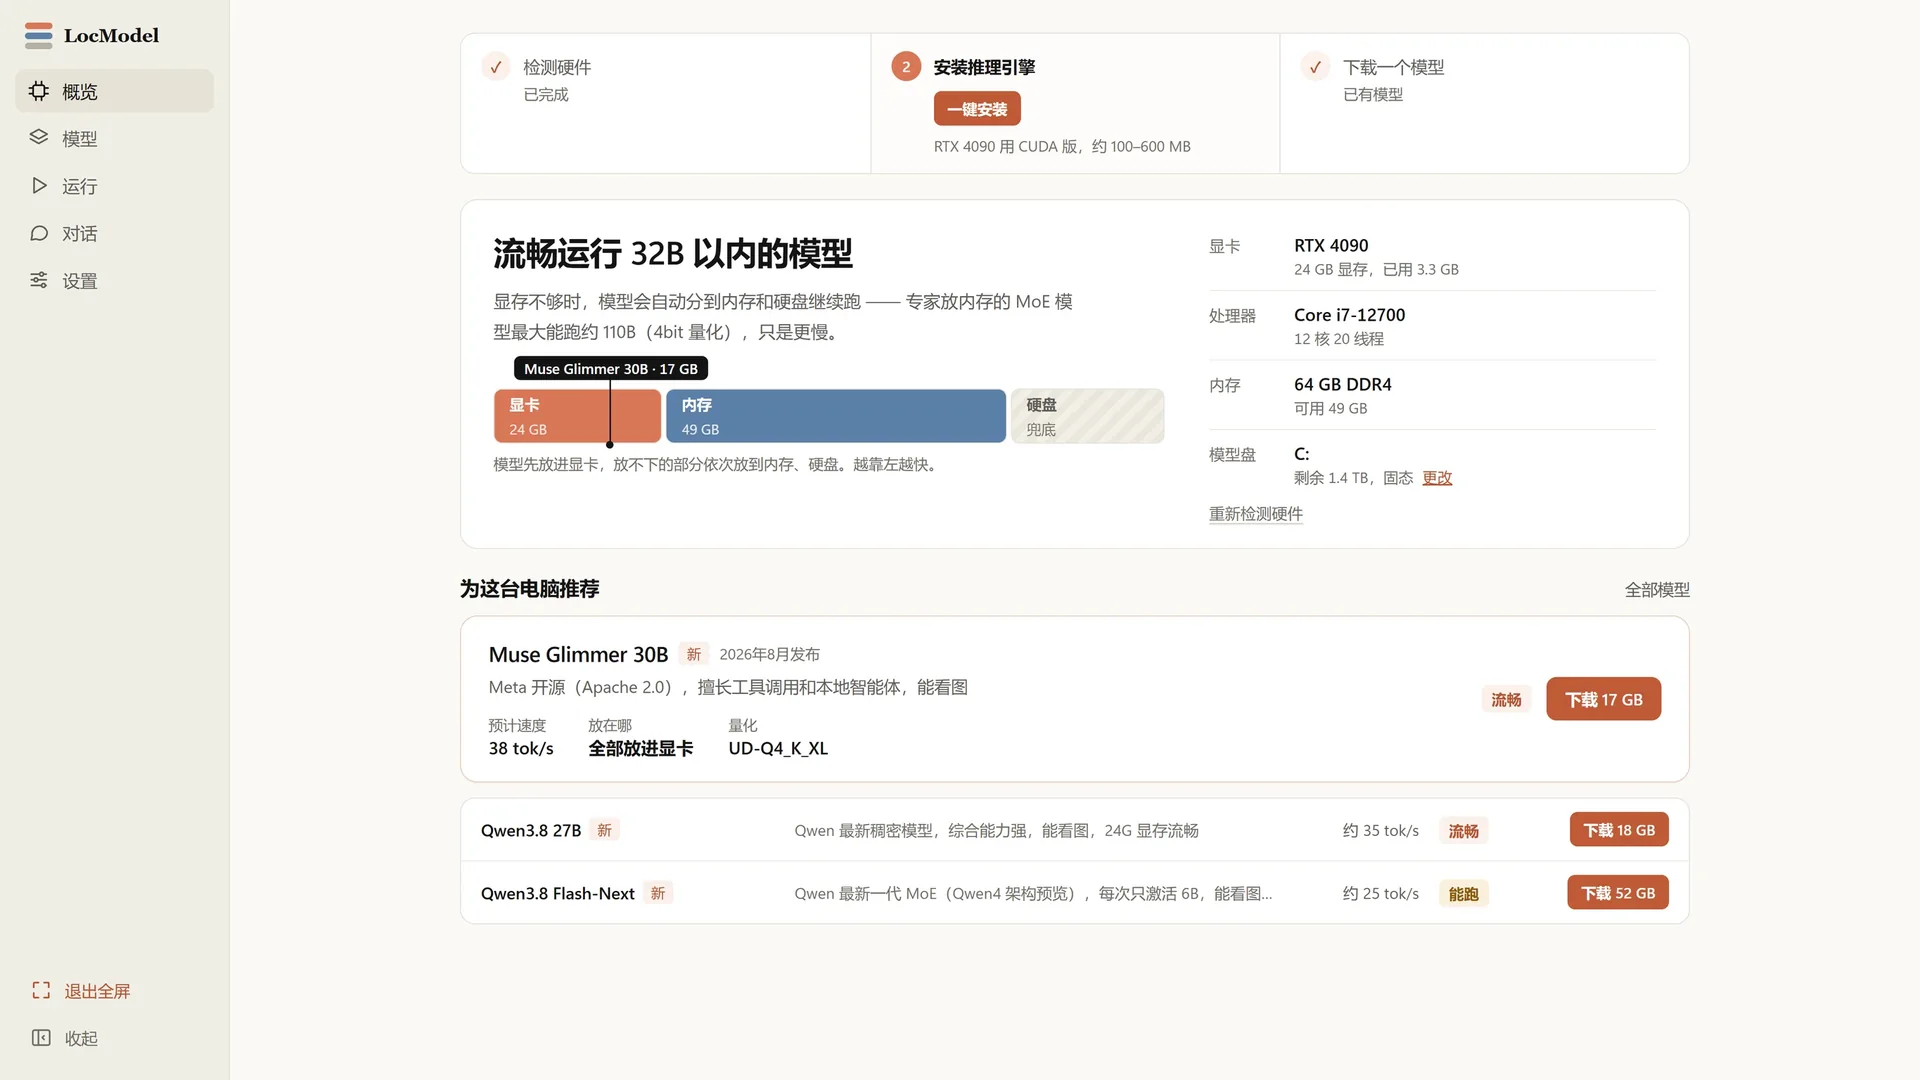
下载安装可以去LocModel 官网。装好之后,真正的关键一步不是急着下载最大的模型,而是先让工具跑完硬件检测,再看它推荐的那个档位。
分层加载是什么意思,为什么老电脑也有机会
这 3 款模型能谈“8GB 显存起步”,背后都有一个共同前提:权重不一定非要全部塞进显存。工具可以做自动分层规划——放得下的部分进显存,放不下的部分放到内存,实在不够再按需从硬盘读。像下面这张运行界面,模型就是 18.4GB 放显卡、2.5GB 放内存这样分开的。
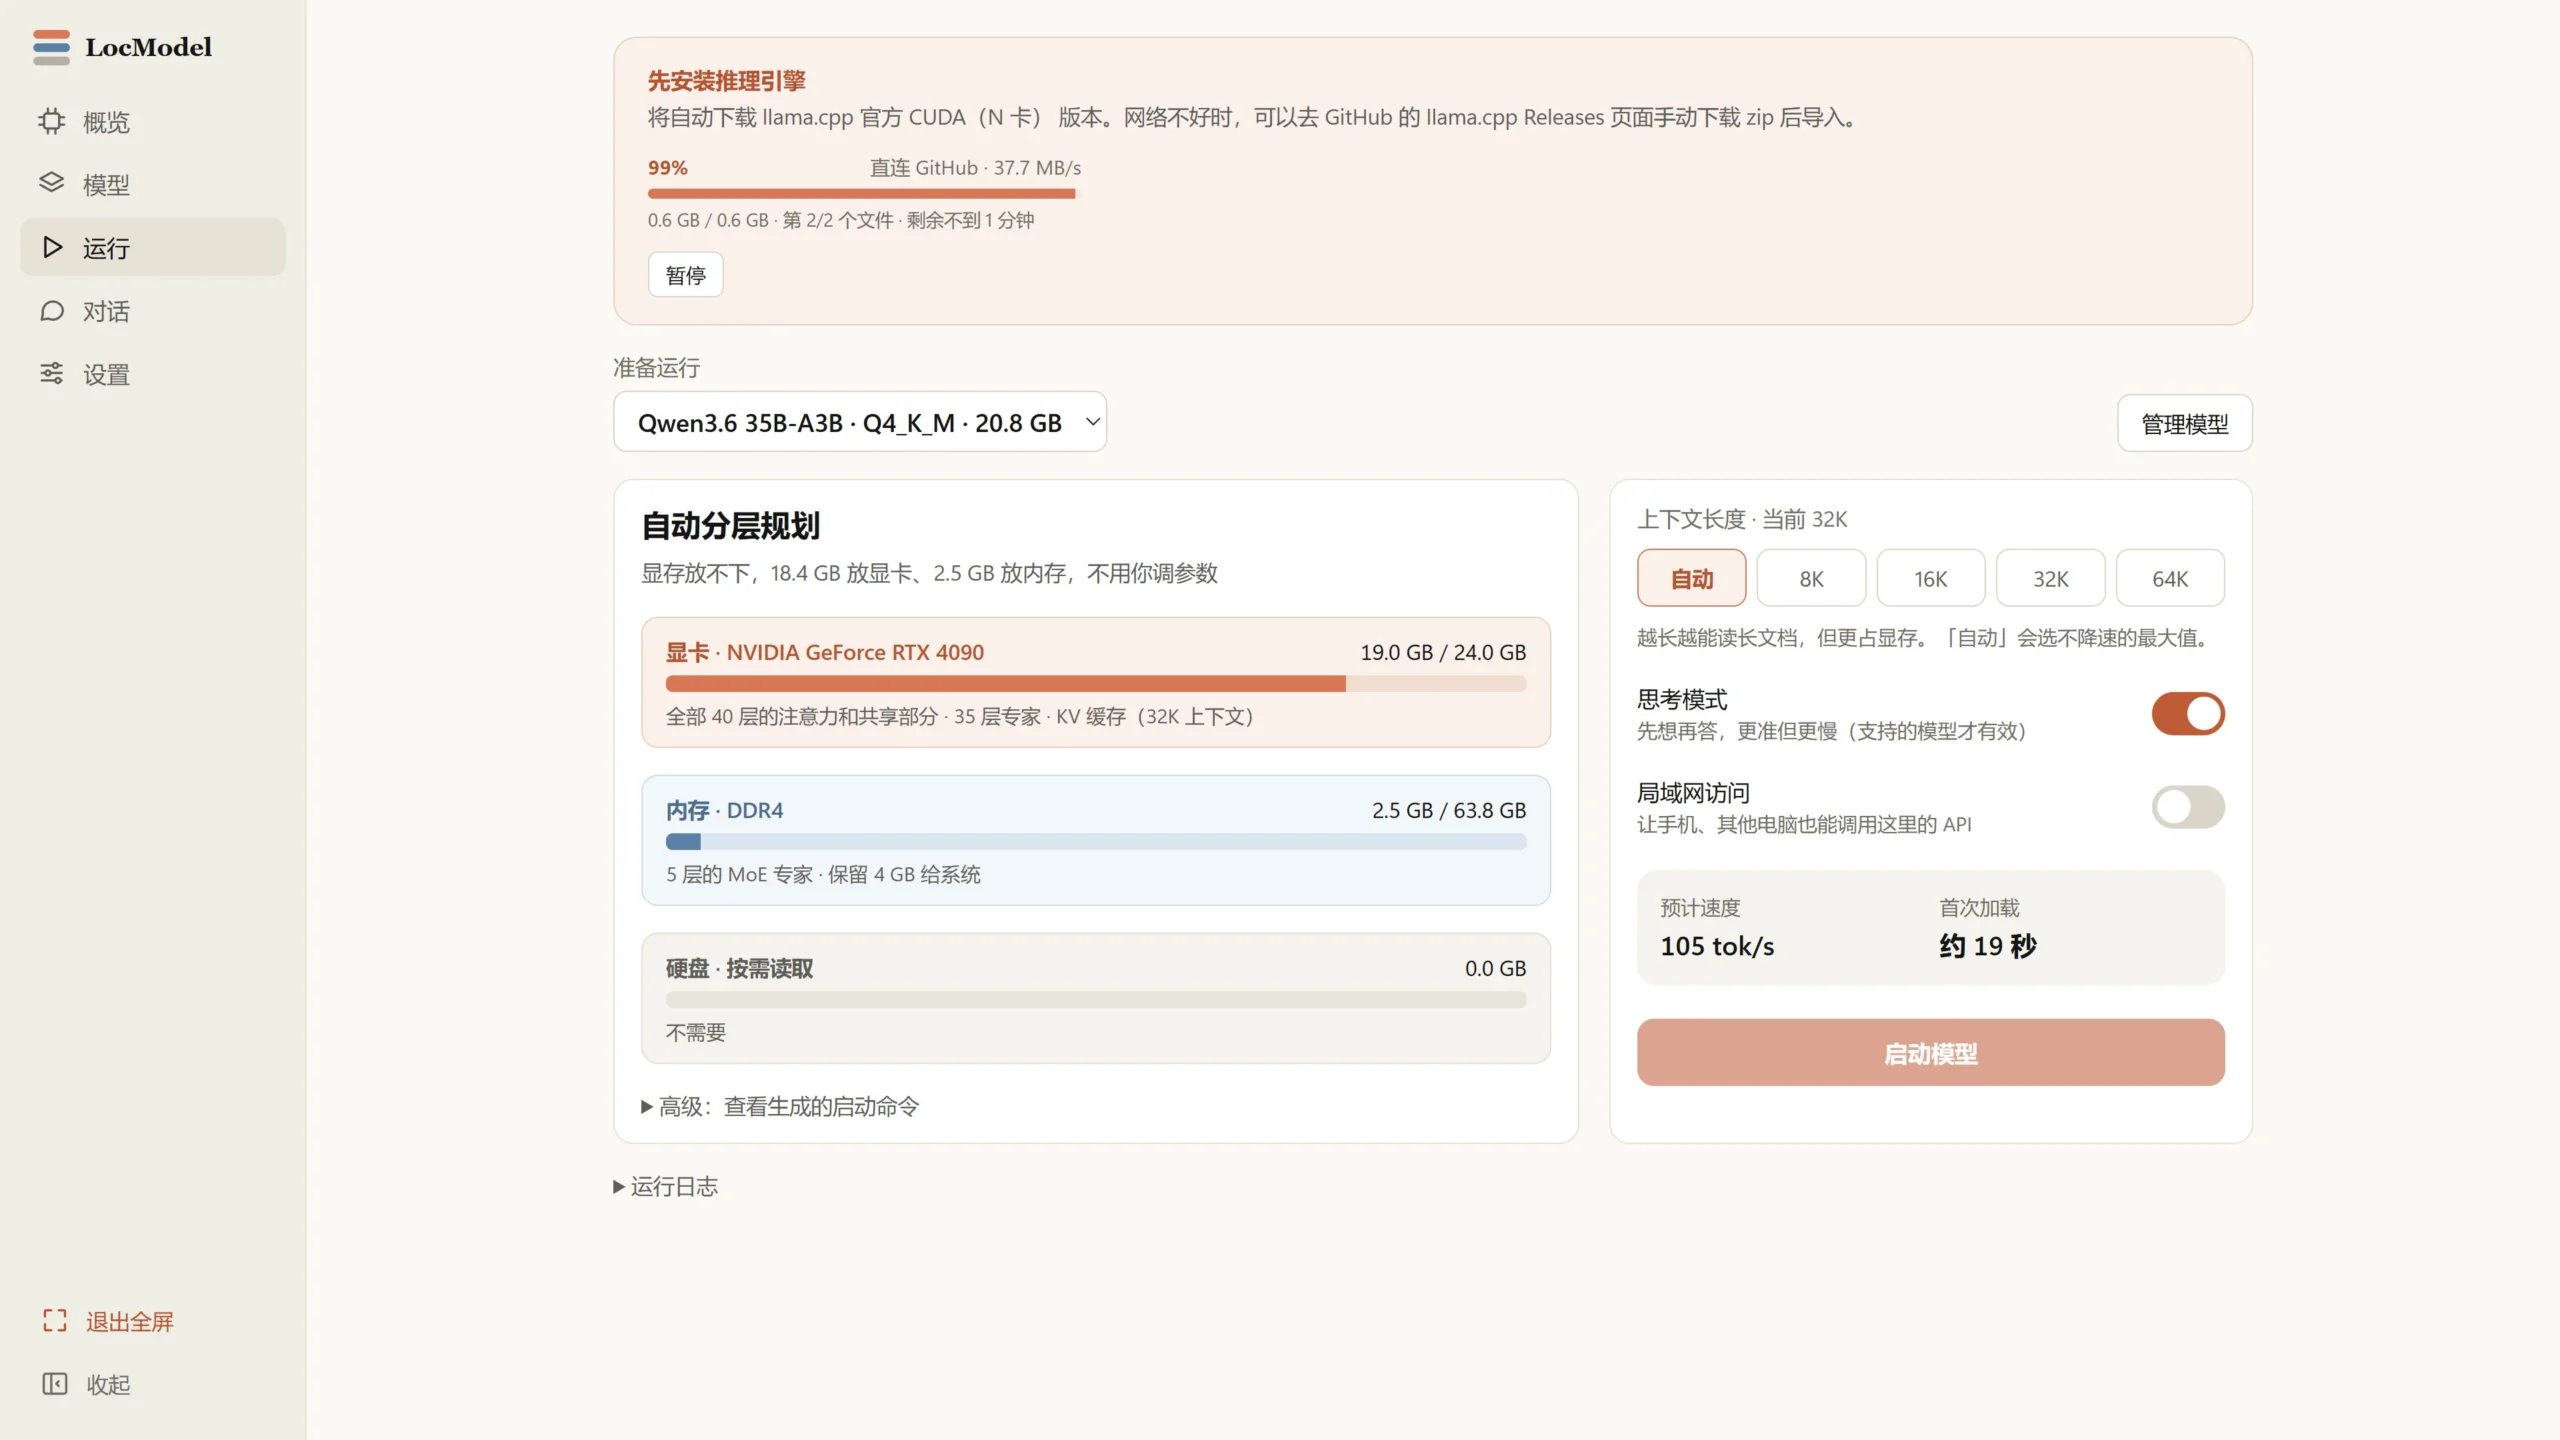
但这里要先打个预防针:分层加载降低的是“能不能跑”的门槛,不是把老电脑变成高配工作站。一旦大量权重落在内存甚至硬盘上,生成速度一定会掉下来,更适合慢慢出结果的任务,不适合指望它实时对答。所以选模型的时候,先看显存,再看你能不能接受这个速度。
第一款:Qwen3.8-27B 的去审查版本,8GB 显存起步档
第一款是 Qwen3.8-27B 的去审查版本。按发布方的说法,它是通义千问系列面向本地部署的高性能版本,中文理解、逻辑推理和 Agent 支持都比较强,主打的是减少不必要的拒答,适合本地对话和自动化任务这类场景。
硬件要求是这款最值得说的一点:发布方称最低 8GB 显存就能跑起来,靠的就是上面说的低量化版本。也就是说,如果你的显卡正好卡在 8GB 这个档位,这款是三款里最先值得试的,而不是一上来就挑战更大的参数量。
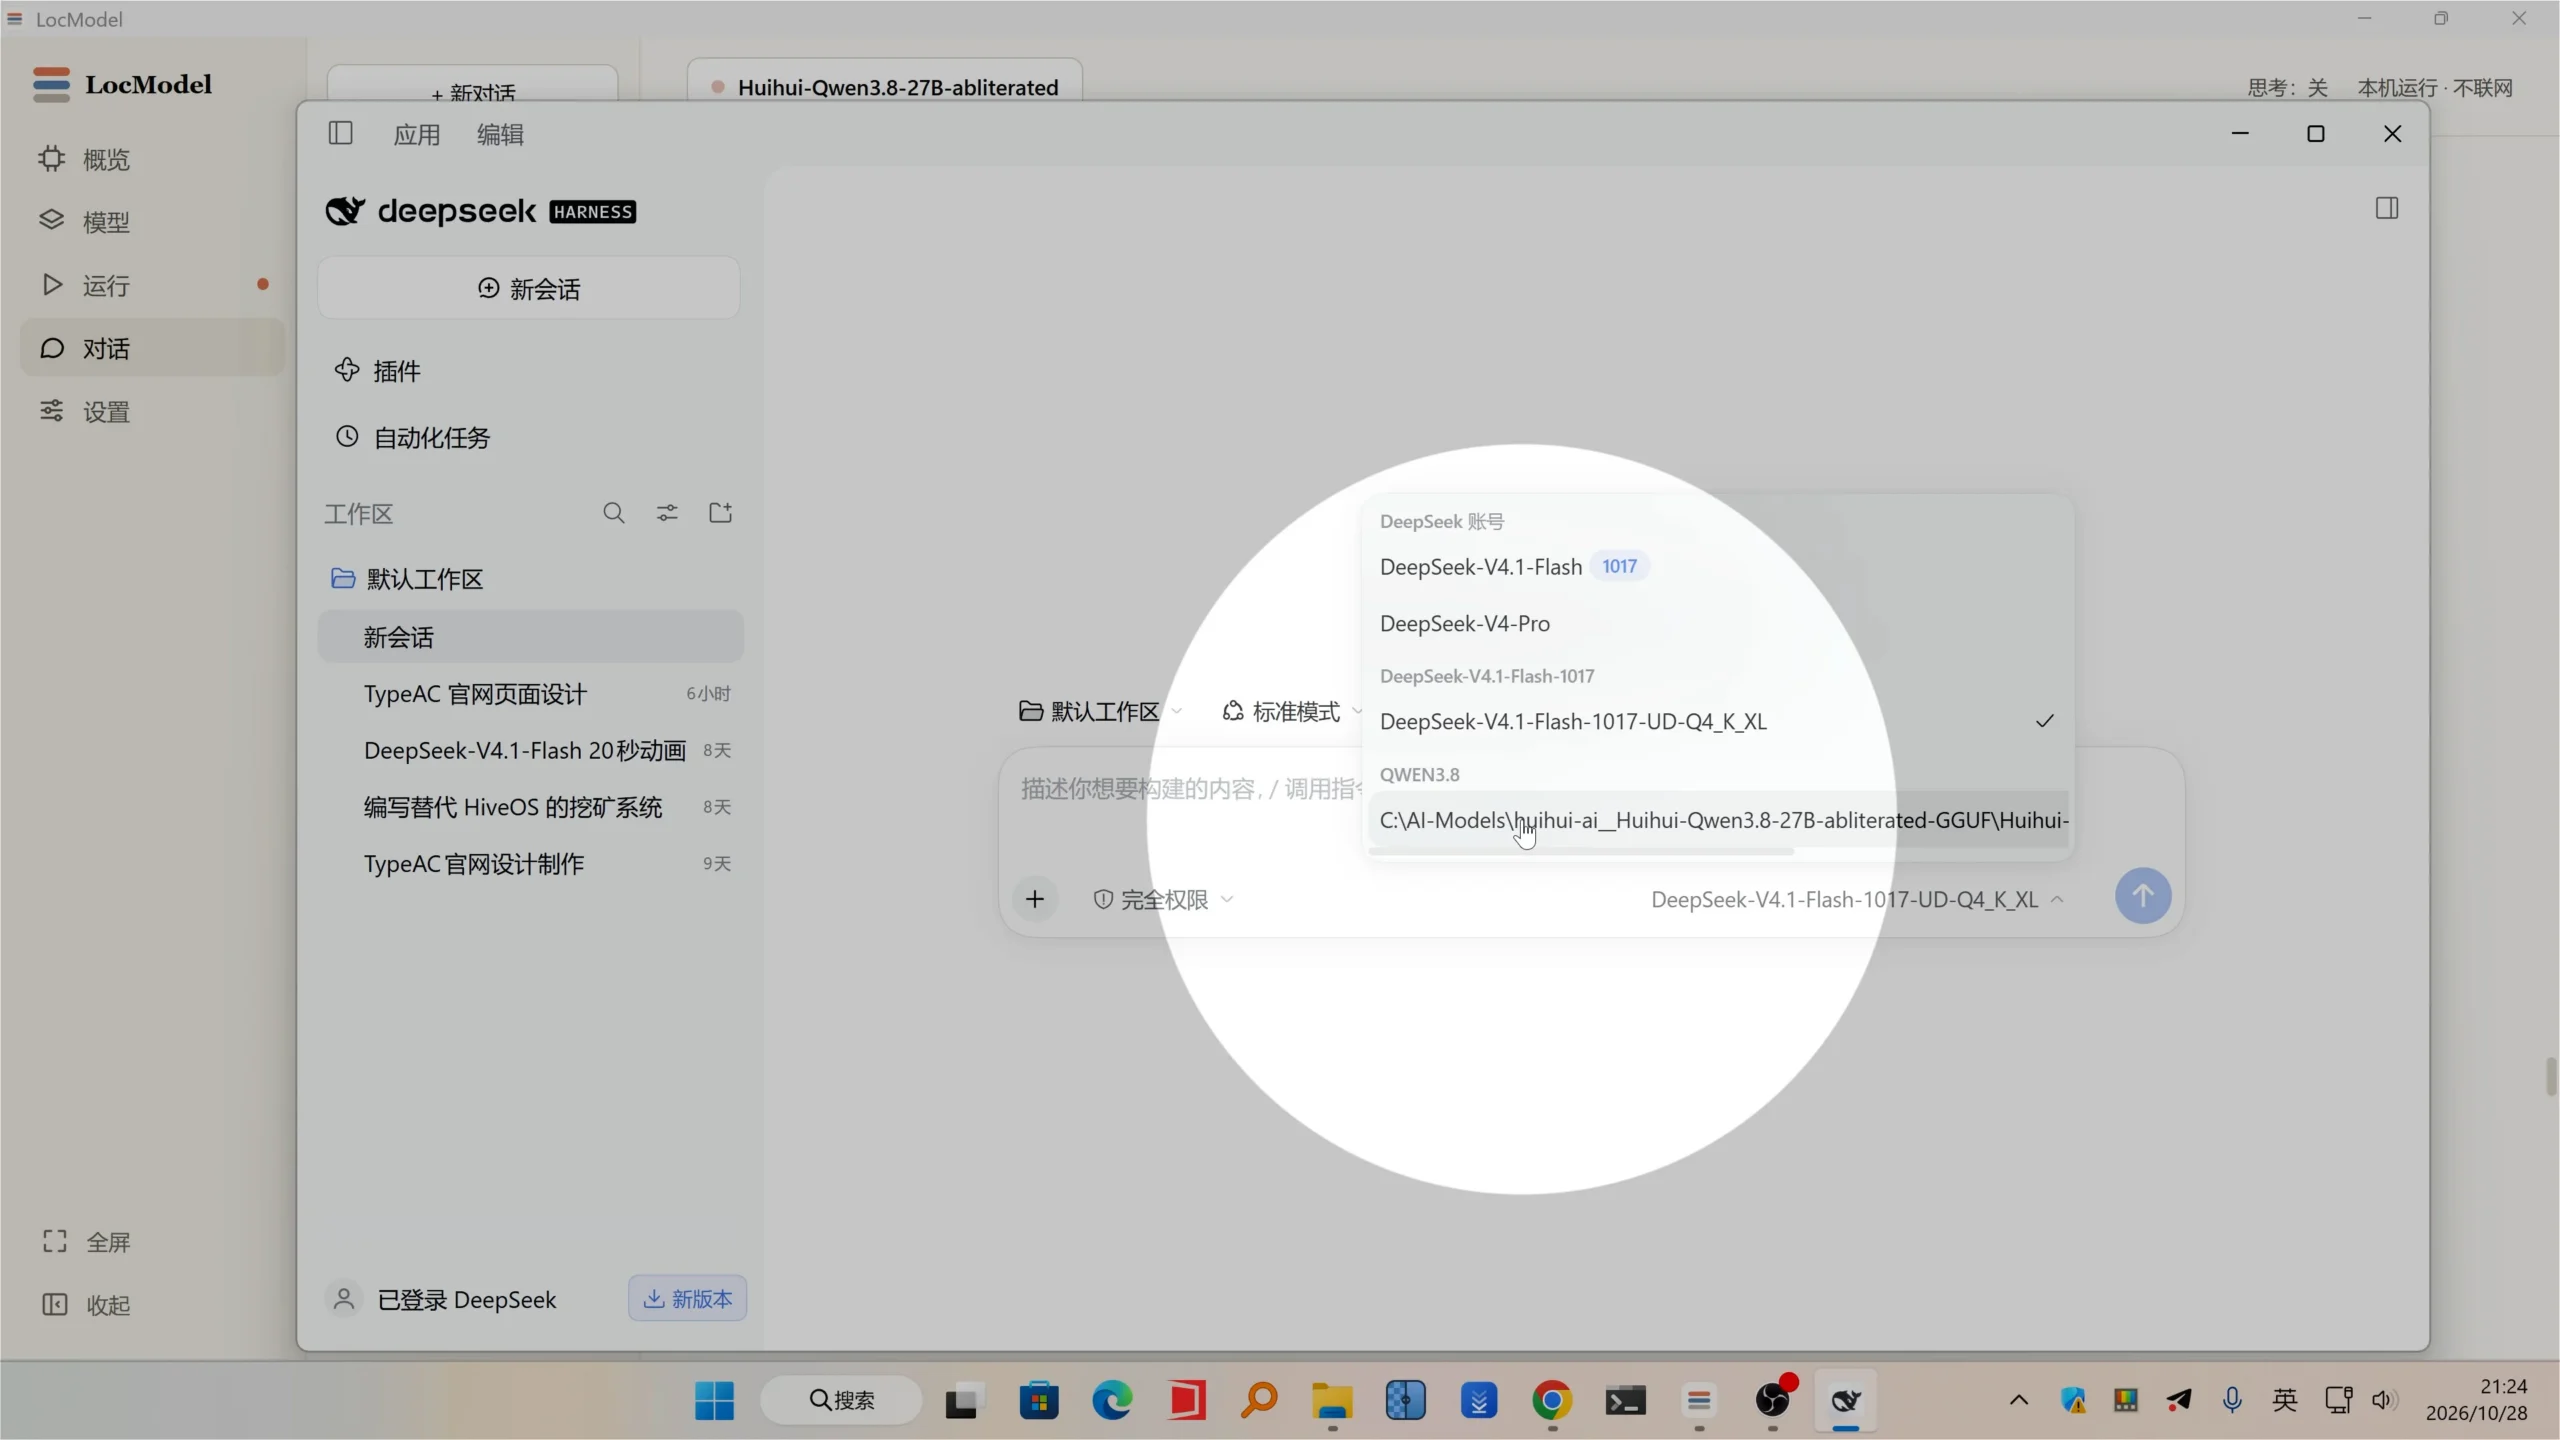
下载有两个入口:在 LocModel 里直接搜索模型名就能下载;如果手头已经有 GGUF 文件,也可以走导入路线。具体模型页见Huihui-Qwen3.8-27B-abliterated 模型页(Hugging Face),GGUF 版本见Qwen3.8-27B GGUF 版本(Hugging Face)。
另外多说一句:“去审查”不等于“更聪明”。去掉过滤层,改变的只是模型愿不愿意回答,模型的知识、推理上限和量化带来的损失并没有因此变好。本地跑这类版本,更要自己守住边界:只用在合法合规的用途上。
第二款:Qwen3.6-35B-A3B,MoE 架构,老显卡的另一条路
第二款是 Qwen3.6-35B-A3B 的去审查版本,名字里带 Aggressive,意思是去审查策略做得更积极。它的架构和第一款不一样:用的是 MoE 结构,总参数 35B,但每次只激活约 3B 参数,支持视觉多模态、131k 长上下文和本地 Agent 运行,中文能力按发布方口径在同量级里比较靠前。
MoE 的好处在这里很直接:总参数看着大,实际每次计算量没那么大。配合 llama.cpp 的 CUDA 或 CPU 部署,再加上 IQ2_M 这类高压缩量化,发布方称 6GB、8GB 显存的老显卡也有机会跑起来。模型页见Qwen3.6-35B-A3B 去审查版模型页(Hugging Face)。
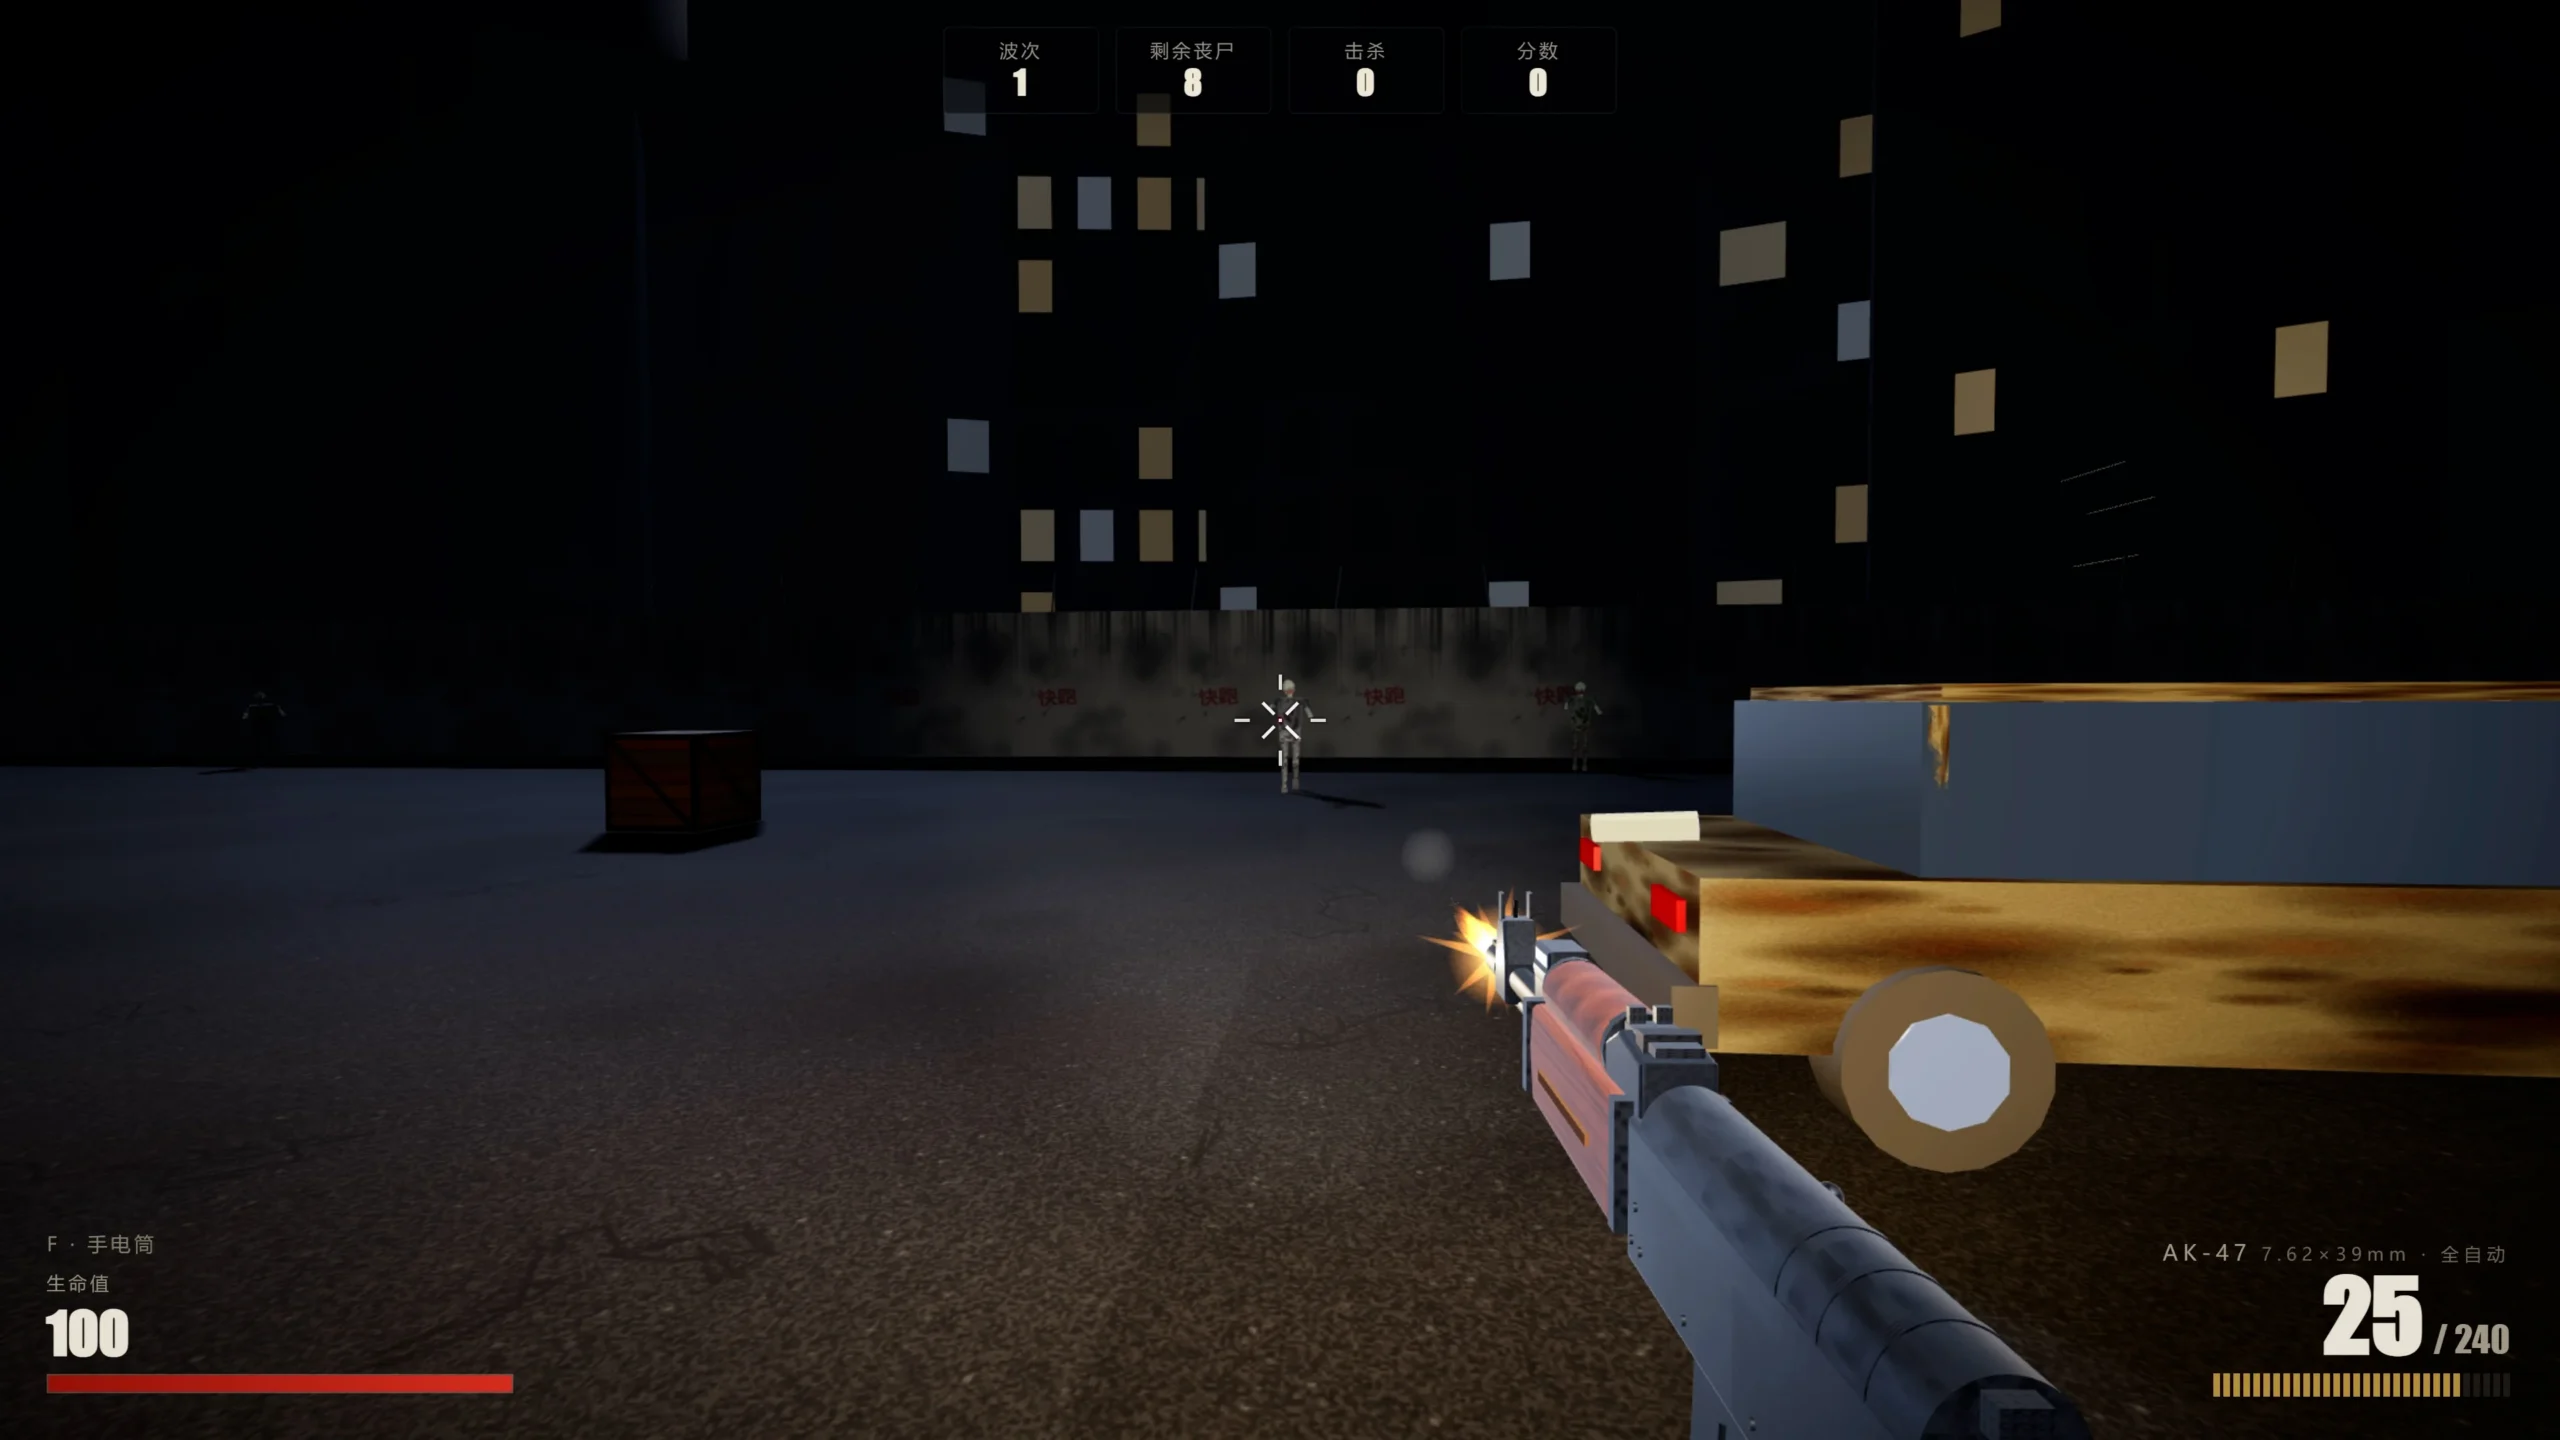
这款还有两个适合动手玩的点:一是能拿来写游戏代码这类需要多轮改的任务,按发布方口径,优化几轮提示词之后一次成型的概率不错,下面就是它生成的一个游戏画面示例;二是支持把第三方 Agent 通过 API 接进来,本地模型不只是用来聊天,还能当作自动化任务的执行层。
第三款:Gemma 4 31B,显存预算要放得更宽
第三款是基于 Google DeepMind 的 Gemma 4 开源底模的去审查版本,属于 JANG 系列,参数量 31B。按发布方的说法,它在逻辑、日常对话和复杂实用场景里表现比较稳定,主打的是不受过多限制的对话体验。
但它的硬件门槛明显高一档:模型本身约 15GB 大小,配合量化,发布方口径是 16GB 到 24GB 显存的设备上才能流畅运行。所以这款不适合 8GB 显卡硬上,更适合显存已经到 16GB 以上、想换个底模试试的人。模型页见Gemma 4 JANG 系列模型页(Hugging Face),在 LocModel 里搜索模型名也能直接下载。
动手顺序建议:按显存选,别按参数量选
最后把顺序收一下,照着做能少走不少弯路:
第一步,先装 LocModel,让它跑完硬件检测,看推荐档位,别凭感觉下载。第二步,按显存对号入座:8GB 左右先看第一款,6GB、8GB 的老卡可以试第二款的低量化版本,16GB 以上再考虑第三款。第三步,先用小量化版本试跑,确认速度和效果能接受,再决定要不要换更大的版本。
还有一点值得单独提醒:本地部署的自由度高,责任也跟着回到自己手里。模型愿不愿意回答,不代表什么内容都能拿去做。选模型的时候看参数、看量化、看速度就够了,真正决定体验上限的,还是提示词质量和你自己的使用方式。