DeepSeek-V4.1-Flash-1017 开源发布:冲到开源第一,但 500GB 门槛先劝退九成九的人
先说结论
DeepSeek 在 10 月 17 日放出了 V4.1-Flash 的新版本(版本号后缀 1017),权重已经开源,官网、App 和 API 同步上线。按官方公布的成绩,这个版本在 Code Arena: WebDev 榜单上拿下了开源模型第一。但对绝大多数想"下载下来自己跑"的人,我的建议是先冷静:这仍然是一个 500GB 级别的大家伙,本地部署的门槛并没有因为出了量化版而实质降低。普通人想尝鲜,直接用官方 API 是更现实的路线。
这次到底更新了什么
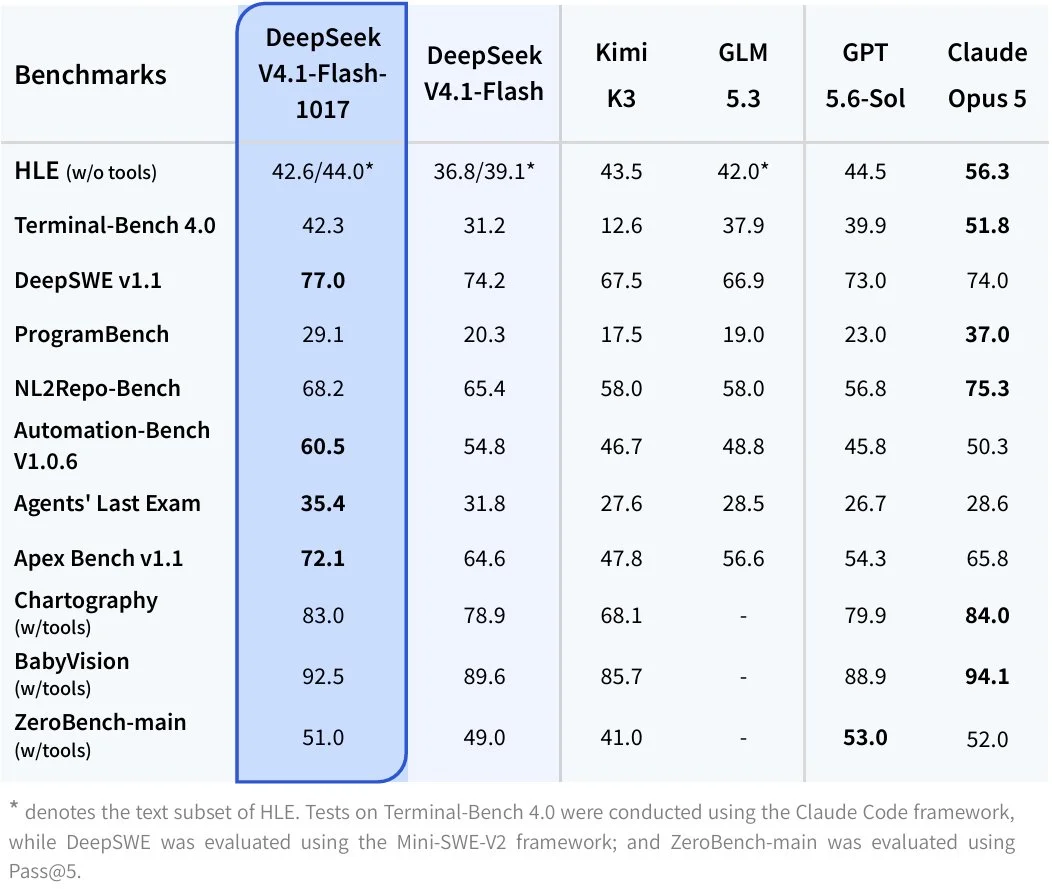
- 定位:V4.1-Flash-20261017(Max)主打更强的基准性能、更快的任务完成速度、更短的输出,官方称这是性能与成本上的一次帕累托改进。
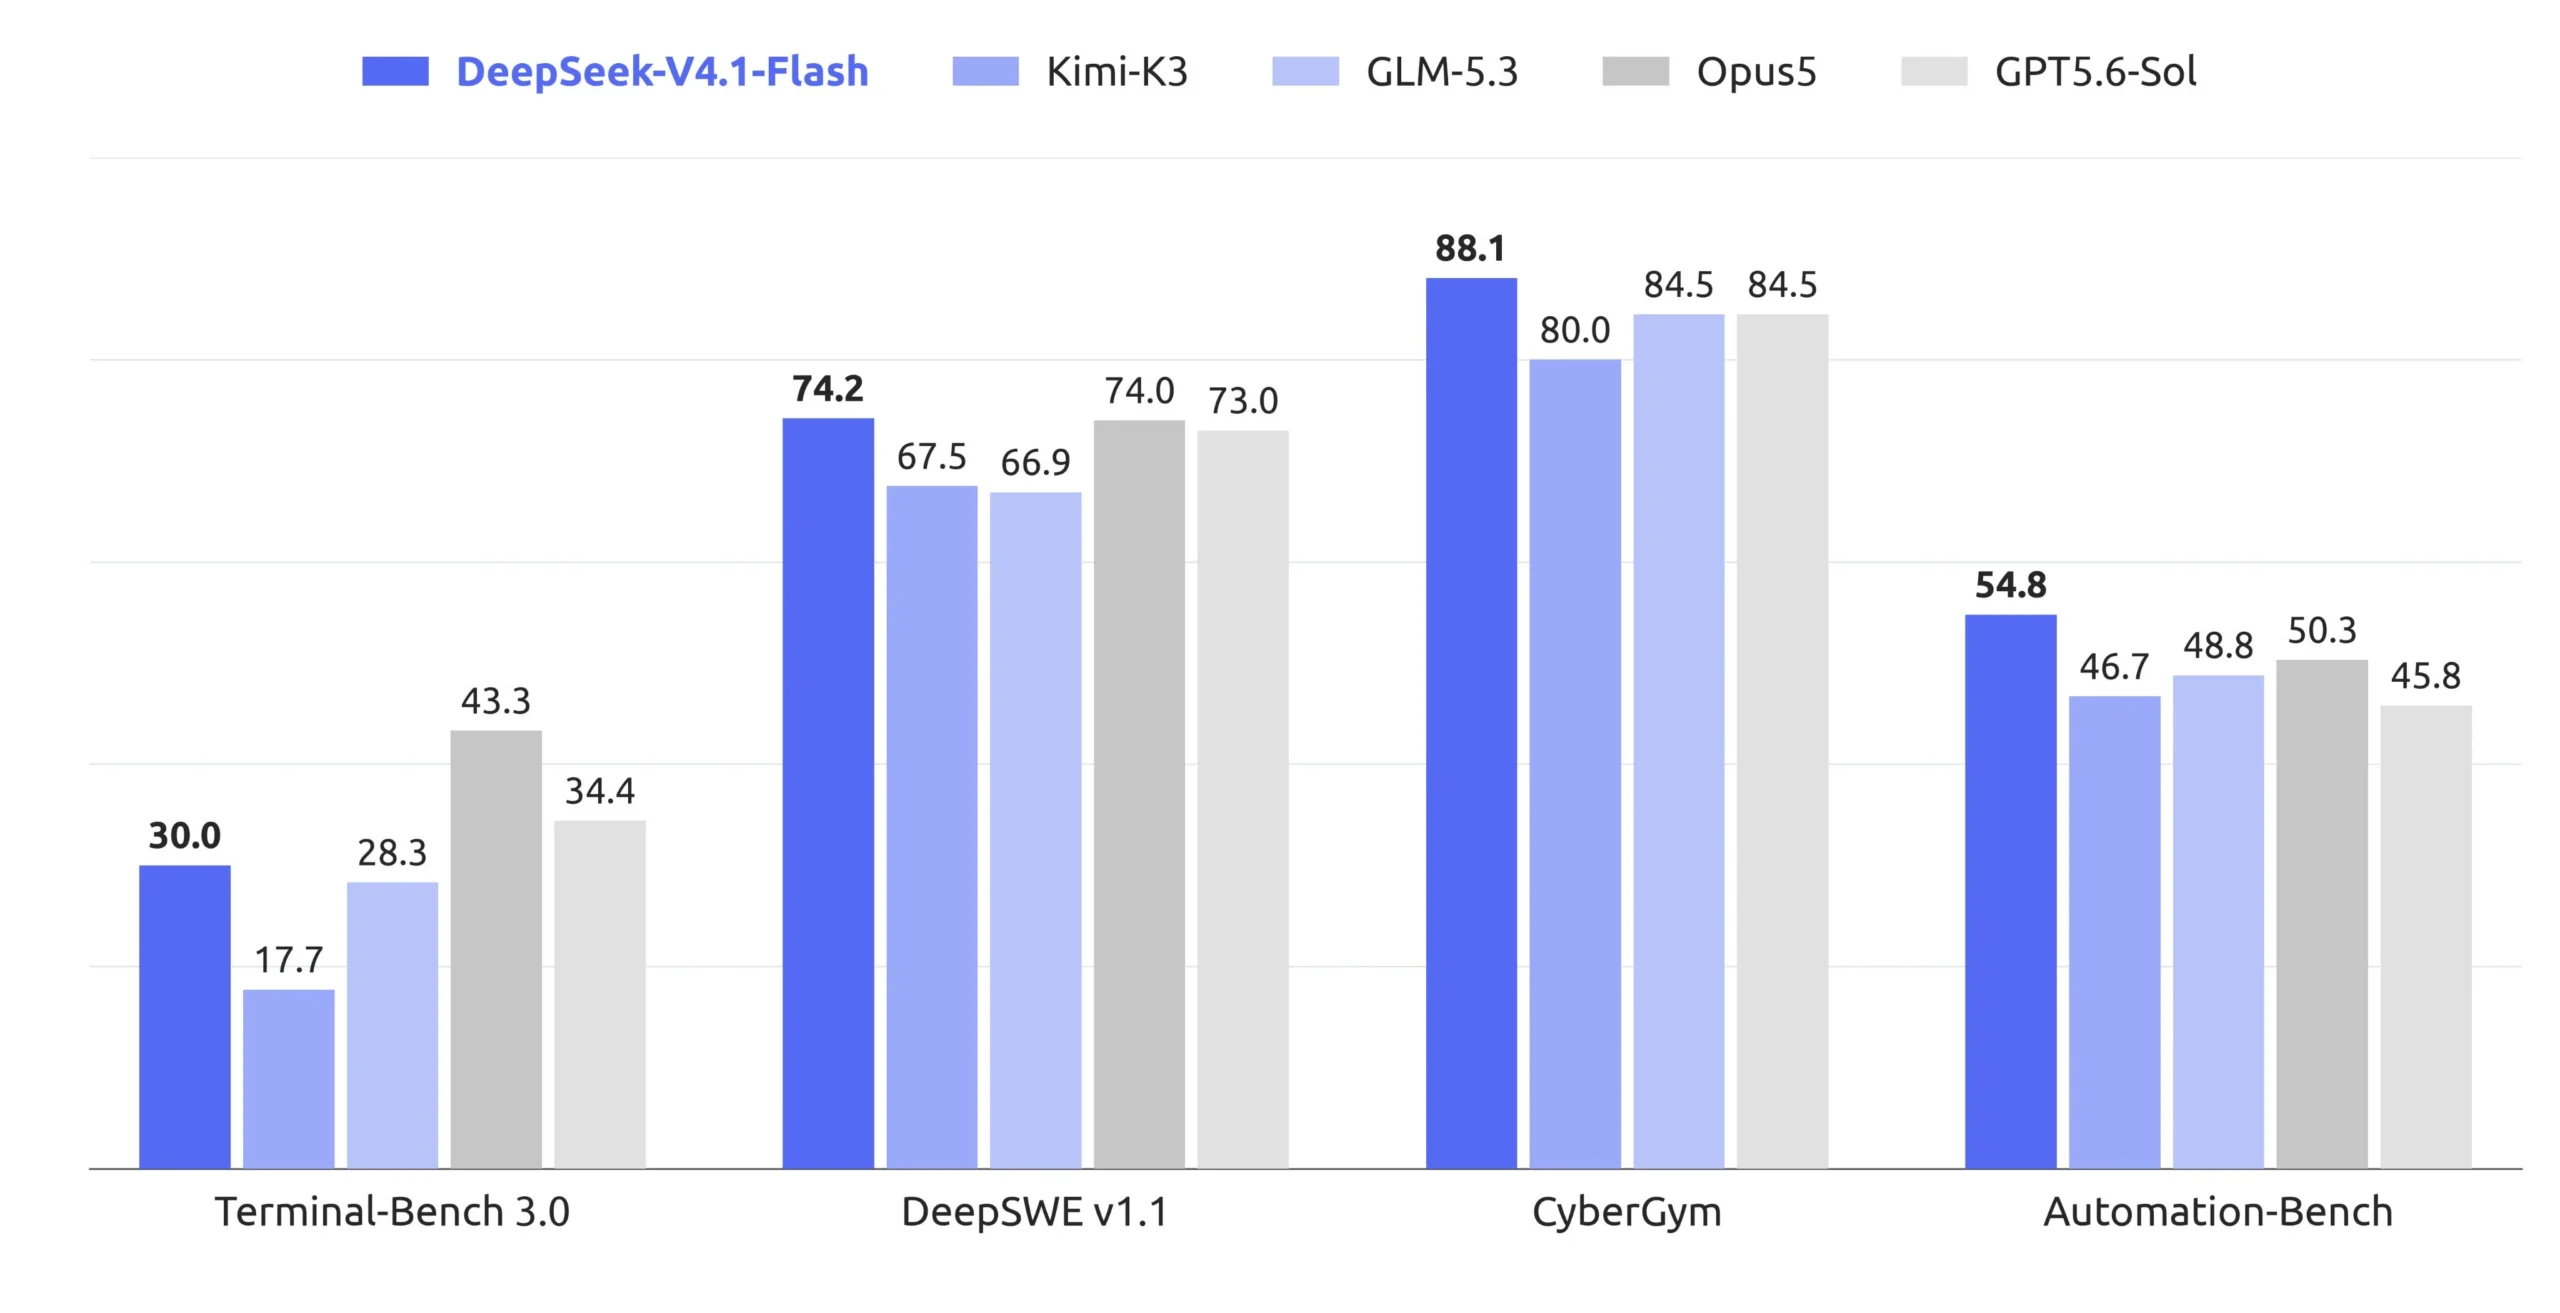
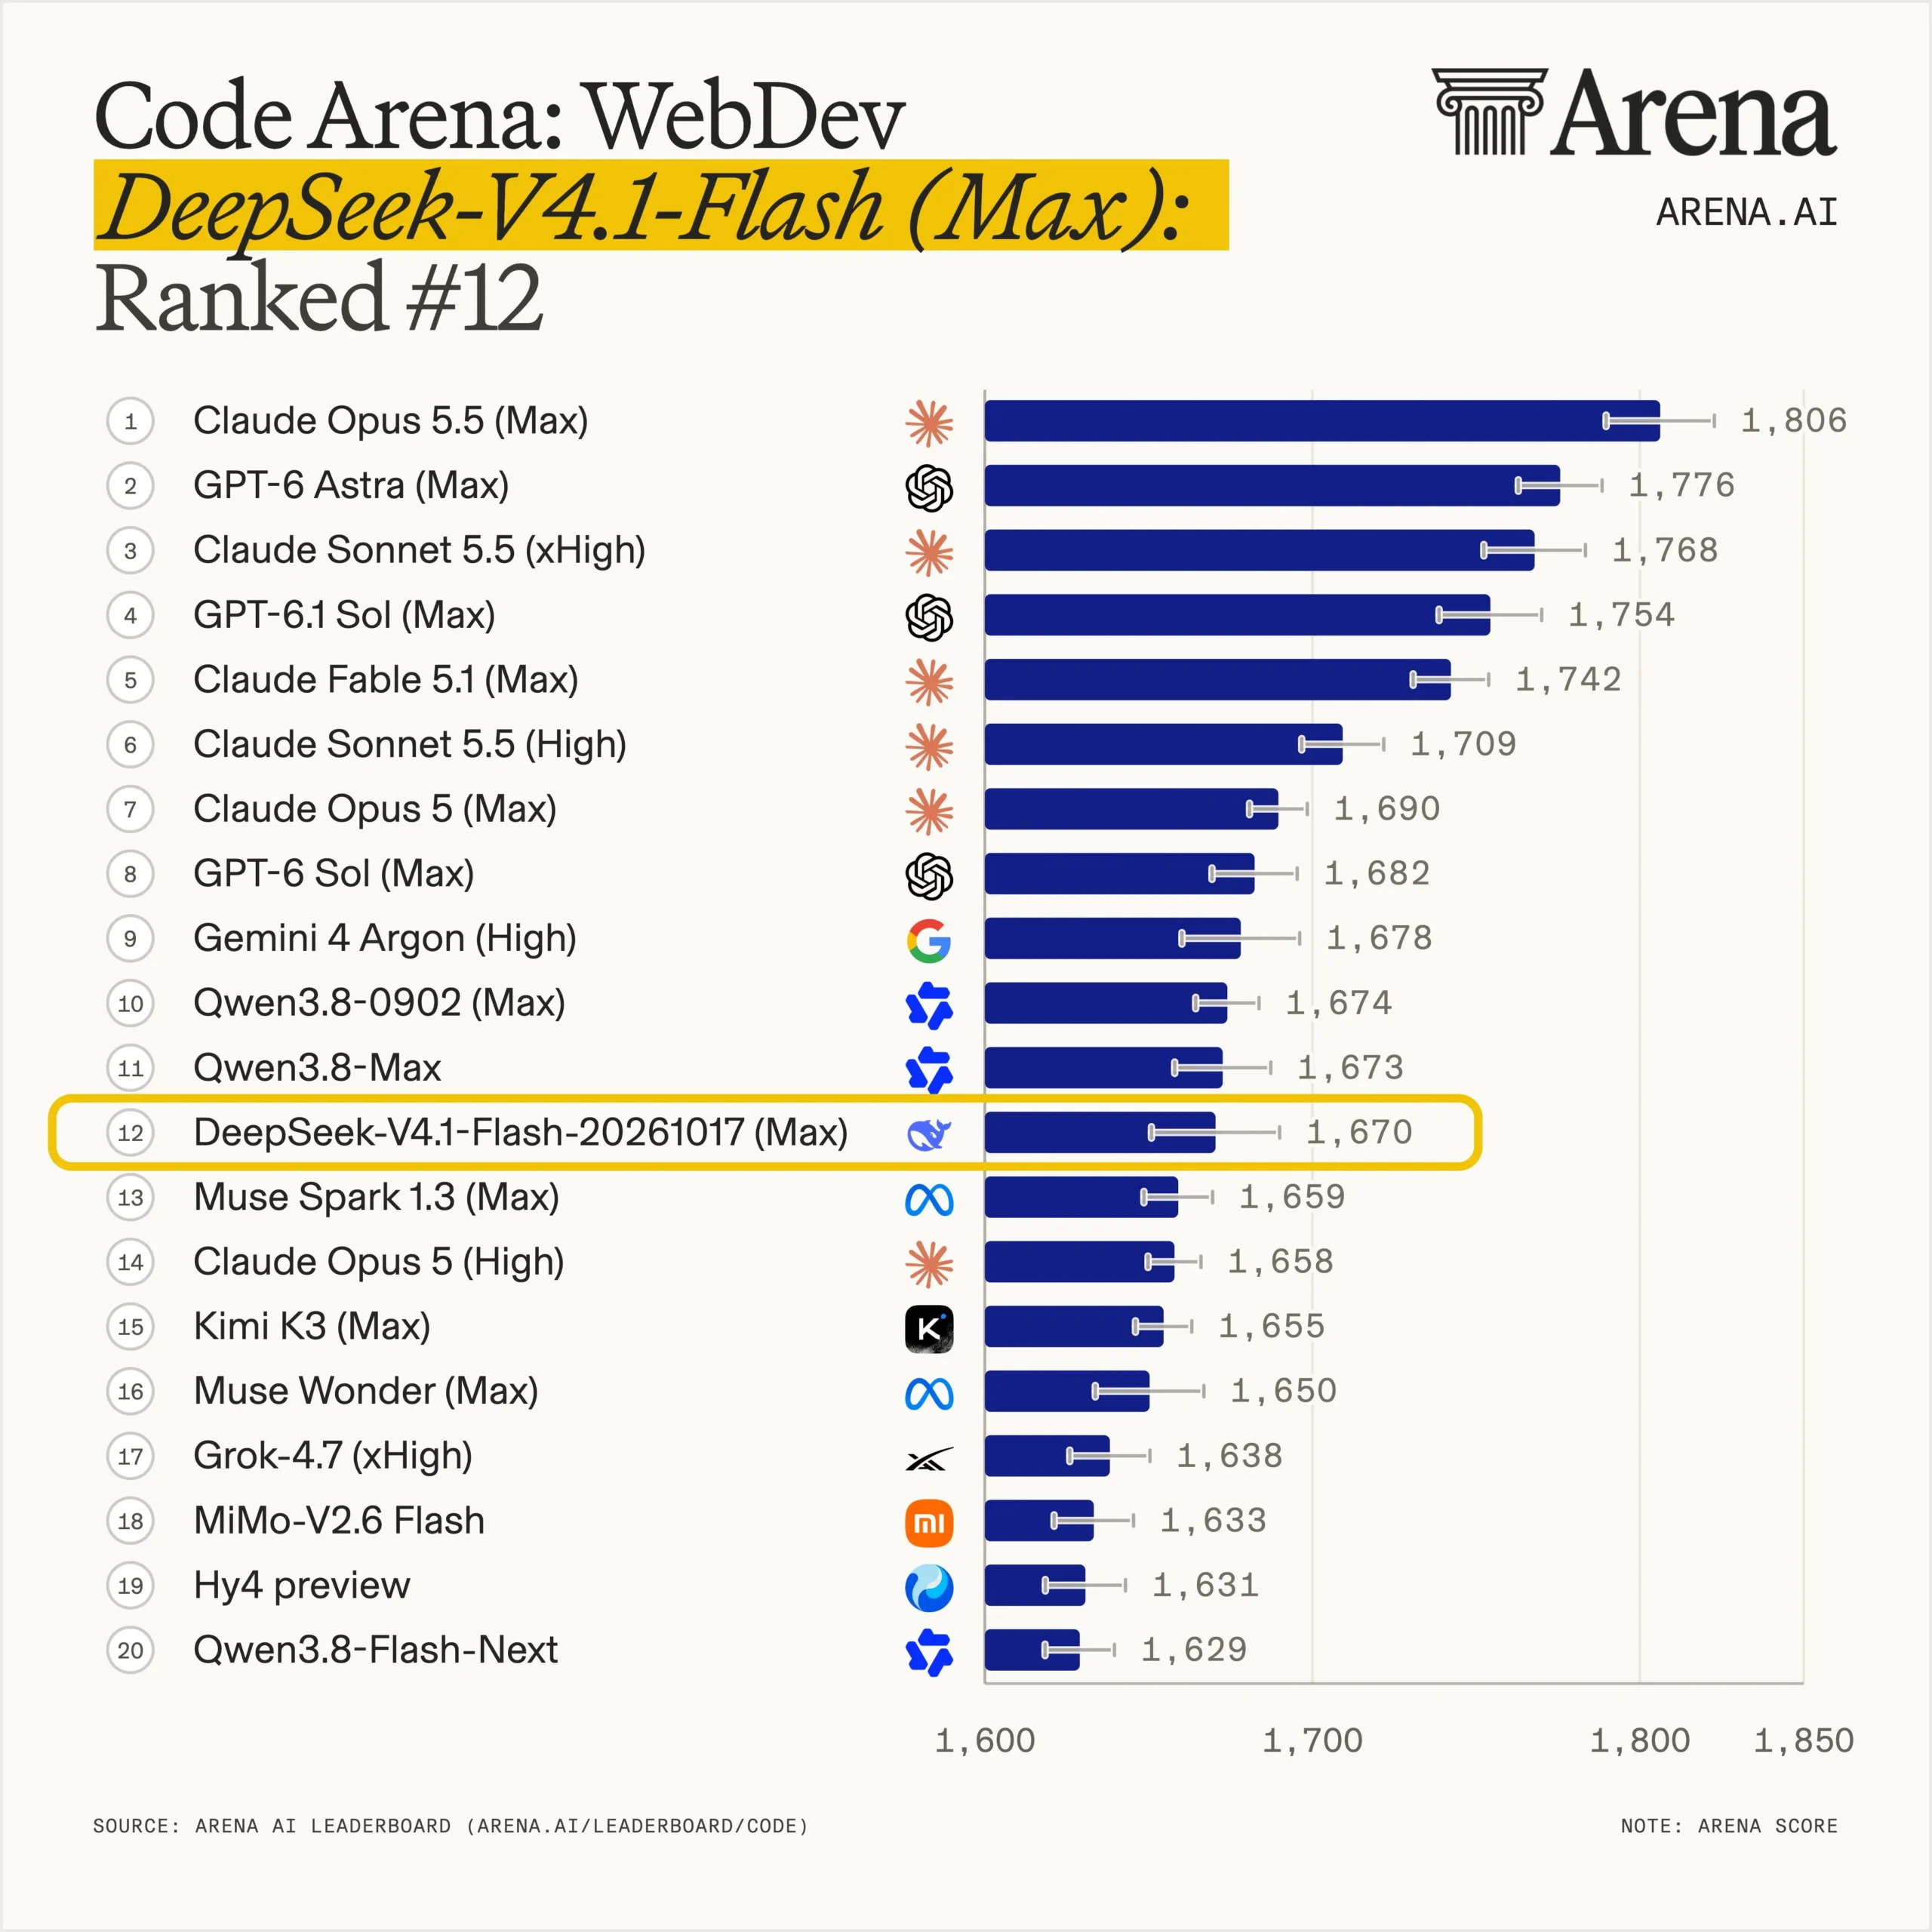
- 榜单成绩(官方口径):Code Arena: WebDev 总榜第 12 名、1670 分,开源模型中排第一,超过 Kimi K3(Max);分数领先 Claude Opus 5(High),与 GPT-6 Sol(Max)只差约 10 分;相比上一版 V4.1-Flash-20260910 提升了 52 分。
- 价格:每百万 token 输入 $0.3 / 输出 $1.2,约为 Kimi K3(Max)成本的十分之一。
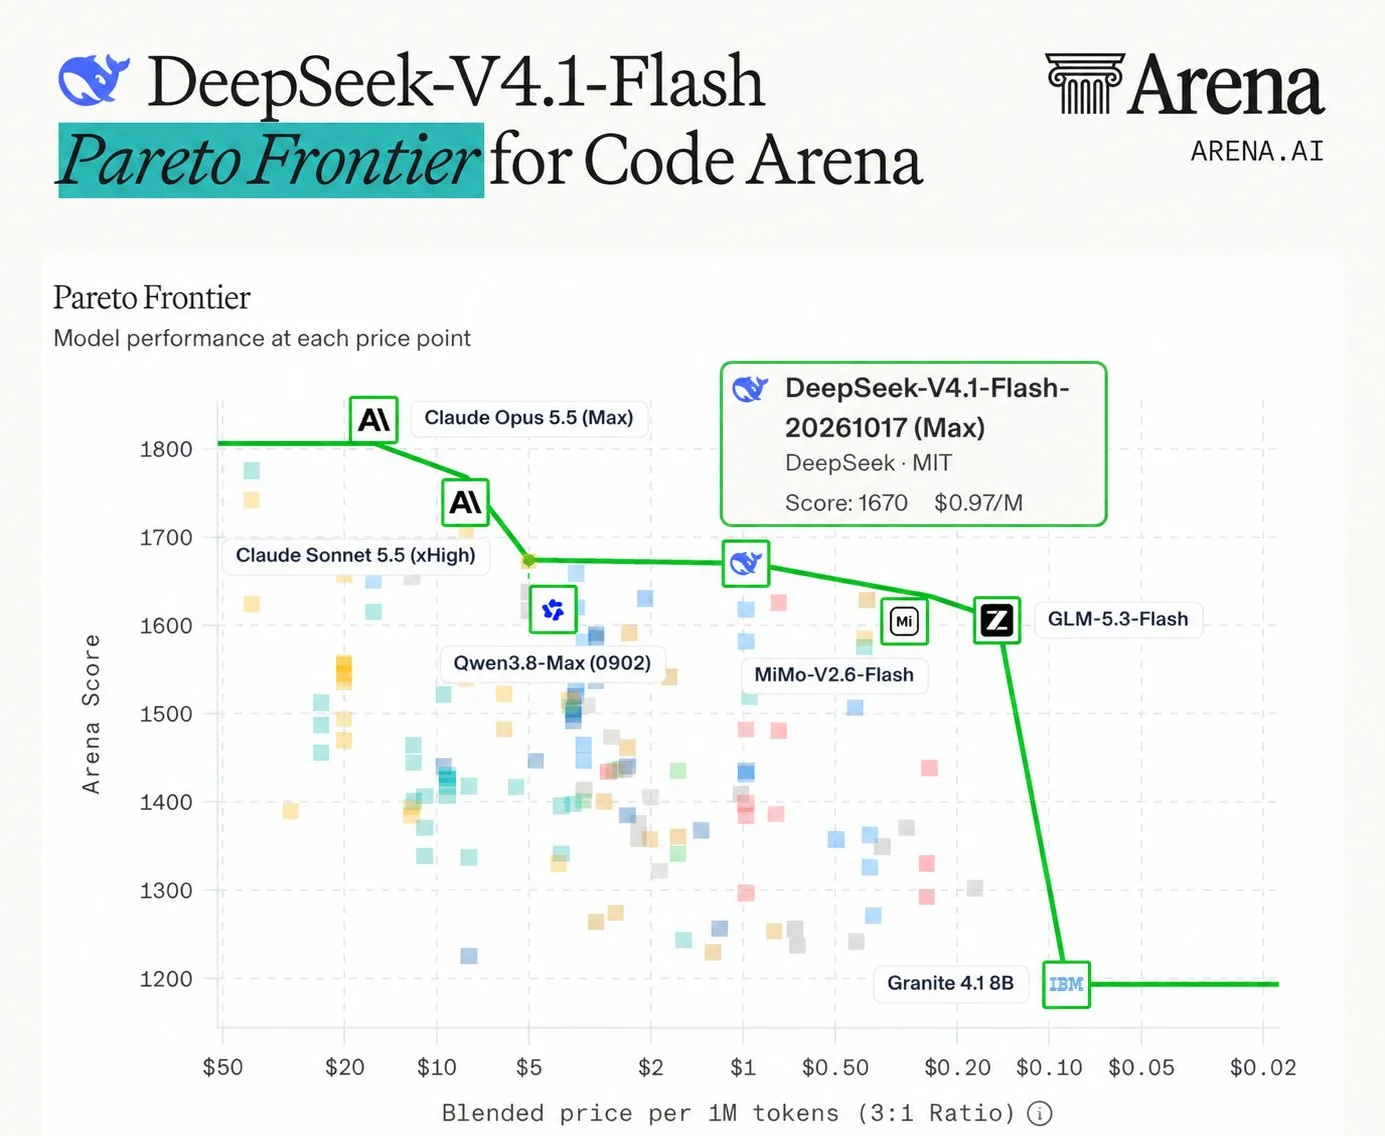
榜单和价格都是发布方口径,实际体验如何还要等真实场景跑一段时间,这里先如实转述,不替官方背书。
想本地跑?先算一笔硬件账
这是这篇里最该划重点的部分:
- 官方满血版总体积约 510GB;
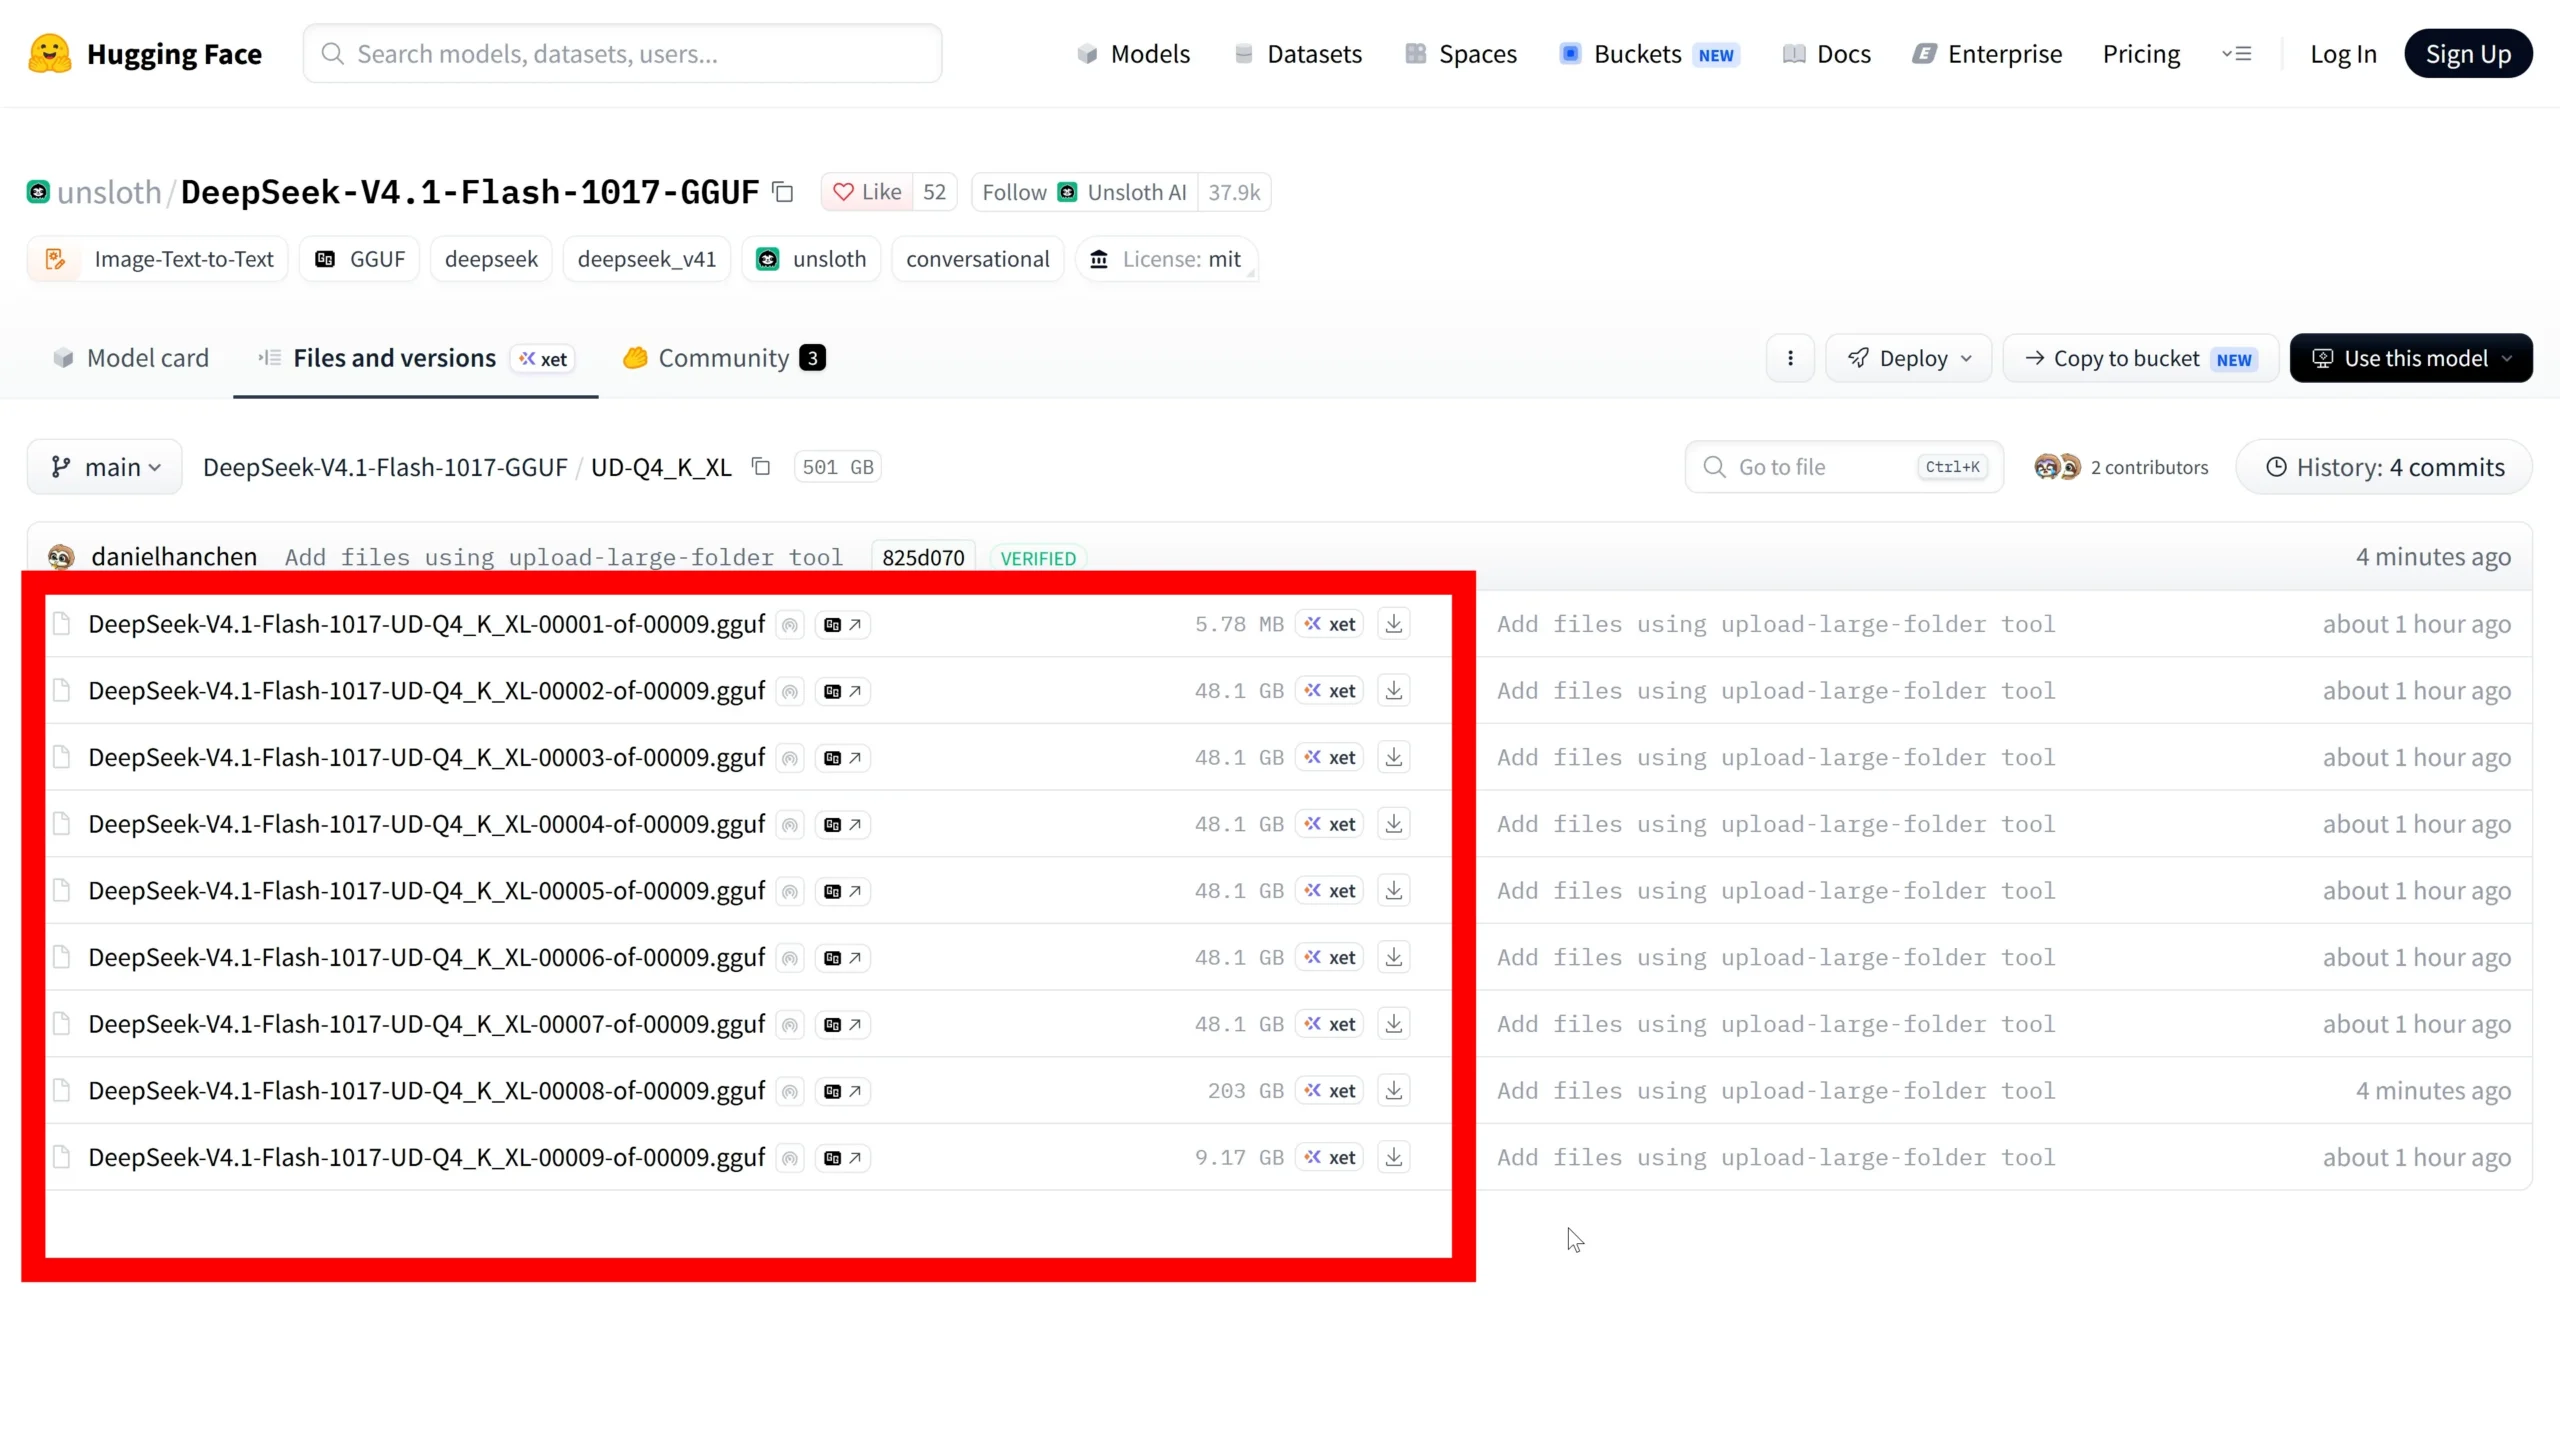
- 社区 GGUF 量化版(unsloth 出品)目前有 UD-Q4_K_XL 和 UD-Q8_K_XL 两档,体积约 501GB / 508GB——和原版几乎没差,量化省下的空间可以忽略;
- 也就是说,无论走哪条路线,显存加内存至少要准备 500GB 以上。显存不够可以拿内存硬扛,但以现在的内存行情,这条路同样不便宜。
结论很直白:这个版本"开源"更多是给有服务器资源的人和研究机构准备的,个人电脑本地部署基本不用考虑。
真有硬件,本地部署的路径是这样的
满足上面硬件条件的话,流程并不复杂,用 llama.cpp 就能加载(同样支持 vLLM):
- 从 llama.cpp 官方仓库 下载最新版本并解压;
- 在根目录新建
models文件夹,把模型的全部分卷文件(共 9 个)都放进去,缺一个都加载不了; - 运行启动脚本,程序会自动识别
models里的模型并加载; - 加载完成后,llama.cpp 会在本地起一个兼容 OpenAI 格式的 API 服务,默认地址
http://127.0.0.1:8080/v1,密码一栏随便填即可; - 想配个顺手的客户端,可以把这个本地 API 地址填进 DeepSeek Harness 桌面版里对接使用;用官方 API 的话同理,在 Harness 里填官方接口即可。